Ce que vous allez apprendre dans ce TP
- Installer Filbeat
- Identifier les fichiers et repertoires importants
- Utilisation des modules
- Utilisation avancée des labels
- Déployer un registre Harbor
- Importer une image dans un registre
- Rechercher des vulnérabilités sur une image
- Mettre en place la surcharge d'un fichier docker compose
- Utilisation avancée des labels (Mise en place dans le Projet 2)
Introduction #
Ce que vous allez apprendre dans cette section
- Installer Filbeat
- Identifier les fichiers et repertoires importants
- Utilisation des modules
- Utilisation avancée des labels
Nous allons procéder à l'installation de Filebeat en utilisant la technologie Docker.
Procédure
Vous devez fournir le lien pour retrouver toutes les procédures d'installation de Filbeat ainsi que celle pour l'installer sur un OS de type Linux.
Docker #
Nous allons procéder à l'installation de Filebeat sur Docker avec un fichier docker compose.
Les dossiers
Vous devez fournir la liste des dossiers nécessaire au bon fonctionnement de Filebeat en environnement DOocker.
Mode SWARM
Vous devez mettre en place le cluster Docker avec le mode SWARM activé. La machine 'manager' doit être le manager du cluster et les machines 'workerX' doivent être les workers du cluster. Comme les machines ont plusieurs IP, on va utiliser l'IP 192.168.56.2 comme adresse de gestion du plan de contrôle.RAPPEL : Sur toutes les machines créées par Vagrant il y a un dossier /vagrant qui correspond au montage du dossier dans lequel se trouve le fichier Vagrantfile: donc le contenu dossier 6_projet. Donc vous pouvez utiliser ce dossier pour partager des fichiers entre les machines. Par exemple, le fichier contenant les tokens pour joindre le cluster. Bien évidemment en Production, il faudra utiliser une solution plus sécurisée
Vous devez fournir la commande Docker qui va permettre de stocker dans le /vagrant/swarm-token-worker le token pour joindre le cluster comme worker.Réseau partagé
Vous devez créer les réseaux suivants- common-proxy: pour la communication entre les conteneurs via le proxy. Sera pleinement utilisé dans le TP suivant avec l'utilisation de Traefik.
- common-observability: pour la communication entre les conteneurs d'observabilité
Sous projet 1 #
Ce que vous allez apprendre dans cette sectionNous allons créer un registre docker avec Harbor sur la machine manager. Nous le ferons fonctionner sur le domaine registry.tp.elearning.rousseltm.fr. Pour ce premier projet, on va le déployer en HTTP sur le port 5000(port par défaut des registres Docker en HTTP).
- Déployer un registre Harbor
- Importer une image dans un registre
- Rechercher des vulnérabilités sur une image
- Mettre en place la surcharge d'un fichier docker compose
- Utilisation avancée des labels (Mise en place dans le Projet 2)
RAPPEL : Le site officiel de Harbor https://goharbor.io/ et vous pouvez revoir la vidéo de présentation de Harbor à cette adresse : Présentation et déploiement Harbor
Déploiement
Vous devez installer Harbor avec le service trivy sur le port 5000. Si tout est ok, vous devez pouvoir accéder depuis la machine hôte à Harbor à l'adressehttp://registry.tp.elearning.rousseltm.fr:5000INFORMATION : Dans le dossier 6_projet, vous avez un dossier nommé 'projects' dont le contenu sera automatiquement monté dans /opt/projects sur l'ensemble des VMs. Vous pouvez donc l'utiliser pour gérer vos fichiers pour les sous projets. Nous conseillons 1 dossier par sous projet.
Personnalisation
Le script install.sh à généré un fichier docker-compose.yml donc si on souhaite modifier des paramètres il faudra éditer ce fichier. Mais on va perdre toutes nos modifications à chaque exécution du script.
Vous devez proposer une solution pour éviter cela sachant qu'on souhaite que le conteneur 'proxy' se connecte au réseau 'common-proxy' et qu'il dispose du label dt.owner (Explication de ce label Dynatrace) avec comme valeur 'equipe1'. Dans la même lancée, ajouter un label pour dire à Filebeat de ne pas prendre en compte ses logs.
On va dans un premier temps déployer simplement avec 'docker compose' pour tester et dans un second temps sous forme de stack 'docker stack'.ATTENTION : La surcharge doit aussi être prise en compte par le script install.sh
Sous projet 2 #
Build image
Vous devez créer un Dockerfile pour construire une image pour l'application GO suivante qui sera nommée simple-app er aura le tag 1.0 :Ajout de l'image au registre Harbor
Vous devez envoyer cette image dans le projet(Explication sur la notion de projet dans Harbor) 'library' dans Harbor. On a fait le choix de 'library' car il s'agit du projet Public par défaut. Ainsi, l'image pourra être utilisée dans d'autres projets (Voir TP suivant). Pour rappel suite à votre installation, Harbor est disponible à l'adressehttp://registry.tp.elearning.rousseltm.fr:5000Scan de vulnérabilité
Vous devez scanner l'image importée pour vérifier ses vulnérabilités face aux failles CVE.
Déploiement Docker
La configuration à construire doit répondre à ces besoins :- Application 2-tier: go et redis
- Les services ne doivent s'exécuter que sur les workers. Cette configuration doit être externalisée pour permettre de la partager avec d'autres applications dans le même cas.
- Les services doivent utiliser les dernières versions (en production utiliser des versions fixes) des images officielles et l'application GO utiliser l'image construite précédemment et disponible sur Harbor.
- 1 instance de chaque service
- Le service GO doit exporter la variable d'environnement APP='APP1'
- Le service GO doit exporter la variable d'environnement TASK_SLOT dans laquelle vous devez y mettre le numéro de replica du conteneur (Les templates).
- Le service de l'application go doit rattaché au réseau 'common-proxy'
Répartition de charge
Vous devez vérifier que lorsque vous appelez l'URL de l'application (http://tp.elearning.rousseltm.fr) il retourne bien cette page et que les champs surlignés changent bien quand vous mettez à jour la page et bascule bien entre les deux conteneurs :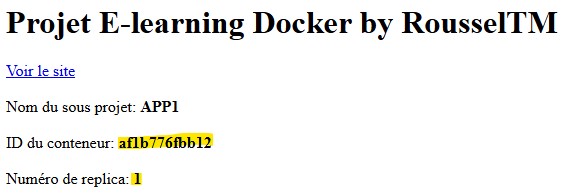
Sous projet 3 #
Sous projet observabilité constitué de Prometheus, de Grafana, de Node exporter et de cAdvisor. Ce sous projet est celui de l'observabilité et donc va nous permettre d'avoir une visibilité sur l'ensemble de notre projet.
Déploiement Docker
La configuration à construire doit répondre à ces besoins :- Rendre accessible Grafana sur le port 3000
- Rendre accessible Prometheus sur le port 9090
Configuration des services
La configuration à construire doit répondre à ces besoins :- Importer automatiquement dans Grafana la datasource Prometheus et Elasticsearch
- Importer les tableaux de bord avec l'ID : 609
- Collecter les métriques de Traefik
- Collecter les métriques de l'ensemble des noeuds du cluster
- Collecter les métriques de l'ensemble des conteneurs
Niveau de difficulté : ●●○○○ (2/5)
Glossaire de la formation
Observabilité
La capacité à connaître l'état interne d'un système à partir des données qu'il émet.Ces données sont classées en 3 piliers : logsmétriquestracesprofil...
Beats
Agents légers installés sur des serveurs pour collecter divers types de données (logs avec Filebeat, métriques avec Metricbeat) et les envoyer vers El...
Agent léger
Programme de collecte de données installé sur un système hôte, conçu pour consommer un minimum de ressources (CPU, RAM). Exemple : Filebeat, Promtail.
Agent lourd
Programme de collecte doté de nombreuses fonctionnalités locales (traitement, filtrage, mémoire tampon) consommant davantage de ressources système. Ex...
Access Log
Fichier de journalisation enregistrant les requêtes traitées par un serveur web (Apache, Nginx, Lighttpd, etc.). Il permet de tracer l'activité du ser...
Client IP
L'adresse IP de l'utilisateur effectuant la requête vers le serveur web. Lorsqu'un utilisateur passe par un Load Balancer ou un proxy (ex: Cloudflare)...
Timestamp
La date et l'heure exactes auxquelles la requête a été reçue par le serveur.Configuration : %t dans Apache, $time_local ou $time_iso8601 dans Nginx.
Request
La ligne de requête initiale du client. Elle comprend généralement la méthode HTTP (ex: GET), l'URL demandée et la version du protocole HTTP.Configura...
Status Code
Le code de statut HTTP final renvoyé par le serveur au client (ex : 200 pour un succès, 404 pour ressource non trouvée).Configuration : %>s dans Apach...
Size
Le volume des données renvoyées au client, mesuré en octets (généralement sans les en-têtes HTTP).Configuration : %b ou %O dans Apache, $body_bytes_se...
Referrer
L'URL de la page web depuis laquelle le client a cliqué ou suivi un lien pour accéder à la ressource actuelle.Configuration : %{Referer}i dans Apache,...
User-Agent
Les informations d'identification fournies par le client concernant son navigateur, son système d'exploitation et son appareil. Sa structure standard ...
Response Time
La durée totale prise par le serveur pour traiter la requête et renvoyer la réponse au client.Configuration : %D (microsecondes) ou %T (secondes) dans...
Articles recommandés
Comprendre la notion de score
Le concept de score va permettre à Elasticsearch de classer vos documents par pertinence lors d u...
Différences entre Technologies et Services dans Dynatrace
Dans Dynatrace, les concepts de 'Technologie' et de 'Services' aident à organiser et surveiller l...
OpenTelemetry : Instrumentation Automatique vs Manuelle
Comprenez les différences entre l'instrumentation automatique et manuelle avec OpenTelemetry, leu...
Dynatrace : Différences entre SQL Modifications, SQL Queries or Procedures, et SQL Transactions
Cet article détaille les différences entre trois concepts essentiels dans l'exécution des instruc...
Types de consommation de licence
Comprendre l'évolution de la facturation dans Dynatrace : la différence entre l'ancien modèle de ...
Les Types de Services Dynatrace : Comprendre et Optimiser Votre Surveillance Applicative
Découvrez les différents types de services que Dynatrace peut surveiller, leur rôle, et comment l...
Les SLO Dynatrace : Comprendre et Gérer les Objectifs de Niveau de Service
Découvrez comment utiliser les SLO (Service Level Objectives) dans Dynatrace pour définir et surv...
Apdex vs Core Web Vitals
Découvrez les différences entre Apdex et Core Web Vitals, deux indicateurs de performance essenti...
Comprendre Elastic Common Schema(ECS)
Comme toujours dans nos missions de conseil, nous recommandons aux entreprises d'uniformiser, de ...
Pourquoi collecter des métriques
Découvrez les raisons clés pour collecter des métriques avec des exemples concrets pour chaque cas.
Les types de métriques dans Prometheus
Découvrez en détail les quatre types de métriques supportés par Prometheus (Counter, Gauge, Histo...
Grail : Dynatrace Data Lakehouse
Désormais vous disposez dans Dynatrace (SaaS) d'un Data Lakehouse nommé Grail dont vous pouvez co...
Introduction à PromQL
Apprenez à maîtriser PromQL, le langage de requête utilisé dans Prometheus, avec des exemples et ...
Dynatrace OneAgent : tags, props, vars CLI
Pense‑bête des commandes CLI/API pour gérer tags, propriétés, variables d'environnement, versions...
Grafana Alloy : Collecte et Transformation de Télémétrie
Apprenez à utiliser Grafana Alloy pour collecter, transformer et acheminer logs, métriques et tra...
Grafana Alloy : Collecter les métriques système et les logs locaux
Découvrez comment configurer Grafana Alloy pour superviser le serveur sur lequel il s'exécute, av...
Grafana Alloy : L'importance de l'auto-supervision (Self-Monitoring)
Découvrez pourquoi et comment configurer Grafana Alloy pour qu'il se supervise lui-même, en colle...
Grafana Alloy : Comprendre et exploiter l'Interface Utilisateur (UI)
Découvrez comment activer, sécuriser et utiliser l'interface web intégrée de Grafana Alloy pour v...
OTLP expliqué : comprendre le protocole OpenTelemetry
Découvrez le protocole OTLP expliqué simplement. Comprendre les différences entre gRPC et HTTP po...
Grafana Alloy : Guide complet pour collecter métriques, logs et traces
Tutoriel complet sur Grafana Alloy. Découvrez comment installer, configurer et utiliser ce collec...
Grafana Alloy : Syntaxe et Configuration (Alloy Language : River)
Dans le cadre d'une formation Grafana ou formation observabilité, maîtrisez la syntaxe déclarativ...
Grafana Alloy : Collecte de Métriques (Prometheus & Ecosystem)
Apprenez à configurer Grafana Alloy pour collecter, transformer et envoyer des métriques en utili...
C'est quoi l'observabilité
La capacité à connaître l'état interne d'un système à partir des données que cette dernière émet...
Grafana Alloy : Gestion des Logs avec Loki
Découvrez comment configurer Grafana Alloy pour lire des fichiers de logs, journald ou des flux r...
Grafana Alloy : Gestion des Traces avec Tempo
Plongez dans le traitement des traces distribuées. Apprenez à ingérer des traces OTLP, Jaeger ou ...
Grafana Alloy : Profilage Continu avec Pyroscope
Découvrez comment configurer le profilage continu (Continuous Profiling) dans vos environnements ...
Grafana Alloy : Déploiement Avancé et Clustering
Maîtrisez le déploiement avancé de Grafana Alloy en mode clustering. Comprenez ses avantages pour...
Grafana Assistant : L'IA au service de l'observabilité
Découvrez Grafana Assistant, l'intelligence artificielle intégrée à Grafana Cloud. Apprenez comme...
Grafana Alloy vs OpenTelemetry Collector : Lequel choisir ?
Comparaison détaillée entre Grafana Alloy et l'OpenTelemetry Collector. Découvrez les avantages, ...
Grafana Alloy vs Dynatrace ActiveGate : Lequel choisir ?
Comparaison entre Grafana Alloy et Dynatrace ActiveGate. Comprenez les différences fondamentales ...
Grafana Alloy vs Grafana Agent vs Promtail : Lequel choisir ?
Découvrez l'évolution des collecteurs de télémétrie de l'écosystème Grafana. Comparatif détaillé ...
Référence des Composants Grafana Alloy
Un guide de référence complet sur tous les composants disponibles dans Grafana Alloy, organisé pa...
Dynatrace : Maîtriser les Entity Selectors pour une observabilité à grande échelle
Découvrez l'importance stratégique des Entity Selectors, maîtrisez leur syntaxe avancée, et adopt...
Dynatrace : Gestion du RGPD et protection de la vie privée (Data Privacy)
Apprenez à configurer Dynatrace pour respecter le RGPD, masquer les données sensibles et activer ...
Dynatrace Synthetic Monitoring : Guide complet et bonnes pratiques
Découvrez comment utiliser le Synthetic Monitoring de Dynatrace pour surveiller proactivement vos...
Dynatrace Credential Vault : Sécuriser et gérer vos secrets
Découvrez comment l'application Credential Vault de Dynatrace permet de gérer de manière sécurisé...
Les variantes du DevOps : Comprendre l'évolution de la culture de l'ingénierie
Découvrez les différentes déclinaisons du DevOps : DevSecOps, AIOps, NoOps, GitOps et FinOps. Com...
Dynatrace vs Datadog : Le duel des leaders de l'APM
Comparatif complet entre les deux géants de l'observabilité. Automatisation par IA contre flexibi...
Grafana vs Kibana : Quel outil de visualisation choisir ?
Découvrez les différences fondamentales entre Grafana, le roi des métriques multi-sources, et Kib...
Grafana Loki vs Elasticsearch : La bataille du stockage de logs
Comparatif entre Loki, le système de logs inspiré par Prometheus, et Elasticsearch, le moteur de ...
Prometheus vs VictoriaMetrics : Scalabilité des métriques
Pourquoi choisir VictoriaMetrics comme alternative à Prometheus pour le stockage à long terme et ...
OpenTelemetry vs Dynatrace OneAgent : Standard ouvert ou magie propriétaire ?
Comprenez la différence entre l'instrumentation manuelle standardisée d'OpenTelemetry et l'automa...
XLA : Pourquoi l'Expérience Utilisateur est le nouveau standard de l'Observabilité
Découvrez le concept de XLA (Experience Level Agreements), la différence avec les SLAs traditionn...
Dynatrace : Management Zones vs Segments
Comprenez les différences fondamentales entre les Management Zones et les Segments dans Dynatrace...
Exploiter l'API Dynatrace v2 : Guide Complet de l'Automatisation
Apprenez à utiliser l'API Dynatrace pour automatiser votre observabilité : gestion des scopes, ro...
Qu'est-ce que le Cloud Computing ? La définition du NIST
Comprenez les fondamentaux du Cloud Computing à travers les 5 caractéristiques essentielles défin...
IaaS, PaaS, SaaS : Comprendre les modèles de service
Découvrez les différences entre l'infrastructure, la plateforme et le logiciel en tant que service.
Le modèle de responsabilité partagée en sécurité
Apprenez qui est responsable de quoi en matière de sécurité dans le Cloud.
Élasticité vs Scalabilité : Les clés de la performance
Comprenez comment le cloud s'adapte automatiquement à la charge de vos utilisateurs.
Introduction au FinOps : Maîtriser sa facture Cloud
Comment passer du CapEx à l'OpEx tout en gardant le contrôle financier.
Le Serverless : L'informatique sans serveurs à gérer
Focus sur le Function as a Service (FaaS) et l'abstraction de l'infrastructure.
Edge Computing : Amener le Cloud au plus près des données
Découvrez pourquoi le traitement à la périphérie du réseau est essentiel pour l'IoT et la latence.
Qu'est-ce qu'une application Cloud Native ?
Comprendre les principes des microservices, des conteneurs et des APIs.
Les 6 Rs : Stratégies de migration vers le Cloud
Découvrez les différentes approches pour déplacer votre infrastructure on-premise vers le nuage.
Synthetic Monitoring as Code : Industrialisez la gestion des scénarios synthétiques
Découvrez comment intégrer le Synthetic Monitoring dans vos pipelines CI/CD pour des tests de per...
Grafana Provisioning : Automatisez la gestion de vos tableaux de bord et sources de données
Découvrez comment utiliser le provisioning de Grafana pour gérer vos configurations (dashboards, ...
Les Data Sources dans Grafana : Connectez et unifiez vos données
Apprenez à étendre les capacités de Grafana via les Data Sources. Découvrez les plugins essentiel...
Maîtriser les Transformations dans Grafana : Manipulez vos données avec agilité
Apprenez à utiliser les transformations Grafana pour reformater, calculer et combiner vos données...
Maîtriser les Variables dans Grafana : Dynamisez vos Tableaux de Bord
Apprenez à utiliser les variables pour créer des tableaux de bord interactifs et réutilisables. D...
Guide des Bonnes Pratiques Dynatrace : Vers une Observabilité Mature
Optimisez votre plateforme Dynatrace grâce à nos recommandations d'experts : automatisation du ta...
Les types de transactions dans les base de données
Cet article détaille les différences entre trois concepts essentiels dans l'exécution des instruc...
Bonnes Pratiques OpenTelemetry (OTel) : Le Guide de l'Observabilité Moderne
Maîtrisez OpenTelemetry grâce à nos conseils d'experts : implémentation du Collector, respect des...
Protection des Applications
Découvrez comment sécuriser vos backends contre les abus et les attaques courantes. Guide pratiqu...
Haute Disponibilité
Assurez la continuité de service de vos applications avec les stratégies de haute disponibilité. ...
Bonnes Pratiques Grafana Alloy : Optimiser sa Collecte de Télémétrie
Découvrez les règles d'or pour configurer Grafana Alloy de manière robuste : modularité, gestion ...
Architecture OpenTelemetry : Comprendre les 3 niveaux
Plongée au cœur de l'architecture OpenTelemetry. Apprenez comment les données circulent de l'appl...