Este artículo está disponible en francés.
1. OpenObserve en bref #
Une plateforme d'observabilité en un seul binaire.
Présentation #
OpenObserve est une plateforme d'observabilité open source écrite en Rust. Elle réunit dans un même produit les logs, métriques et traces, les tableaux de bord, les alertes et les pipelines de données. Sa particularité : elle stocke les données en colonnes au format Parquet, sur disque ou dans un stockage objet, sans index plein texte complet comme Elasticsearch. Le stockage y gagne beaucoup en coût ; l'éditeur annonce des écarts très importants, à vérifier sur vos propres données.
Un seul binaire suffit pour démarrer : pas de cluster à monter, pas de JVM. Lors de nos essais, un nœud local occupait environ 370 Mo de mémoire.
Open source ou Enterprise ? #
| Open source (AGPL-3.0) | Enterprise | |
|---|---|---|
| Logs, métriques, traces, tableaux de bord, alertes | Oui | Oui |
| Rétention configurable | Oui | Oui |
| Pipelines | Oui, destinations distantes en moins | Oui |
| Droits fins (rôles personnalisés) | Non | Oui |
| SSO, recherche fédérée, journal d’audit complet | Non | Oui |
À vérifier : la répartition et les conditions évoluent. L'éditeur propose aussi l'édition Enterprise gratuite en auto-hébergement sous un seuil d'ingestion quotidien : consultez la page officielle. Cette formation utilise l'édition open source.
2. L'architecture #
Du binaire unique au cluster.
Deux modes de déploiement #
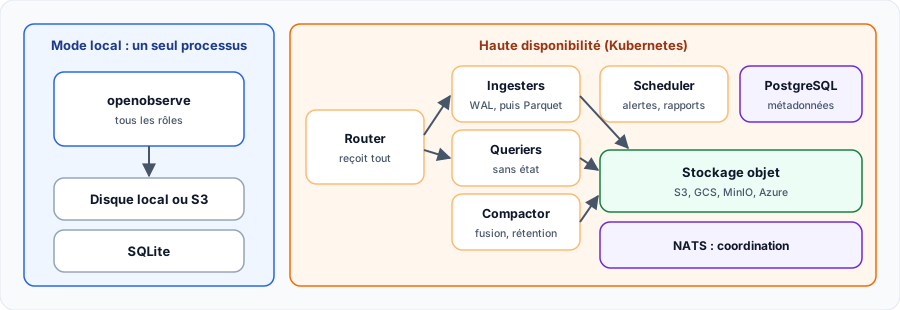
| Rôle | Fonction |
|---|---|
| Router | Reçoit les requêtes, les aiguille et sert l'interface |
| Ingester | Reçoit les données, écrit le WAL, produit le Parquet et l’envoie au stockage |
| Querier | Exécute les recherches ; sans état |
| Compactor | Fusionne les petits fichiers et applique la rétention |
| Scheduler | Exécute les alertes planifiées et les rapports |
En haute disponibilité, PostgreSQL conserve les métadonnées et NATS assure la coordination. Le disque local n'y est pas pris en charge.
Le trajet d'une donnée #
- L'ingester écrit l'événement dans un WAL et en mémoire.
- Les données sont converties périodiquement en fichiers Parquet locaux, déjà interrogeables.
- Ces fichiers partent vers le stockage objet.
- Le compactor fusionne les petits fichiers pour accélérer les recherches.
3. Les concepts #
Le vocabulaire à connaître.
Organisation, flux et schéma #
| Concept | Sens |
|---|---|
| Organisation | Espace isolé ; c'est le default des URL |
| Flux (stream) | Équivalent d'un index ; il a un type : logs, metrics ou traces |
| Schéma | Créé et enrichi automatiquement à l’ingestion |
_timestamp | Horodatage de chaque événement, en microsecondes |
OpenObserve face aux autres outils #
| Besoin | OpenObserve | Autre choix |
|---|---|---|
| Tout-en-un simple à déployer | Un binaire, trois signaux | SigNoz, ClickStack (ClickHouse) |
| Recherche plein texte très riche | Plus simple, SQL | Elasticsearch, OpenSearch |
| Écosystème Grafana | Interface propre, PromQL compatible | Loki, Mimir, Tempo |
Mi seguimiento
Inicia sesión para seguir tu progreso y tomar notas. Iniciar sesión
Artículos recomendados
Organiser le DevOps : flux de valeur, équipes et culture sans blâme
Mettre en place une organisation DevOps : chaîne de valeur et value stream mapping, Team Topologi...
Les concepts fondamentaux d'OpenTelemetry : signaux, ressources, contexte et maturité
Le vocabulaire indispensable d'OpenTelemetry : les quatre signaux, API et SDK, ressource et instr...
Datadog : la plateforme d'observabilité SaaS en un coup d'œil
Ce qu'est Datadog, ses produits (infrastructure, logs, APM, RUM, synthétiques, sécurité), ses con...
Ingérer des métriques dans VictoriaMetrics : scraping, vmagent et remote write
Toutes les façons d'alimenter VictoriaMetrics : remote write depuis Prometheus, scraping intégré,...
Mimir : le chemin de lecture (query-frontend, querier, store-gateway et caches)
Comment Mimir répond à une requête PromQL : découpage et cache du query-frontend, file d'attente,...
Data streams et templates Elasticsearch : component templates, index templates et séries temporelles
Gérer les données horodatées avec les data streams : index templates et component templates, conv...
ClickStack : ClickHouse, HyperDX et OpenTelemetry
La pile d'observabilité officielle de ClickHouse : installation tout-en-un, interface HyperDX (re...
Grafana Alloy : Collecte et Transformation de Télémétrie
Apprenez à utiliser Grafana Alloy pour collecter, transformer et acheminer logs, métriques et tra...
OTLP expliqué : comprendre le protocole OpenTelemetry
Découvrez le protocole OTLP expliqué simplement. Comprendre les différences entre gRPC et HTTP po...