Este artículo está disponible en francés.
1. Le cycle de vie avec ISM #
Automatiser rollover et suppression.
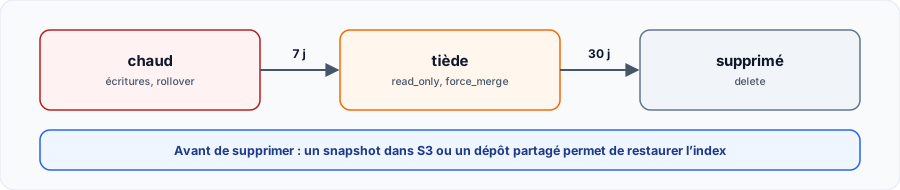
Une politique #
curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' -X PUT https://localhost:9200/_plugins/_ism/policies/cycle_logs -d '{
  "policy": {
    "description": "Rollover, lecture seule puis suppression",
    "default_state": "chaud",
    "states": [
      {"name": "chaud",
       "actions": [{"rollover": {"min_doc_count": 2}}],
       "transitions": [{"state_name": "tiede", "conditions": {"min_index_age": "7d"}}]},
      {"name": "tiede",
       "actions": [{"read_only": {}}, {"force_merge": {"max_num_segments": 1}}],
       "transitions": [{"state_name": "supprime", "conditions": {"min_index_age": "30d"}}]},
      {"name": "supprime", "actions": [{"delete": {}}], "transitions": []}
    ],
    "ism_template": [{"index_patterns": ["cycle-*"], "priority": 100}]
  }
}'
Le rollover a besoin d'un alias d'écriture et du réglage rollover_alias. Avec ism_template, tout nouvel index correspondant reçoit la politique automatiquement.
# Modèle : l'alias de rollover que la politique doit utiliser
curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' -X PUT https://localhost:9200/_index_template/cycle -d '{
  "index_patterns": ["cycle-*"],
  "template": {"settings": {
    "number_of_shards": 1, "number_of_replicas": 0,
    "plugins.index_state_management.rollover_alias": "cycle"
  }}
}'

# Premier index, avec l'alias d'écriture
curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' -X PUT https://localhost:9200/cycle-000001 -d '{"aliases":{"cycle":{"is_write_index":true}}}'

# Pour le TP seulement : vérifier les politiques toutes les minutes (5 par défaut)
curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' -X PUT https://localhost:9200/_cluster/settings \
  -d '{"persistent":{"plugins.index_state_management.job_interval":1}}'

# Écrire deux documents via l'alias
for i in 1 2; do
  curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' -X POST 'https://localhost:9200/cycle/_doc?refresh=true' -d "{\"n\":$i}"
done
curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' https://localhost:9200/_plugins/_ism/explain/cycle-000001
curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' 'https://localhost:9200/_cat/indices/cycle-*?v'Le rollover ne se fait pas tout de suite : les politiques sont vérifiées toutes les 5 minutes par défaut. En production, utilisez des seuils réalistes (min_size,min_index_age).
2. Les sauvegardes #
Snapshots et restauration.
Sauvegarder et restaurer #
Les répliques protègent d'une panne de nœud, pas d'une erreur humaine : seul le snapshot permet de revenir en arrière. Testé : index supprimé, restauré, 3 documents retrouvés.
curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' -X PUT https://localhost:9200/_snapshot/sauvegardes -d '{
  "type": "fs",
  "settings": {"location": "/usr/share/opensearch/data/snapshots"}
}'

curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' -X PUT 'https://localhost:9200/_snapshot/sauvegardes/snap1?wait_for_completion=true' \
  -d '{"indices":"logs-app-*"}'

# Perdre un index, puis le restaurer
curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' -X DELETE https://localhost:9200/logs-app-000001
curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' -X POST 'https://localhost:9200/_snapshot/sauvegardes/snap1/_restore?wait_for_completion=true' \
  -d '{"indices":"logs-app-000001"}'
curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' https://localhost:9200/logs-app-000001/_count
Le dépôtfsdoit être déclaré danspath.repo, et partagé entre tous les nœuds. Le TP le place dans le volume de données par simplicité : en production, utilisez S3 ou un stockage partagé distinct.
3. La sécurité #
Utilisateurs, rôles et certificats.
Un rôle en lecture seule #
curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' -X PUT https://localhost:9200/_plugins/_security/api/internalusers/lecteur \
  -d '{"password":"L3cteur!Passw0rd-26","backend_roles":[]}'

curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' -X PUT https://localhost:9200/_plugins/_security/api/roles/lecture_logs -d '{
  "cluster_permissions": ["cluster_composite_ops_ro"],
  "index_permissions": [{"index_patterns": ["logs-app-*"], "allowed_actions": ["read"]}]
}'

curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' -X PUT https://localhost:9200/_plugins/_security/api/rolesmapping/lecture_logs \
  -d '{"users":["lecteur"]}'

# Lecture : 200. Suppression : 403.
curl -sk -u 'lecteur:L3cteur!Passw0rd-26' -o /dev/null -w '%{http_code}\n' https://localhost:9200/logs-app-000001/_search
curl -sk -u 'lecteur:L3cteur!Passw0rd-26' -o /dev/null -w '%{http_code}\n' -X DELETE https://localhost:9200/logs-app-000001
Résultat constaté : 200 pour la lecture, 403 pour la suppression. Associez plutôt les rôles à votre annuaire (LDAP, SAML, OpenID) qu'à des comptes locaux.
Avant la production #
- Remplacez les certificats de démonstration et lancez avec
DISABLE_INSTALL_DEMO_CONFIG=true. - N'utilisez pas le compte
adminpour les applications. - Ne désactivez pas le plugin de sécurité, sauf sur une maquette isolée.
4. Bonnes pratiques #
Dimensionner et exploiter.
Dimensionnement #
- Taille des shards : entre 10 et 50 Go pour des logs. Trop de petits shards pèsent sur le cluster manager.
- Trois nœuds cluster manager dédiés sur un grand cluster, pour éviter le risque de partition (split brain).
- Tas de la JVM : la moitié de la RAM, 32 Go au maximum.
- Répliques : au moins une en production ; on peut en mettre zéro le temps d'un gros chargement initial.
Exploitation #
- Déclarez les types dans des modèles versionnés, et limitez le mapping dynamique.
- Surveillez l'état du cluster, le tas, le disque et les rejets d'écriture (
_cat/thread_pool). - Automatisez les snapshots, et testez leur restauration.
- Montez de version nœud par nœud, après lecture des notes de version.
Commandes à connaître #
curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' https://localhost:9200/_cat/health?v
curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' https://localhost:9200/_cat/nodes?v
curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' https://localhost:9200/_cat/indices?v
curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' 'https://localhost:9200/_cat/shards?v&h=index,shard,prirep,state,unassigned.reason'
curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' https://localhost:9200/_cluster/allocation/explain
curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' https://localhost:9200/_cat/thread_pool/write?v
curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' https://localhost:9200/_plugins/_ism/explain/logs-app-000001
Sources officielles #
Mi seguimiento
Inicia sesión para seguir tu progreso y tomar notas. Iniciar sesión
Artículos recomendados
Snapshot Lifecycle Management : sauvegardes automatisées, restauration et reprise après sinistre
Protéger les données Elasticsearch : dépôts de snapshots (S3, GCS, Azure, système de fichiers), p...
OpenSearch : concepts, architecture et différences avec Elasticsearch
Comprendre OpenSearch : origine du projet, licence, différences avec Elasticsearch, index, shards...
Indexer et chercher dans OpenSearch : mapping, DSL, PPL et SQL
Déclarer un modèle d'index, indexer avec bulk, chercher avec le Query DSL, agréger et interroger ...
OpenSearch Dashboards, alertes et observabilité
Explorer ses données dans OpenSearch Dashboards, créer des moniteurs d'alerte et découvrir Trace ...
Installer OpenSearch et OpenSearch Dashboards
Installer OpenSearch avec Docker Compose ou l'archive : mot de passe initial, vm.max_map_count, c...
Alimenter OpenSearch : pipelines d'ingestion et Data Prepper
Transformer les données avec les pipelines d'ingestion, collecter avec Data Prepper, recevoir l'O...
Bonnes pratiques Elasticsearch : mappings, shards, cycle de vie et exploitation
Bonnes pratiques Elasticsearch : dimensionnement des shards, mappings explicites, templates, ILM,...
Architecture distribuée Elasticsearch : rôles des nœuds, shards, répliques et allocation
Comprendre le fonctionnement distribué d'Elasticsearch : rôles des nœuds, nœuds master et quorum,...
Index Lifecycle Management (ILM) : data tiers, rollover et rétention
Automatiser le cycle de vie des index avec ILM : data tiers hot, warm, cold et frozen, rollover p...