Este artículo está disponible en francés.
1. Pourquoi des recording rules ? #
Calculer à l'avance plutôt qu'à chaque lecture.
Le problème #
Une requête PromQL est calculée au moment où on la lance. Sur un tableau de bord de vingt panneaux, actualisé toutes les trente secondes et ouvert par dix personnes, Prometheus refait sans cesse les mêmes calculs sur les mêmes échantillons. Le tableau de bord devient lent, et chaque utilisateur supplémentaire aggrave la situation.
Une recording rule (règle d'enregistrement) résout ce problème : Prometheus évalue l'expression à intervalle régulier et écrit le résultat dans une nouvelle série. Les lectures deviennent de simples accès à cette série.
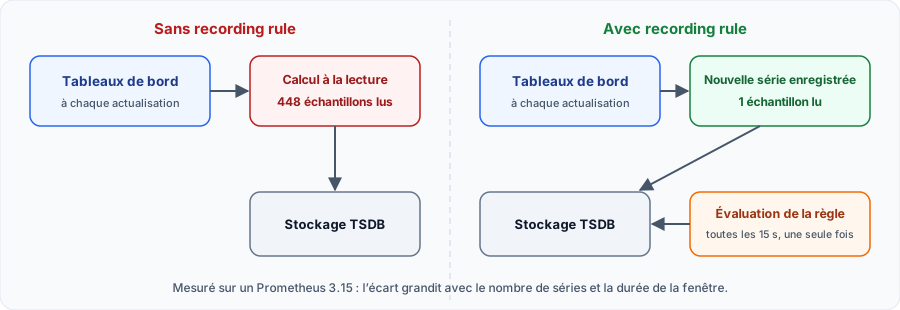
Mesure réelle : sur un Prometheus 3.15 de test, avecstats=all,sum by (job) (rate(prometheus_http_requests_total[5m]))lit 448 échantillons, et la série enregistrée équivalente un seul. L'écart est bien plus grand sur un serveur de production.
Quand en utiliser, et quand s'en passer #
| Bonne idée | Mauvaise idée |
|---|---|
| Requête coûteuse et fréquente (tableau de bord très consulté) | Requête lancée rarement, à la main |
| Alerte dont l’expression est lourde | Requête déjà rapide sur peu de séries |
| Indicateur partagé (SLI, taux d’erreur) à définir une seule fois | Conserver toutes les étiquettes d’origine : on ne réduit rien |
| Agrégats à conserver longtemps ou à fédérer | Remplacer une exploration : la fenêtre (5m) est figée |
Une règle n'est pas gratuite : chaque série enregistrée consomme du stockage et de la mémoire, comme une série collectée. Le gain vient de l'agrégation : remplacer des milliers de séries par quelques dizaines.
2. Comment Prometheus les évalue #
Groupes, intervalle, ordre et absence d'effet rétroactif.
Le fonctionnement #
- Les règles sont rangées dans des groupes, déclarés dans des fichiers référencés par
rule_files. - Dans un groupe, elles s'exécutent dans l'ordre, au même horodatage. Une règle peut donc utiliser le résultat de celle qui la précède.
- L'intervalle est celui du groupe (
interval), sinon leevaluation_intervalglobal. - Le résultat garde les étiquettes de l'expression ; le nom de la métrique est remplacé par
record. - Une règle ne calcule que le présent : une nouvelle règle n'a pas d'historique, sauf recalcul manuel (voir plus loin).
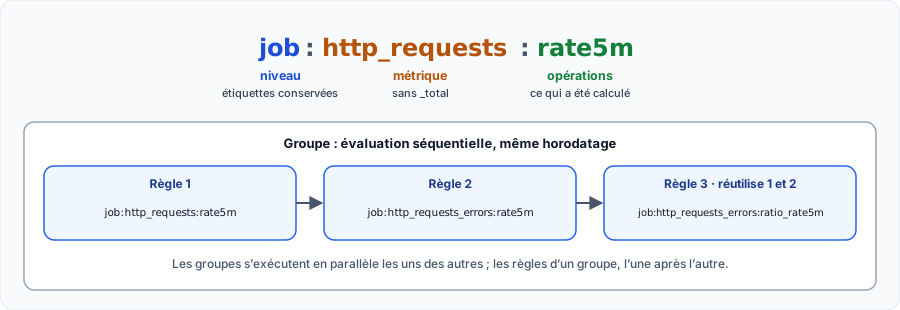
Attention à l'intervalle : une série qui n'a pas de point depuis plus de cinq minutes (le délai de recherche par défaut) n'apparaît plus dans les requêtes instantanées. Un groupe évalué toutes les dix minutes produit donc des trous.
Mi seguimiento
Inicia sesión para seguir tu progreso y tomar notas. Iniciar sesión
Glossaire de la formation
Observabilidad
La capacidad de conocer el estado interno de un sistema a partir de los datos que emite.Estos datos se clasifican en 3 pilares: logs (registros)métric...
Métricas
Medidas numéricas recopiladas a intervalos regulares (ej: CPU, RAM, tiempo de respuesta) utilizadas para evaluar el estado de salud general de un sist...
Alerting (Alertas)
Proceso que consiste en notificar a los equipos (vía email, Slack, Teams) cuando se detecta un evento específico, un umbral superado o una anomalía.
Arquitectura
Diseño global y estructural de un sistema informático, definiendo sus diferentes componentes, sus relaciones y los principios que guían su evolución.
OpenTelemetry
Framework de código abierto que proporciona estándares, APIs y SDKs para recopilar y exportar datos de observabilidad (trazas, métricas, logs) de mane...
Artículos recomendados
Prometheus sur Kubernetes et l'interface web de Prometheus
Déployer Prometheus sur Kubernetes avec kube-prometheus-stack (Prometheus Operator, ServiceMonito...
Prometheus : visualiser ses métriques (UI, Grafana et dashboards)
Visualiser les données Prometheus : interface web, graphes PromQL, connexion à Grafana, dashboard...
Les types de métriques dans Prometheus
Découvrez en détail les quatre types de métriques supportés par Prometheus (Counter, Gauge, Histo...
Prometheus dans le monde Kubernetes (Operator, ServiceMonitor, kube-prometheus-stack)
Superviser Kubernetes avec Prometheus : service discovery, kube-prometheus-stack, Prometheus Oper...
Métriques Dynatrace : Data Explorer, sélecteurs de métriques, API et tableaux de bord
Exploiter les métriques dans Dynatrace : métriques intégrées et personnalisées, Data Explorer, sy...
Observabilité sur Azure : Azure Monitor, Log Analytics, Application Insights, Prometheus et Grafana managés
Panorama complet de l'observabilité sur Azure : Azure Monitor (métriques, journaux et Log Analyti...
Maîtriser les Variables dans Grafana : Dynamisez vos Tableaux de Bord
Apprenez à utiliser les variables pour créer des tableaux de bord interactifs et réutilisables. D...
Grafana Provisioning : Automatisez la gestion de vos tableaux de bord et sources de données
Découvrez comment utiliser le provisioning de Grafana pour gérer vos configurations (dashboards, ...
Grafana : maîtriser les requêtes (PromQL, LogQL, SQL et expressions)
Construire des requêtes efficaces dans Grafana : éditeur de requêtes, Query Inspector, PromQL, Lo...