1. Concevoir de bonnes métriques #
Nommage et labels.
Conventions #
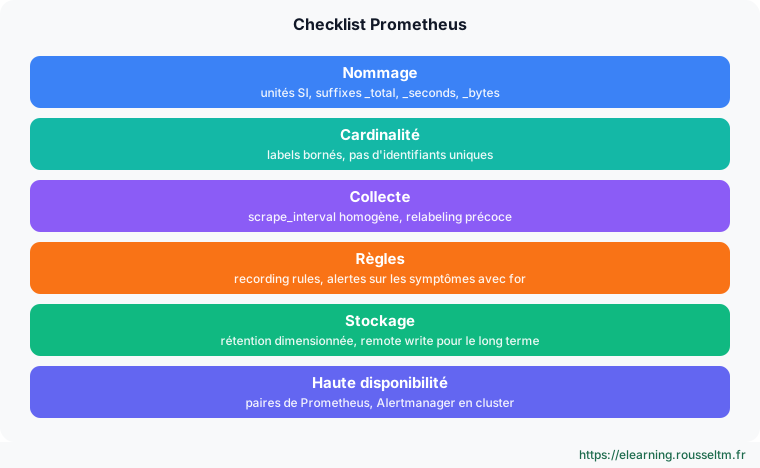
| Règle | Exemple correct | Exemple à éviter |
|---|---|---|
| Unités de base | http_request_duration_seconds | request_time_ms |
Compteurs en _total | http_requests_total | http_requests_count |
| Préfixe d'application | shop_orders_created_total | orders |
| Un nom, plusieurs labels | http_requests_total{method="GET"} | http_get_requests_total |
| Labels à faible cardinalité | status="500", route="/orders" | user_id="4821", url="/orders/9921" |
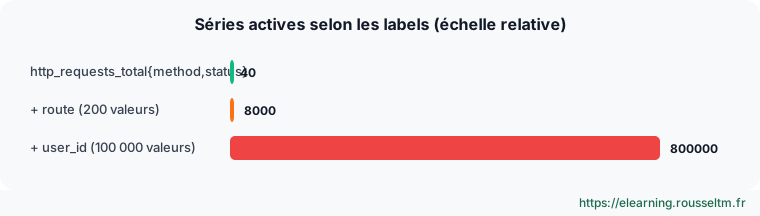
Erreur Courante : Chaque combinaison unique de labels est une série temporelle stockée en mémoire. Un label commeuser_idourequest_idpeut multiplier le nombre de séries par des millions.
Détecter les problèmes de cardinalité #
# Séries les plus nombreuses par métrique
topk(10, count by (__name__) ({__name__=~".+"}))
prometheus_tsdb_head_series
rate(prometheus_tsdb_head_series_created_total[1h])

curl -s localhost:9090/api/v1/status/tsdb | jq '.data.seriesCountByMetricName[:5]'
promtool tsdb analyze /prometheus | head -40
2. Collecte et règles #
Scrape, relabeling et recording rules.
prometheus.yml #
global:
  scrape_interval: 30s          # un seul intervalle commun ; 15 s si nécessaire
  evaluation_interval: 30s
  external_labels: { cluster: prod-eu, replica: A }
scrape_configs:
  - job_name: api
    scrape_timeout: 10s
    sample_limit: 20000                       # protège contre une explosion de séries
    label_limit: 30
    static_configs: [{ targets: ["api-1:8080", "api-2:8080"] }]
    metric_relabel_configs:
      - { source_labels: [__name__], regex: "go_gc_.*|go_memstats_.*", action: drop }   # supprimer le bruit à la source
      - { regex: "session_id", action: labeldrop }
Recording rules #
groups:
  - name: api.rules
    interval: 30s
    rules:
      - record: job:http_requests:rate5m
        expr: sum by (job) (rate(http_requests_total[5m]))
      - record: job:http_errors:ratio_rate5m
        expr: sum by (job) (rate(http_requests_total{status=~"5.."}[5m])) / sum by (job) (rate(http_requests_total[5m]))
promtool check config prometheus.yml && promtool check rules rules/*.yml
curl -s localhost:8080/metrics | promtool check metrics # linter de métriques (nommage)
promtool test rules tests/*.yml3. Alertes utiles #
Symptômes plutôt que causes.
Règles d'or #
- Alertez sur ce que l'utilisateur ressent (erreurs, latence, saturation) plutôt que sur chaque cause (CPU à 80 %).
- Utilisez
for:pour éviter les alertes sur des pics brefs ; ajoutez une description et un lien vers un runbook. - Chaque alerte doit déclencher une action : sinon, supprimez-la ou transformez-la en tableau de bord.
- alert: ApiHighErrorRate
  expr: job:http_errors:ratio_rate5m{job="api"} > 0.05
  for: 10m
  labels: { severity: critical, team: backend }
  annotations:
    summary: "Plus de 5 % d'erreurs sur {{ $labels.job }}"
    runbook_url: https://wiki.exemple.fr/runbooks/api-errors
- alert: Watchdog
  expr: vector(1)                          # doit toujours être active : vérifie la chaîne d'alerte
4. Stockage, haute disponibilité et sécurité #
Exploiter durablement.
Dimensionnement et HA #
# espace ≈ rétention (s) × échantillons/s × ~1,5 octet
rate(prometheus_tsdb_head_samples_appended_total[2h])
prometheus --storage.tsdb.retention.time=30d --storage.tsdb.retention.size=200GB --storage.tsdb.wal-compression
du -sh /prometheus; curl -s localhost:9090/api/v1/status/runtimeinfo | jq '.data.storageRetention'- HA : deux Prometheus identiques (label
replicadifférent) + Alertmanager en cluster ; déduplication avec Thanos/Mimir. - Long terme :
remote_writevers Mimir, Thanos Receive ou VictoriaMetrics ; rétention locale courte. - Sécurité : TLS et authentification basique via
--web.config.file, API admin désactivée si inutile.
# web.yml
tls_server_config: { cert_file: /etc/prometheus/tls.crt, key_file: /etc/prometheus/tls.key }
basic_auth_users: { admin: "$2y$10$..." }
prometheus --web.config.file=/etc/prometheus/web.yml
Schéma de référence et vérification rapide #
Visualiser le principe et le contrôler en ligne de commande.
Schéma de référence #
topk(10, count by (__name__) ({__name__=~".+"}))