1. Pourquoi des recording rules ? #
Calculer à l'avance plutôt qu'à chaque lecture.
Le problème #
Une requête PromQL est calculée au moment où on la lance. Sur un tableau de bord de vingt panneaux, actualisé toutes les trente secondes et ouvert par dix personnes, Prometheus refait sans cesse les mêmes calculs sur les mêmes échantillons. Le tableau de bord devient lent, et chaque utilisateur supplémentaire aggrave la situation.
Une recording rule (règle d'enregistrement) résout ce problème : Prometheus évalue l'expression à intervalle régulier et écrit le résultat dans une nouvelle série. Les lectures deviennent de simples accès à cette série.
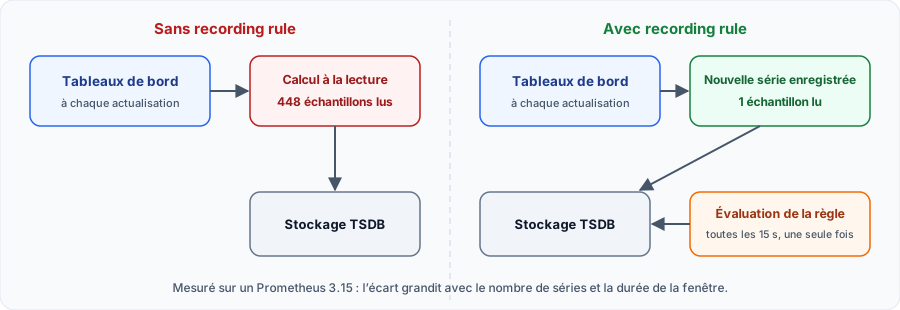
Mesure réelle : sur un Prometheus 3.15 de test, avecstats=all,sum by (job) (rate(prometheus_http_requests_total[5m]))lit 448 échantillons, et la série enregistrée équivalente un seul. L'écart est bien plus grand sur un serveur de production.
Quand en utiliser, et quand s'en passer #
| Bonne idée | Mauvaise idée |
|---|---|
| Requête coûteuse et fréquente (tableau de bord très consulté) | Requête lancée rarement, à la main |
| Alerte dont l’expression est lourde | Requête déjà rapide sur peu de séries |
| Indicateur partagé (SLI, taux d’erreur) à définir une seule fois | Conserver toutes les étiquettes d’origine : on ne réduit rien |
| Agrégats à conserver longtemps ou à fédérer | Remplacer une exploration : la fenêtre (5m) est figée |
Une règle n'est pas gratuite : chaque série enregistrée consomme du stockage et de la mémoire, comme une série collectée. Le gain vient de l'agrégation : remplacer des milliers de séries par quelques dizaines.
2. Comment Prometheus les évalue #
Groupes, intervalle, ordre et absence d'effet rétroactif.
Le fonctionnement #
- Les règles sont rangées dans des groupes, déclarés dans des fichiers référencés par
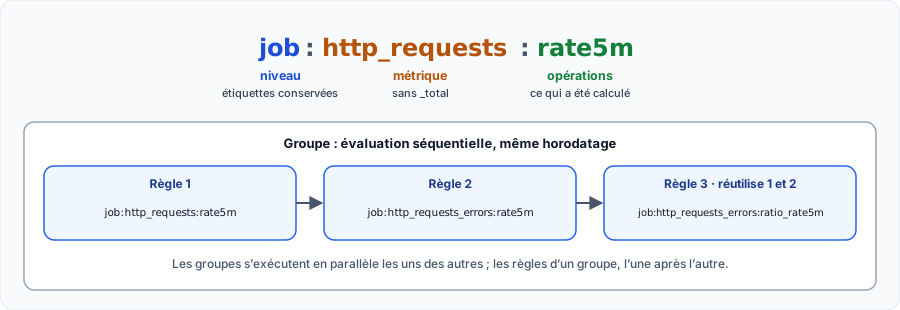
rule_files. - Dans un groupe, elles s'exécutent dans l'ordre, au même horodatage. Une règle peut donc utiliser le résultat de celle qui la précède.
- L'intervalle est celui du groupe (
interval), sinon leevaluation_intervalglobal. - Le résultat garde les étiquettes de l'expression ; le nom de la métrique est remplacé par
record. - Une règle ne calcule que le présent : une nouvelle règle n'a pas d'historique, sauf recalcul manuel (voir plus loin).
Attention à l'intervalle : une série qui n'a pas de point depuis plus de cinq minutes (le délai de recherche par défaut) n'apparaît plus dans les requêtes instantanées. Un groupe évalué toutes les dix minutes produit donc des trous.
3. Écrire ses premières règles #
La syntaxe, un exemple complet et les options du groupe.
Un fichier de règles #
Déclarez le fichier dans prometheus.yml, puis écrivez les règles. Ces exemples portent sur les métriques de Prometheus lui-même, pour pouvoir les essayer immédiatement :
global:
  scrape_interval: 5s
  evaluation_interval: 15s

rule_files:
  - /etc/prometheus/rules.yml

scrape_configs:
  - job_name: prometheus
    static_configs:
      - targets: ["localhost:9090"]
groups:
- name: http_prometheus
rules:
- record: job_handler:prometheus_http_requests:rate5m
expr: sum by (job, handler) (rate(prometheus_http_requests_total[5m]))
- record: job:prometheus_http_requests:rate5m
expr: sum by (job) (job_handler:prometheus_http_requests:rate5m)
- record: job:prometheus_http_requests_errors:rate5m
expr: sum by (job) (rate(prometheus_http_requests_total{code=~"5.."}[5m]))
- record: job:prometheus_http_requests_errors:ratio_rate5m
expr: |
(job:prometheus_http_requests_errors:rate5m or job:prometheus_http_requests:rate5m * 0)
/ job:prometheus_http_requests:rate5m
- record: job:prometheus_http_request_duration_seconds:p95_rate5m
expr: |
histogram_quantile(0.95,
sum by (job, le) (rate(prometheus_http_request_duration_seconds_bucket[5m])))Dans Grafana, la requête devient très simple :
# Avant : recalculé à chaque actualisation de chaque panneau
sum by (job) (rate(http_requests_total[5m]))

# Après : simple lecture de la série enregistrée
job:http_requests:rate5m
Les options d'un groupe #
groups:
  - name: agregats_http
    interval: 30s        # sinon : evaluation_interval du fichier global
    query_offset: 30s    # évalue un peu dans le passé, si les données arrivent en retard
    limit: 1000          # échec de la règle si elle produit plus de 1000 séries
    labels:
      equipe: plateforme # ajouté à toutes les règles du groupe
    rules:
      - record: job:http_requests:rate5m
        expr: sum by (job) (rate(http_requests_total[5m]))
4. Bien nommer ses règles #
La convention niveau:métrique:opérations.
La convention officielle #
La documentation de Prometheus recommande le format niveau:métrique:opérations. Le nom dit ainsi ce que contient la série, sans ouvrir le fichier de règles. Les deux-points sont réservés à cet usage : les exporteurs ne doivent pas en utiliser.
| Partie | Sens | Exemple |
|---|---|---|
| niveau | Étiquettes conservées par l’agrégation | job, instance_path |
| métrique | Nom d’origine, sans le suffixe _total après un rate | http_requests |
| opérations | Opérations appliquées, la plus récente en premier | rate5m, ratio_rate5m, p95_rate5m |
5. Les pièges à éviter #
Ratios, séries absentes, ordre des opérations.
Ne jamais faire la moyenne de ratios #
Un service à 10 requêtes par seconde avec 50 % d'erreurs et un autre à 1000 requêtes par seconde avec 0 % n'ont pas 25 % d'erreurs en moyenne, mais environ 0,5 %. Enregistrez donc le numérateur et le dénominateur, puis divisez leurs sommes :
# Faux : moyenne de ratios, un petit service pèse autant qu'un gros
avg by (job) (instance:http_requests_errors:ratio_rate5m)

# Juste : on agrège le numérateur et le dénominateur séparément
sum by (job) (instance:http_requests_errors:rate5m)
  / sum by (job) (instance:http_requests:rate5m)
Le ratio qui disparaît quand tout va bien #
C'est le piège le plus sournois, constaté en préparant ce chapitre. Si aucune série 5xx n'existe, le filtre ne renvoie rien, et une division par un résultat vide donne un résultat vide, pas 0. Le tableau de bord affiche « No data » : impossible alors de distinguer « aucune erreur » d'une panne de la collecte.
# Vide tant qu'aucune erreur 5xx n'a été observée
job:requests_errors:rate5m / job:requests:rate5m

# Vaut 0 quand il n'y a aucune erreur
(job:requests_errors:rate5m or job:requests:rate5m * 0) / job:requests:rate5m
Les autres erreurs fréquentes #
rated'abord,sumensuite :sum(rate(x[5m])). Additionner des compteurs avant leratefausse la détection de leurs remises à zéro.- Histogrammes : gardez l'étiquette
ledans lesum by, sinonhistogram_quantilene peut rien calculer. - Trop d'étiquettes : une règle qui conserve
instanceoupodgarde presque toute la cardinalité. - Changer une règle : si l'expression change de sens, changez aussi le nom : sinon l'ancienne et la nouvelle logique se mélangent dans la même série.
6. Tester ses règles avec promtool #
Vérification et tests unitaires, avant de déployer.
Des tests unitaires, sans serveur #
promtool check rules vérifie la syntaxe. promtool test rules va plus loin : il injecte des séries fictives, évalue les règles et compare le résultat. Le test ci-dessous couvre les deux cas du piège précédent :
rule_files:
  - rules.yml
evaluation_interval: 1m

tests:
  - name: 10 % d'erreurs
    interval: 1m
    input_series:
      - series: 'prometheus_http_requests_total{job="api",handler="/a",code="200"}'
        values: '0+54x10'
      - series: 'prometheus_http_requests_total{job="api",handler="/a",code="500"}'
        values: '0+6x10'
    promql_expr_test:
      - expr: job:prometheus_http_requests:rate5m
        eval_time: 10m
        exp_samples:
          - labels: 'job:prometheus_http_requests:rate5m{job="api"}'
            value: 1
      - expr: job:prometheus_http_requests_errors:ratio_rate5m
        eval_time: 10m
        exp_samples:
          - labels: 'job:prometheus_http_requests_errors:ratio_rate5m{job="api"}'
            value: 0.1

  - name: aucune erreur, le ratio vaut 0 et non vide
    interval: 1m
    input_series:
      - series: 'prometheus_http_requests_total{job="api",handler="/a",code="200"}'
        values: '0+60x10'
    promql_expr_test:
      - expr: job:prometheus_http_requests_errors:ratio_rate5m
        eval_time: 10m
        exp_samples:
          - labels: 'job:prometheus_http_requests_errors:ratio_rate5m{job="api"}'
            value: 0
Comment lire values: '0+54x10' : la série part de 0 et augmente de 54 à chacun des 10 pas d'une minute, soit 0,9 requête par seconde. Avec 0,1 requête en erreur, le ratio attendu est bien 0,1.
7. Déployer #
Recharger la configuration, Kubernetes.
Recharger sans redémarrer #
Après modification, envoyez un signal SIGHUP au processus, ou appelez POST /-/reload si Prometheus a été lancé avec --web.enable-lifecycle. Une erreur dans le fichier laisse l'ancienne configuration en place : vérifiez donc le résultat dans Status > Rule health ou avec /api/v1/rules.
--web.enable-lifecycle permet à quiconque atteint le port de recharger ou d'arrêter Prometheus. Protégez cet accès en production.Sur Kubernetes #
Avec le Prometheus Operator, les règles sont déclarées par une ressource PrometheusRule. Son étiquette doit correspondre au ruleSelector de votre Prometheus, sinon elle est ignorée sans message.
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: http-recording-rules
  namespace: monitoring
  labels:
    release: kube-prometheus-stack   # doit correspondre au ruleSelector de votre Prometheus
spec:
  groups:
    - name: http
      rules:
        - record: job:http_requests:rate5m
          expr: sum by (job) (rate(http_requests_total[5m]))
8. Superviser ses règles #
Détecter un groupe trop lent ou une règle en échec.
Les métriques à suivre #
Si un groupe met plus de temps à s'évaluer que son intervalle, des évaluations sont sautées et des trous apparaissent. Prometheus expose tout ce qu'il faut pour le détecter :
# Une évaluation dépasse-t-elle son intervalle ? (à surveiller en priorité)
rate(prometheus_rule_group_iterations_missed_total[5m]) > 0

# Part de l'intervalle consommée par chaque groupe
prometheus_rule_group_last_duration_seconds / prometheus_rule_group_interval_seconds

# Règles en échec
rate(prometheus_rule_evaluation_failures_total[5m]) > 0
Bonne pratique : alertez sur prometheus_rule_group_iterations_missed_total. Si un groupe devient trop lent, découpez-le : les groupes s'exécutent en parallèle.9. Recalculer le passé #
Le backfill avec promtool.
Créer l'historique d'une nouvelle règle #
promtool tsdb create-blocks-from rules interroge l'API d'un Prometheus et écrit des blocs TSDB dans le dossier data/ (option --output-dir). Il faut ensuite les déplacer dans le répertoire de données (storage.tsdb.path) : ils fusionnent avec les blocs existants au prochain compactage.
Limites documentées : une règle qui dépend d'une autre règle en cours de recalcul n'est pas prise en charge : recalculez d'abord les règles de base, déplacez leurs blocs, puis relancez pour les règles dépendantes. Les alertes du fichier sont ignorées. Relancer sur une période qui se chevauche crée à chaque fois des blocs contenant les mêmes données.
Commandes à connaître #
# Vérifier la syntaxe et compter les règles
promtool check rules rules.yml

# Lancer les tests unitaires
promtool test rules tests.yml

# Recharger sans redémarrer (avec --web.enable-lifecycle)
curl -X POST http://localhost:9090/-/reload

# Lister les règles, leur santé et leur durée
curl -s http://localhost:9090/api/v1/rules | jq '.data.groups[] | {name, evaluationTime, rules: [.rules[] | {name, health}]}'

# Mesurer le coût d'une requête
curl -s --get --data-urlencode 'query=job:prometheus_http_requests:rate5m' --data-urlencode 'stats=all' \
  http://localhost:9090/api/v1/query | jq .data.stats.samples.totalQueryableSamples

# Recalculer le passé (création de blocs TSDB)
promtool tsdb create-blocks-from rules --start 2026-11-01T00:00:00Z --end 2026-11-02T00:00:00Z \
  --url http://localhost:9090 --eval-interval 60s rules.yml