1. Le modèle de log OTel #
Corps, sévérité, attributs, contexte.
Les champs #
| Champ OTel | Stocké dans Elasticsearch (mode otel) |
|---|---|
| Body | body.text (body.structured) |
| SeverityText / SeverityNumber | severity_text / severity_number |
| Attributes | attributes.* |
| Resource | resource.attributes.* (service.name, host.name, k8s.pod.name) |
| TraceId / SpanId | trace_id / span_id : lien direct avec la trace |
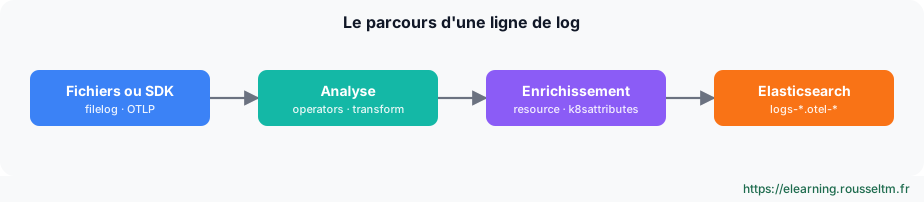
2. Collecter des fichiers #
Le receiver filelog.
Configuration #
receivers:
  filelog:
    include: [/var/log/monapp/*.log]
    start_at: end
    operators:
      - type: regex_parser
        regex: '^(?P<ts>\S+) (?P<level>[A-Z]+) (?P<msg>.*)$'
        timestamp: { parse_from: attributes.ts, layout_type: gotime, layout: '2006-01-02T15:04:05Z07:00' }
        severity: { parse_from: attributes.level }
      - type: move
        from: attributes.msg
        to: body
processors:
  resource:
    attributes:
      - { key: service.name, value: monapp, action: upsert }
service:
  pipelines:
    logs: { receivers: [filelog], processors: [resource, batch], exporters: [elasticsearch] }
Bonne pratique : Renseignez toujours service.name : c'est la clé qui relie logs, traces et métriques d'un même service dans Kibana.Kubernetes #
Sur Kubernetes, le Collector en DaemonSet lit /var/log/pods ; le processeur k8sattributes ajoute namespace, pod, déploiement et labels, indispensables pour filtrer.
3. Interroger et maîtriser les volumes #
ES|QL et filtrage.
Requêtes #
FROM logs-*.otel-*
| WHERE severity_text == "ERROR" AND @timestamp > NOW() - 1 hour
| STATS erreurs = COUNT(*) BY resource.attributes.service.name
| SORT erreurs DESC
Filtrer à la source #
processors:
  filter/debug:
    error_mode: ignore
    logs:
      log_record:
        - severity_number < SEVERITY_NUMBER_INFO
Erreur courante : Envoyer les logs de debug de toute la production : le volume, donc le coût de stockage, explose. Filtrez dans le Collector ou réduisez le niveau dans l'application.
