This article is available in French.
1. Vue d'ensemble #
Les briques d'observabilité d'AWS et leur rôle.
Une offre construite autour de CloudWatch #
Sur AWS, l'observabilité s'articule autour d'Amazon CloudWatch (métriques, journaux, alarmes, tableaux de bord et nombreuses fonctionnalités spécialisées), complété par AWS X-Ray pour les traces, Amazon Managed Service for Prometheus (AMP) pour les métriques au format Prometheus, Amazon Managed Grafana pour la visualisation et Amazon OpenSearch Service pour la recherche de journaux à grande échelle.
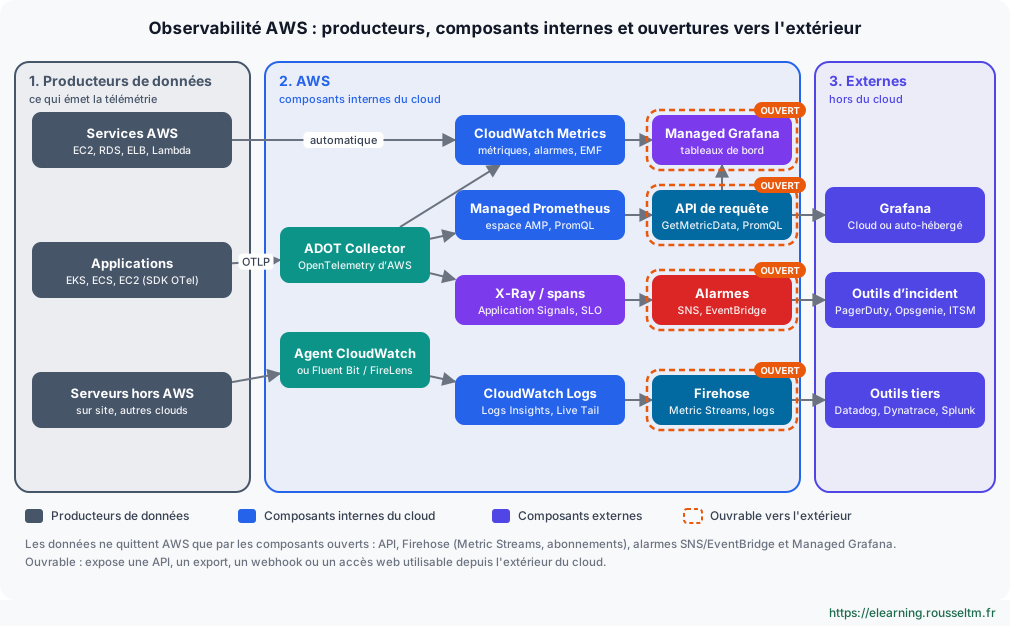
À savoir : CloudWatch collecte automatiquement les métriques de base de la plupart des services managés (EC2, RDS, ELB, Lambda…) sans agent. L'agent ou ADOT n'est nécessaire que pour les métriques du système invité (mémoire, disque), les journaux applicatifs et les traces.
Piliers pris en charge #
| Pilier | Service AWS | Langage / exploration | OpenTelemetry |
|---|---|---|---|
| Métriques | CloudWatch Metrics, Managed Service for Prometheus | Metric Insights (SQL), PromQL | ✅ Oui (ADOT : EMF, remote write) |
| Journaux | CloudWatch Logs, OpenSearch Service | Logs Insights (QL, SQL, PPL), Live Tail | ✅ Oui (ADOT, point de terminaison OTLP) |
| Traces | AWS X-Ray, Transaction Search, Application Signals | Requêtes de traces, carte des services | ✅ Oui (OTLP vers X-Ray) |
| Profils | Amazon CodeGuru Profiler (Java, Python) | Graphes de flammes | 🟡 Partiel (vérifier la disponibilité ; alternative Pyroscope) |
| RUM et synthétique | CloudWatch RUM, CloudWatch Synthetics (canaries) | Tableaux de bord dédiés | 🟡 Partiel |
| Événements | EventBridge, CloudTrail (audit) | CloudTrail Lake (SQL) | ❌ Non |
Point d'attention : Les profils restent le pilier le moins couvert nativement : AWS a réduit ses investissements sur CodeGuru. Pour le profilage continu, beaucoup d'équipes utilisent Grafana Pyroscope ou la solution de profilage de leur outil APM.
2. Les composants en détail #
Ce que fait chaque service et quand l'utiliser.
CloudWatch Metrics et alarmes #
Les métriques sont organisées par namespace (AWS/EC2, AWS/Lambda…), nom et dimensions. La résolution standard est d'une minute ; les métriques haute résolution descendent à la seconde. Les alarmes évaluent une métrique ou une expression (metric math) et déclenchent une notification SNS, une action Auto Scaling ou EC2. Les alarmes composites combinent plusieurs alarmes pour réduire le bruit, et la détection d'anomalies calcule une bande de valeurs attendues.
aws cloudwatch put-metric-alarm --alarm-name api-5xx \
  --namespace AWS/ApplicationELB --metric-name HTTPCode_Target_5XX_Count \
  --dimensions Name=LoadBalancer,Value=app/api/123abc \
  --statistic Sum --period 60 --evaluation-periods 5 --datapoints-to-alarm 3 \
  --threshold 10 --comparison-operator GreaterThanThreshold \
  --alarm-actions arn:aws:sns:eu-west-3:111122223333:astreinte
Le format Embedded Metric Format (EMF) permet d'écrire des métriques dans un journal structuré JSON : CloudWatch les extrait automatiquement, ce qui est idéal pour Lambda.
CloudWatch Logs #
Les journaux sont rangés en groupes et flux, avec une rétention configurable par groupe. Logs Insights interroge les journaux avec son langage de requête (ainsi qu'en SQL et PPL selon les versions), Live Tail les suit en direct, les filtres de métriques transforment des motifs en métriques et la classe Infrequent Access réduit le coût des journaux peu consultés. La protection des données masque automatiquement des données sensibles.
aws logs start-query --log-group-name /aws/lambda/commande \
  --start-time $(date -d '-1 hour' +%s) --end-time $(date +%s) \
  --query-string 'fields @timestamp, @message | filter level = "ERROR" | stats count() by bin(5m)'
Traces : X-Ray, Transaction Search et Application Signals #
AWS X-Ray reçoit les segments et spans, construit une carte des services et permet d'analyser les traces. Transaction Search stocke désormais l'ensemble des spans dans CloudWatch Logs (groupe aws/spans) pour les rechercher et les agréger. CloudWatch Application Signals apporte une vue APM : services découverts automatiquement, métriques RED (volume, erreurs, latence), dépendances et SLO avec budget d'erreur, à partir d'une instrumentation OpenTelemetry (ADOT).
Bonne Pratique : Activez Application Signals sur EKS, ECS, EC2 ou Lambda pour obtenir en quelques minutes un tableau de bord par service et définir des SLO directement dans CloudWatch.
Fonctionnalités spécialisées de CloudWatch #
| Fonctionnalité | Rôle |
|---|---|
| Container Insights | Métriques et journaux des clusters EKS, ECS et Kubernetes (avec observabilité améliorée sur EKS) |
| Lambda Insights | Métriques système des fonctions (mémoire, durée, démarrages à froid) |
| Database Insights | Analyse de la charge et des requêtes des bases RDS et Aurora |
| CloudWatch RUM | Expérience réelle des utilisateurs web : Core Web Vitals, erreurs JavaScript, sessions |
| CloudWatch Synthetics | Canaries (scripts Node.js ou Python) qui testent des parcours et des API en continu |
| Internet Monitor, Network Flow Monitor | Disponibilité et performance réseau vers les utilisateurs et entre ressources |
| Contributor Insights | Classement des principaux contributeurs (IP, clients) à partir des journaux |
| Investigations | Assistant d'enquête qui corrèle métriques, journaux, traces et changements lors d'un incident |
Managed Prometheus, Managed Grafana et OpenSearch #
Amazon Managed Service for Prometheus stocke des métriques Prometheus sans serveur à gérer : on y écrit par remote write (Prometheus, ADOT, Grafana Alloy) ou avec ses scrapers managés pour EKS, puis on l'interroge en PromQL. Amazon Managed Grafana fournit des espaces Grafana avec authentification IAM Identity Center ou SAML et des sources de données CloudWatch, X-Ray, AMP, OpenSearch, Athena et partenaires. OpenSearch Service sert à l'analyse de journaux et de traces avec OpenSearch Dashboards.
3. Fiche détaillée de chaque composant #
Rôle, contenu, types de données, rétention et interactions internes et externes de chaque brique du schéma.
Vue récapitulative #
Le tableau suivant résume chaque composant du schéma d'architecture ; les fiches qui suivent les détaillent une par une.
| Composant | Zone | Signaux | Ouvrable vers l'extérieur |
|---|---|---|---|
| ADOT Collector | Collecte | Métriques, traces, journaux | 🔒 Non (interne) |
| Agent CloudWatch / Fluent Bit | Collecte | Métriques système, journaux | 🔒 Non (interne) |
| CloudWatch Metrics | Stockage | Métriques | 🟡 Indirectement |
| Managed Prometheus | Stockage | Métriques Prometheus | 🟡 Indirectement |
| X-Ray / Application Signals | Stockage et APM | Traces, métriques RED, SLO | 🟡 Indirectement |
| CloudWatch Logs | Stockage | Journaux, spans | 🟡 Indirectement |
| Managed Grafana | Sortie | Visualisation | 🟠 Oui |
| API de requête | Sortie | Tous | 🟠 Oui |
| Alarmes (SNS, EventBridge) | Sortie | Événements | 🟠 Oui |
| Firehose | Sortie | Métriques et journaux en flux | 🟠 Oui |
Valeurs indicatives : Les durées de rétention, limites et modèles de prix évoluent régulièrement : vérifiez-les dans la documentation officielle avant de dimensionner une architecture.
ADOT Collector (AWS Distro for OpenTelemetry) #
Le collecteur ADOT est la distribution du collecteur OpenTelemetry maintenue par AWS : il reçoit la télémétrie des applications, l'enrichit et l'exporte vers les services AWS.
| Caractéristique | Détail |
|---|---|
| Rôle | Recevoir, traiter (lots, échantillonnage, enrichissement des ressources) et router traces, métriques et journaux OpenTelemetry. |
| Contenu | Récepteurs otlp, prometheus, awsecscontainermetrics ; processeurs batch, resourcedetection ; exportateurs awsemf, awsxray, prometheusremotewrite, awscloudwatchlogs ; extension sigv4auth. |
| Type de données | OTLP (gRPC 4317, HTTP 4318), format Prometheus, EMF en sortie vers CloudWatch. |
| Stockage et rétention | Aucun stockage durable : files d'envoi en mémoire (ou sur disque avec file_storage). |
| Entrées (composants internes) | Applications instrumentées (SDK OpenTelemetry, agents Java, Python, .NET, Node.js), cibles Prometheus. |
| Sorties (composants internes) | CloudWatch Metrics (EMF), Managed Prometheus (remote write), X-Ray (traces), CloudWatch Logs. |
| Interactions externes | Peut aussi exporter directement vers un back-end tiers compatible OTLP (Datadog, Dynatrace, Grafana Cloud…). |
| Ouvrable vers l'extérieur | 🔒 Non (interne) : il émet vers l'extérieur seulement si on lui ajoute un exportateur tiers. |
| Sécurité et accès | Rôle IAM de la tâche ECS, du pod EKS (IRSA ou Pod Identity) ou de l'instance ; signature SigV4 des appels. |
| Coût | Gratuit ; on paie le calcul qui l'héberge et les services de destination. |
À savoir : Déploiement : module complémentaire EKS, conteneur sidecar ECS, couche Lambda ou service sur EC2.
Agent CloudWatch et Fluent Bit (FireLens) #
L'agent CloudWatch collecte ce que la plateforme ne voit pas depuis l'extérieur d'une machine ; Fluent Bit, souvent via FireLens sur ECS, achemine les journaux des conteneurs.
| Caractéristique | Détail |
|---|---|
| Rôle | Collecter métriques du système invité (mémoire, disque, processus), fichiers journaux, métriques StatsD/collectd ; alimenter Container Insights et Application Signals. |
| Contenu | Configuration JSON (souvent stockée dans Systems Manager Parameter Store) ; pour Fluent Bit, entrées, filtres et sorties (cloudwatch_logs, kinesis_firehose, opensearch). |
| Type de données | Métriques (CloudWatch), journaux texte ou JSON. |
| Stockage et rétention | Aucun : tampons locaux. |
| Entrées (composants internes) | Serveurs EC2, serveurs sur site ou d'autres clouds, conteneurs ECS/EKS. |
| Sorties (composants internes) | CloudWatch Metrics, CloudWatch Logs. |
| Interactions externes | Fluent Bit peut aussi envoyer directement vers Splunk, Datadog, Elastic, Loki ou une sortie HTTP. |
| Ouvrable vers l'extérieur | 🔒 Non (interne) |
| Sécurité et accès | Rôle IAM avec CloudWatchAgentServerPolicy ; clés d'accès ou rôle IAM Roles Anywhere pour les serveurs hors AWS. |
| Coût | Gratuit ; métriques personnalisées et ingestion de journaux facturées. |
CloudWatch Metrics #
Le magasin de séries temporelles d'AWS : chaque service y publie ses métriques, et les applications peuvent y ajouter les leurs.
| Caractéristique | Détail |
|---|---|
| Rôle | Stocker, agréger et rendre interrogeables les métriques ; base des alarmes, tableaux de bord et de l'autoscaling. |
| Contenu | Métriques identifiées par namespace, nom et jusqu'à 30 dimensions ; statistiques (Sum, Average, p99…), metric math, Metrics Insights (SQL), détection d'anomalies. |
| Type de données | Points numériques horodatés ; résolution standard 1 minute, haute résolution jusqu'à 1 seconde. |
| Stockage et rétention | Points de moins d'une minute conservés 3 heures, 1 minute pendant 15 jours, 5 minutes pendant 63 jours, 1 heure pendant 455 jours (15 mois). |
| Entrées (composants internes) | Services AWS (automatique), agent CloudWatch, ADOT (EMF), PutMetricData, filtres de métriques des journaux. |
| Sorties (composants internes) | Alarmes, tableaux de bord CloudWatch, Managed Grafana, Metric Streams. |
| Interactions externes | Lu par Datadog, Dynatrace, New Relic via l'API (rôle en lecture) ou poussé via Metric Streams et Firehose. |
| Ouvrable vers l'extérieur | 🟡 Indirectement : par l'API de requête et Metric Streams. |
| Sécurité et accès | Politiques IAM (cloudwatch:GetMetricData, PutMetricData) ; observabilité inter-comptes. |
| Coût | Métriques de base gratuites ; métriques personnalisées, appels d'API et alarmes facturés. |
Amazon Managed Service for Prometheus (AMP) #
Un back-end Prometheus sans serveur à gérer, compatible PromQL.
| Caractéristique | Détail |
|---|---|
| Rôle | Stocker à grande échelle les métriques au format Prometheus, notamment celles des clusters Kubernetes. |
| Contenu | Espaces de travail (workspaces), règles d'enregistrement et d'alerte, gestionnaire d'alertes compatible Alertmanager, collecteurs (scrapers) managés pour EKS. |
| Type de données | Séries temporelles Prometheus (étiquettes clé-valeur). |
| Stockage et rétention | Rétention de 150 jours par défaut, configurable. |
| Entrées (composants internes) | Remote write depuis ADOT, Prometheus, Grafana Alloy ; scrapers managés. |
| Sorties (composants internes) | API PromQL, Managed Grafana ; alertes vers SNS. |
| Interactions externes | Toute application compatible PromQL (Grafana auto-hébergé, outils maison) peut l'interroger avec SigV4. |
| Ouvrable vers l'extérieur | 🟡 Indirectement : par son API de requête PromQL. |
| Sécurité et accès | IAM (aps:RemoteWrite, aps:QueryMetrics) et signature SigV4 ; points de terminaison VPC possibles. |
| Coût | Échantillons ingérés, stockés et requêtés. |
AWS X-Ray, Transaction Search et Application Signals #
La brique traces et APM d'AWS, désormais intégrée à CloudWatch.
| Caractéristique | Détail |
|---|---|
| Rôle | Recevoir les spans, reconstituer les traces et la carte des services, calculer les métriques RED et suivre les SLO des services. |
| Contenu | Segments et sous-segments (ou spans OpenTelemetry), règles d'échantillonnage, carte des services, Transaction Search (spans indexés), Application Signals (services, opérations, dépendances, SLO). |
| Type de données | Traces et spans, métriques dérivées (volume, erreurs, latence). |
| Stockage et rétention | Traces conservées 30 jours ; avec Transaction Search, les spans sont stockés dans CloudWatch Logs (groupe aws/spans) selon sa rétention. |
| Entrées (composants internes) | ADOT et agent CloudWatch (OTLP), SDK X-Ray, services instrumentés automatiquement (Lambda, API Gateway). |
| Sorties (composants internes) | Console CloudWatch, alarmes de SLO, Managed Grafana (source X-Ray). |
| Interactions externes | Les traces OpenTelemetry peuvent être envoyées en parallèle à un APM tiers par le collecteur. |
| Ouvrable vers l'extérieur | 🟡 Indirectement : par l'API X-Ray (GetTraceSummaries, BatchGetTraces). |
| Sécurité et accès | IAM (xray:PutTraceSegments, xray:GetTraceSummaries). |
| Coût | Traces enregistrées et lues ; Application Signals et Transaction Search facturés selon le volume. |
CloudWatch Logs #
Le magasin central des journaux sur AWS.
| Caractéristique | Détail |
|---|---|
| Rôle | Recevoir, conserver, rechercher et analyser les journaux ; les transformer en métriques ou les diffuser vers d'autres systèmes. |
| Contenu | Groupes et flux de journaux, Logs Insights, Live Tail, filtres de métriques, filtres d'abonnement, protection des données sensibles, classes Standard et Infrequent Access. |
| Type de données | Événements de journal (texte ou JSON) horodatés ; journaux « vendus » des services (VPC Flow Logs, Route 53, API Gateway…). |
| Stockage et rétention | Rétention par groupe, de 1 jour à 10 ans, ou illimitée (valeur par défaut) ; export ponctuel vers S3. |
| Entrées (composants internes) | Agent CloudWatch, Fluent Bit, Lambda (automatique), services AWS, ADOT. |
| Sorties (composants internes) | Filtres d'abonnement vers Firehose, Kinesis, Lambda ou OpenSearch ; métriques via filtres de métriques. |
| Interactions externes | Diffusion vers Splunk, Datadog, Elastic via Firehose ; requêtes par l'API depuis un outil tiers. |
| Ouvrable vers l'extérieur | 🟡 Indirectement : par les filtres d'abonnement (via Firehose) et l'API. |
| Sécurité et accès | IAM par groupe de journaux ; chiffrement KMS possible. |
| Coût | Ingestion (le plus gros poste), stockage et requêtes Logs Insights. |
Amazon Managed Grafana #
Des espaces Grafana entièrement gérés par AWS.
| Caractéristique | Détail |
|---|---|
| Rôle | Visualiser et corréler toutes les sources : tableaux de bord, explorations, alertes Grafana. |
| Contenu | Espaces de travail, sources de données (CloudWatch, X-Ray, AMP, OpenSearch, Athena, Timestream, plugins Enterprise), tableaux de bord, alertes. |
| Type de données | Ne stocke pas de télémétrie : interroge les sources à la demande. |
| Stockage et rétention | Tableaux de bord et configuration seulement. |
| Entrées (composants internes) | CloudWatch Metrics, Managed Prometheus, X-Ray, CloudWatch Logs. |
| Sorties (composants internes) | Notifications d'alertes Grafana (SNS, Slack, PagerDuty…). |
| Interactions externes | Peut aussi interroger des sources externes (Datadog, Splunk, Prometheus auto-hébergé) avec les plugins adaptés. |
| Ouvrable vers l'extérieur | 🟠 Oui : interface web accessible aux utilisateurs authentifiés, API Grafana. |
| Sécurité et accès | IAM Identity Center ou SAML ; rôles Grafana ; accès réseau public ou par VPC. |
| Coût | Par utilisateur actif (éditeur ou lecteur). |
API de requête (CloudWatch, Logs, X-Ray, AMP) #
Toutes les données d'observabilité AWS sont accessibles par API : c'est la principale porte de sortie « en lecture ».
| Caractéristique | Détail |
|---|---|
| Rôle | Permettre à des outils, scripts ou tableaux de bord d'interroger métriques, journaux et traces. |
| Contenu | GetMetricData et ListMetrics (CloudWatch), StartQuery et GetQueryResults (Logs Insights), GetTraceSummaries et BatchGetTraces (X-Ray), API HTTP Prometheus (AMP). |
| Type de données | Réponses JSON (séries, lignes de journaux, traces). |
| Entrées (composants internes) | CloudWatch Metrics, CloudWatch Logs, X-Ray, Managed Prometheus. |
| Sorties (composants internes) | Managed Grafana et tout client autorisé. |
| Interactions externes | Grafana auto-hébergé, Datadog, Dynatrace, New Relic (interrogation), scripts et outils maison. |
| Ouvrable vers l'extérieur | 🟠 Oui : points de terminaison publics des services AWS (ou points de terminaison VPC). |
| Sécurité et accès | Signature SigV4 avec des identifiants IAM ; principe du moindre privilège (rôle en lecture seule). |
| Coût | Facturation par requête (GetMetricData, requêtes Logs Insights au Go analysé). |
À savoir : Pour un outil tiers, préférez Metric Streams à l'interrogation périodique : moins de latence et pas de coût d'appels GetMetricData.
Alarmes CloudWatch, SNS et EventBridge #
La chaîne qui transforme une condition sur les données en action ou en notification.
| Caractéristique | Détail |
|---|---|
| Rôle | Évaluer des seuils, anomalies ou SLO et déclencher des actions. |
| Contenu | Alarmes de métrique, alarmes composites, alarmes de détection d'anomalies, alarmes de SLO (Application Signals) ; états OK, ALARM, INSUFFICIENT_DATA. |
| Type de données | Événements de changement d'état. |
| Entrées (composants internes) | CloudWatch Metrics, métriques Application Signals, règles d'alerte de Managed Prometheus. |
| Sorties (composants internes) | Actions Auto Scaling, EC2 et Systems Manager (OpsItems, incidents). |
| Interactions externes | SNS (e-mail, SMS, HTTPS, Lambda), EventBridge vers PagerDuty, Opsgenie, ServiceNow, webhooks ; Amazon Q Developer dans Slack ou Teams. |
| Ouvrable vers l'extérieur | 🟠 Oui : notifications et événements sortants. |
| Sécurité et accès | Politiques de sujet SNS et règles EventBridge ; chiffrement KMS des sujets. |
| Coût | Par alarme et par notification. |
Amazon Data Firehose (Metric Streams et abonnements) #
Le service de diffusion en continu qui fait sortir métriques et journaux d'AWS vers d'autres outils.
| Caractéristique | Détail |
|---|---|
| Rôle | Acheminer en quasi temps réel des flux de télémétrie vers une destination, avec mise en tampon, transformation et reprise sur erreur. |
| Contenu | Flux de diffusion (delivery streams), tampons (taille ou durée), transformation Lambda, sauvegarde des échecs dans S3. |
| Type de données | Métriques CloudWatch (JSON ou format OpenTelemetry) issues de Metric Streams ; événements de journaux issus des filtres d'abonnement. |
| Stockage et rétention | Aucun stockage durable (tampons) ; copie possible dans S3. |
| Entrées (composants internes) | CloudWatch Metric Streams, filtres d'abonnement de CloudWatch Logs. |
| Sorties (composants internes) | S3, OpenSearch Service, Redshift. |
| Interactions externes | Points de terminaison HTTP de Datadog, Dynatrace, New Relic, Elastic, Sumo Logic ; Splunk (HEC). |
| Ouvrable vers l'extérieur | 🟠 Oui : c'est le principal canal d'export en continu. |
| Sécurité et accès | Rôle IAM de diffusion ; clé d'API de la destination stockée dans Secrets Manager. |
| Coût | Volume de données traitées (et métriques diffusées pour Metric Streams). |
4. Compatibilité OpenTelemetry #
ADOT, points de terminaison OTLP et configuration d'un collecteur.
AWS Distro for OpenTelemetry (ADOT) #
ADOT est la distribution d'OpenTelemetry maintenue par AWS : collecteur, SDK et agents d'instrumentation automatique (Java, Python, .NET, Node.js) avec les composants AWS (détecteurs de ressources EC2, ECS, EKS, Lambda, exportateurs awsemf et awsxray, authentification sigv4auth). Elle est disponible en module complémentaire EKS, en couche Lambda et en image de conteneur.
CloudWatch expose aussi des points de terminaison OTLP pour les traces (X-Ray) et les journaux : un collecteur OpenTelemetry standard peut y envoyer ses données en OTLP/HTTP, signées avec SigV4.
extensions:
  sigv4auth:
    region: eu-west-3
    service: aps
receivers:
  otlp:
    protocols: { grpc: {}, http: {} }
processors:
  batch: {}
  resourcedetection: { detectors: [env, eks, ec2] }
exporters:
  awsemf:                      # métriques vers CloudWatch (Embedded Metric Format)
    namespace: Boutique
  awsxray: {}                  # traces vers X-Ray
  prometheusremotewrite:       # métriques vers Managed Prometheus
    endpoint: https://aps-workspaces.eu-west-3.amazonaws.com/workspaces/ws-1234/api/v1/remote_write
    auth: { authenticator: sigv4auth }
service:
  extensions: [sigv4auth]
  pipelines:
    traces:  { receivers: [otlp], processors: [resourcedetection, batch], exporters: [awsxray] }
    metrics: { receivers: [otlp], processors: [resourcedetection, batch], exporters: [awsemf, prometheusremotewrite] }
À savoir : Les SDK OpenTelemetry s'utilisent tels quels : pour X-Ray, ajoutez le générateur d'identifiants et le propagateur X-Ray seulement si vous devez interopérer avec d'anciens services instrumentés par le SDK X-Ray ; sinon le contexte W3C suffit.
5. Interconnexions avec les produits externes #
Envoyer les données AWS vers d'autres outils et inversement.
Exporter depuis AWS #
| Mécanisme | Données | Destinations typiques |
|---|---|---|
| CloudWatch Metric Streams | Métriques CloudWatch en continu (JSON ou OpenTelemetry 1.0) | Kinesis Data Firehose vers Datadog, Dynatrace, New Relic, Splunk, Elastic, S3 |
| Filtres d'abonnement des journaux | Événements de journaux | Firehose, Lambda, Kinesis, OpenSearch ; puis Splunk, Datadog, Elastic… |
| Intégrations par rôle IAM | Métriques, tags, inventaire | Datadog, Dynatrace, New Relic interrogent les API CloudWatch avec un rôle en lecture |
| Managed Grafana | Toutes les sources AWS | Tableaux de bord communs avec Prometheus, Loki, Splunk, Datadog (plugins) |
| EventBridge | Changements d'état, alarmes | Outils d'incident (PagerDuty, Opsgenie), ITSM, webhooks |
Bonne Pratique : Préférez Metric Streams à l'interrogation des API (polling) pour envoyer les métriques à un outil tiers : la latence passe de plusieurs minutes à quelques secondes et le coût des appels GetMetricData disparaît.
Centraliser plusieurs comptes #
L'observabilité inter-comptes de CloudWatch (Observability Access Manager) relie des comptes sources à un compte de supervision : métriques, journaux, traces et Application Signals y sont consultables sans copie de données. Combinée à AWS Organizations, elle donne une vue unique de toute l'organisation.
6. Coûts et bonnes pratiques #
Maîtriser la facture et rendre l'observabilité utile.
Bonnes pratiques #
- Définir une rétention par groupe de journaux (la valeur par défaut est « jamais expirer »).
- Limiter la cardinalité des dimensions personnalisées : chaque combinaison est une métrique facturée.
- Instrumenter avec OpenTelemetry (ADOT) pour rester portable vers d'autres back-ends.
- Utiliser les alarmes composites et la détection d'anomalies pour réduire le bruit.
- Échantillonner les traces (règles d'échantillonnage X-Ray ou échantillonnage par queue dans le collecteur).
- Activer l'observabilité inter-comptes et tagger les ressources pour attribuer les coûts.
Erreur courante : Les journaux sont souvent le premier poste de coût : ingérer tous les journaux de debug en production peut coûter plus cher que les serveurs eux-mêmes.
My progress
Sign in to track your progress and take notes. Sign in
Recommended Articles
Superviser et sécuriser AWS : CloudWatch, CloudTrail, Config, KMS et GuardDuty
Exploiter et protéger un environnement AWS : métriques, logs et alarmes CloudWatch, journal des a...
Bonnes pratiques AWS : sécurité, fiabilité, coûts et exploitation
Les bonnes pratiques essentielles pour exploiter AWS en production : organisation multi-comptes, ...
Comprendre AWS : infrastructure mondiale, comptes, outils et tarification
Les bases indispensables pour démarrer sur Amazon Web Services : régions, zones de disponibilité ...
IAM : identités, rôles et politiques sur AWS
Sécuriser l'accès à AWS avec IAM : utilisateurs, groupes, rôles et politiques JSON, évaluation de...
Le réseau AWS : VPC, sous-réseaux, routage et sécurité
Concevoir un réseau AWS : VPC et plages CIDR, sous-réseaux publics et privés, tables de routage, ...
Le calcul sur AWS : EC2, Auto Scaling, Lambda et conteneurs
Choisir et utiliser les services de calcul AWS : instances EC2 (types, AMI, EBS, user data, modèl...
Le stockage sur AWS : S3, EBS, EFS et sauvegarde
Stocker des données sur AWS : Amazon S3 (buckets, classes de stockage, versionnage, cycle de vie,...
Les bases de données sur AWS : RDS, Aurora, DynamoDB et ElastiCache
Choisir une base de données managée sur AWS : RDS et Aurora pour le relationnel (multi-AZ, réplic...
Infrastructure as Code sur AWS : CloudFormation, CDK, Terraform et Well-Architected
Décrire et déployer son infrastructure AWS en code avec CloudFormation, le CDK ou Terraform, auto...