Este artículo está disponible en francés.
1. L'architecture distribuée #
Leader, groupes, Workers.
Les rôles #
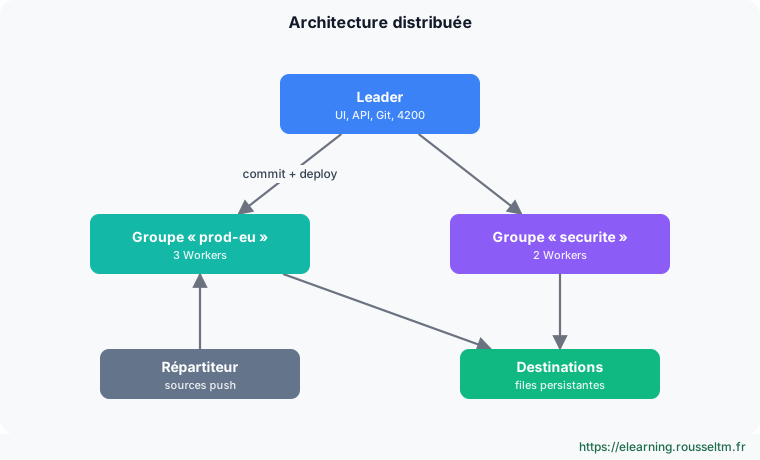
| Rôle | Responsabilité |
|---|---|
| Leader | interface, API, configuration versionnée dans Git, distribution aux Workers (port 4200) ; ne traite pas les données |
| Groupe de Workers | ensemble de Workers qui partagent exactement la même configuration (par région, par usage) |
| Worker | nœud qui traite les données ; lance plusieurs processus (en général un par cœur, moins un ou deux) |
Si le Leader tombe, les Workers continuent de traiter avec leur dernière configuration : seules les modifications et la supervision centralisée sont interrompues.
Un cluster de test #
services:
  leader:
    image: cribl/cribl:4.20.0
    environment:
      CRIBL_DIST_MODE: leader
      CRIBL_DIST_LEADER_URL: tcp://0.0.0.0:4200
      CRIBL_DIST_AUTH_TOKENS: ${CRIBL_TOKEN}
      CRIBL_VOLUME_DIR: /opt/cribl/config-volume
    ports: ["19000:9000"]
    volumes: ["./leader:/opt/cribl/config-volume"]
  workers:
    image: cribl/cribl:4.20.0
    environment:
      CRIBL_DIST_MODE: worker
      CRIBL_DIST_LEADER_URL: tcp://${CRIBL_TOKEN}@leader:4200
    depends_on: [leader]
# docker compose up -d --scale workers=2
À savoir : Avec la licence gratuite, un seul groupe (default) est disponible. Le jetonCRIBL_DIST_AUTH_TOKENSauthentifie les Workers : choisissez une valeur aléatoire et gardez-la secrète.
2. Modifier en sécurité #
Commit et déploiement.
Le cycle #
- On modifie la configuration d'un groupe sur le Leader : rien ne change encore sur les Workers.
- Commit : la modification devient une version Git, avec un message.
- Deploy : les Workers du groupe téléchargent la version et rechargent sans couper le flux.
- En cas de problème, on redéploie une version précédente depuis l'historique.
Bonne Pratique : Configurez un dépôt Git distant (Settings › Git) pour pousser automatiquement l'historique : c'est votre sauvegarde de configuration et votre piste d'audit.
3. Mettre à l'échelle #
Processus, Workers, répartition.
Principes #
- Verticalement : plus de cœurs = plus de processus Worker ; réglable dans les paramètres du groupe.
- Horizontalement : ajouter des Workers au groupe ; pour les sources push (syslog, HEC), placer un répartiteur de charge devant eux.
- Les sources pull (Kafka, SQS) se répartissent naturellement entre Workers ; les collecteurs répartissent leurs tâches.
- Dimensionnez à partir de mesures : CPU par processus, débit par Worker, et gardez une marge pour les pics et la perte d'un nœud.
Attention : Le syslog UDP derrière un répartiteur perd la notion de flux : préférez TCP, ou un collecteur syslog local qui relaie en TCP.
4. Ne rien perdre #
Contre-pression et files persistantes.
Files persistantes #
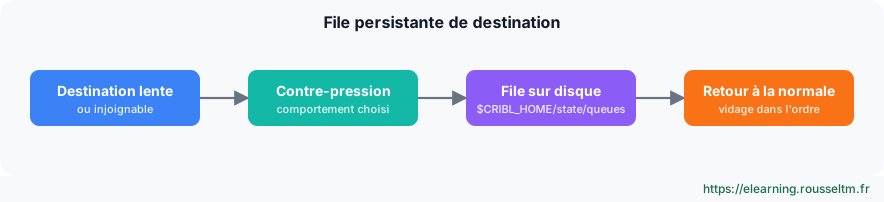
| Réglage de destination | Effet quand la destination ne suit plus |
|---|---|
| Block | Cribl ralentit la lecture des sources (les émetteurs attendent) ; risque de perte côté émetteur UDP |
| Drop | les événements sont jetés : acceptable pour des données peu critiques |
| Persistent Queue | les événements sont écrits sur disque, puis envoyés dans l'ordre au retour de la destination |
- Dimensionnez la taille maximale de la file (Go) pour couvrir la plus longue indisponibilité tolérée, et surveillez l'espace disque.
- Les sources push peuvent aussi avoir une file persistante, utile quand l'émetteur ne sait pas réessayer ; depuis la version 4.20, le mode « Smart » des files de source est déprécié au profit du mode toujours actif.
Haute disponibilité du Leader #
Un second Leader en attente, avec un stockage partagé (NFS) pour la configuration, reprend en cas de panne. Sur Cribl.Cloud, le Leader est géré par Cribl.
5. Superviser et sécuriser #
Voir et protéger.
Superviser #
- Monitoring : débit par source et destination, CPU et mémoire des Workers, files persistantes, erreurs.
- Source Cribl Internal : envoyez les logs et métriques internes de Cribl vers votre outil d'observabilité, pour alerter même si l'interface est indisponible.
- Notifications : alertes sur source sans données, destination en erreur, file qui se remplit, licence.
- Point de santé :
GET /api/v1/healthpour les sondes du répartiteur et de Kubernetes.
Sécuriser #
- TLS sur l'interface, entre Leader et Workers, et sur les sources exposées.
- Comptes nominatifs, rôles (RBAC selon licence), authentification unique ; pas de compte
adminpartagé. - Secrets (mots de passe de destinations, clés) dans le gestionnaire de secrets de Cribl, pas en clair dans les pipelines.
Commandes à connaître #
Commandes à connaître
docker compose up -d --scale workers=2: ajouter des Workers (test)curl -s http://leader:9000/api/v1/health: santé d'un nœuddu -sh /opt/cribl/state/queues: taille des files persistantesCRIBL_DIST_LEADER_URL=tcp://<jeton>@leader:4200: rattacher un Worker
Sources #
Vérifié en novembre 2026 (Cribl 4.20) : Cribl publie une version mineure environ tous les deux mois, consultez les notes de version avant de vous appuyer sur un détail.
Mi seguimiento
Inicia sesión para seguir tu progreso y tomar notas. Iniciar sesión
💬 Preguntas sobre esta lección
Todavía no hay preguntas: sé el primero en pedir ayuda o compartir tu configuración.
Artículos recomendados
Logstash en producción: colas persistentes, DLQ y varios pipelines
Hacer que Logstash sea fiable en producción: cola persistente, dead letter queue, varios pipeline...
Bonnes pratiques Cribl Stream et Edge
Les bonnes pratiques pour exploiter Cribl en production : conception des routes et pipelines, nom...
Automatiser Cribl : API REST, Packs, Git et Terraform
Gérer Cribl comme du code : API REST (authentification, chemins par groupe, commit et déploiement...
Sources, destinations et routes dans Cribl Stream
Recevoir et envoyer des données avec Cribl Stream : sources push, pull, collecteurs et internes, ...
Cribl : le pipeline de données pour l'observabilité et la sécurité
Découvrir Cribl : pourquoi un pipeline de données de télémétrie, la suite Cribl (Stream, Edge, La...
Installer et administrer Cribl Stream
Installer Cribl Stream en Docker ou sur Linux, le lancer comme service, comprendre $CRIBL_HOME, d...
Bindplane en production : haute disponibilité, sécurité, Kubernetes et configuration as code
Exploiter Bindplane en production : serveurs actifs-actifs, PostgreSQL et bus d'événements, TLS p...
Réduire, transformer et optimiser les volumes avec Cribl
Réduire le volume envoyé aux SIEM et outils d'observabilité sans perdre d'information utile : Dro...
Archiver, rejouer et rechercher : S3, Replay, Cribl Lake et Cribl Search
Garder toutes les données à bas coût et les retrouver à la demande : destination S3 partitionnée,...