Este artículo está disponible en francés.
1. Où transformer les données ? #
Data Prepper ou pipeline d'ingestion.
Deux niveaux #
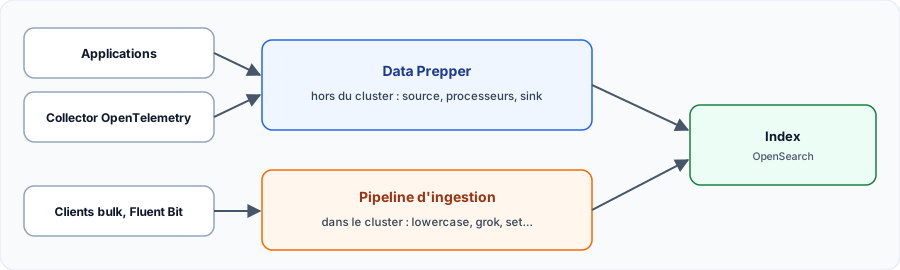
| Pipeline d’ingestion | Data Prepper | |
|---|---|---|
| Où ? | Dans le cluster | Service séparé |
| Pour | Transformations simples | Traitement lourd, OpenTelemetry, routage |
| Sources | Requêtes d’indexation | HTTP, OTLP, S3, Kafka… |
| Charge | Sur les nœuds OpenSearch | Sur ses propres serveurs |
2. Les pipelines d'ingestion #
Transformer à l'indexation.
Créer et simuler #
curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' -X PUT https://localhost:9200/_ingest/pipeline/logs_nettoyage -d '{
  "description": "Normalise le niveau et extrait l utilisateur",
  "processors": [
    {"lowercase": {"field": "level"}},
    {"set": {"field": "environnement", "value": "prod"}},
    {"grok": {"field": "message", "patterns": ["utilisateur=%{WORD:utilisateur}"], "ignore_failure": true}}
  ]
}'

# Essayer sans rien indexer
curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' -X POST https://localhost:9200/_ingest/pipeline/logs_nettoyage/_simulate \
  -d '{"docs":[{"_source":{"level":"ERROR","message":"refus utilisateur=alice"}}]}'
Le résultat de la simulation contient level: error, environnement: prod et utilisateur: alice. Pour l'utiliser : _bulk?pipeline=logs_nettoyage, ou le réglage index.default_pipeline dans le modèle.
Bonne pratique : testez toujours avec_simulate, et prévoyezignore_failureouon_failure: sinon, un seulgroken échec rejette le document.
3. Data Prepper #
Le collecteur du projet OpenSearch.
Un pipeline de logs #
Un pipeline a une source, des processeurs et un sink. Celui-ci a été testé de bout en bout sur Data Prepper 2.16 :
log-pipeline:
  source:
    http:
      ssl: false
      port: 2021
      path: /log/ingest
  processor:
    - grok:
        match:
          log: ['%{COMMONAPACHELOG}']
    - date:
        match:
          - key: timestamp
            patterns: ["dd/MMM/yyyy:HH:mm:ss Z"]
        destination: "@timestamp"
    - convert_type:
        key: response
        type: integer
    - delete_entries:
        with_keys: ["log"]
  sink:
    - opensearch:
        hosts: ["https://opensearch:9200"]
        insecure: true
        username: admin
        password: "Str0ng!Passw0rd-2026"
        index: web-logs
        flush_timeout: 5000
curl -s -X POST -H 'Content-Type: application/json' http://localhost:2021/log/ingest -d '[
{"log":"127.0.0.1 - frank [04/Nov/2026:10:00:00 +0100] \"GET /index.html HTTP/1.1\" 200 2326"},
{"log":"10.0.0.8 - alice [04/Nov/2026:10:00:01 +0100] \"GET /admin HTTP/1.1\" 403 120"}
]'Le piège du mapping #
Sans modèle d'index, les types sont devinés. Lors de notre essai,clientipetbytesse sont retrouvés entext: aucune recherche par réseau, aucune somme possible. Créez le modèle avant d'envoyer les données.
curl -sk -u 'admin:Str0ng!Passw0rd-2026' -H 'Content-Type: application/json' -X PUT https://localhost:9200/_index_template/web_logs -d '{
  "index_patterns": ["web-logs*"],
  "template": {
    "settings": {"number_of_shards": 1, "number_of_replicas": 0},
    "mappings": {"properties": {
      "@timestamp": {"type": "date"},
      "clientip": {"type": "ip"},
      "verb": {"type": "keyword"},
      "request": {"type": "keyword"},
      "response": {"type": "integer"},
      "bytes": {"type": "integer"}
    }}
  }
}'
Traces OpenTelemetry #
Data Prepper reçoit l'OTLP sur des ports dédiés : 21890 pour les traces, 21891 pour les métriques et 21892 pour les logs. Pour les traces, deux index alimentent la vue Trace Analytics de la console. Ce pipeline provient de la documentation officielle, et nous ne l'avons pas exécuté :
entry-pipeline:
  source:
    otel_trace_source:
      ssl: false
  sink:
    - pipeline:
        name: raw-trace-pipeline
    - pipeline:
        name: service-map-pipeline
raw-trace-pipeline:
  source:
    pipeline:
      name: entry-pipeline
  processor:
    - otel_traces:
  sink:
    - opensearch:
        hosts: ["https://opensearch:9200"]
        insecure: true
        username: admin
        password: "<mot-de-passe>"
        index_type: trace-analytics-raw
service-map-pipeline:
  source:
    pipeline:
      name: entry-pipeline
  processor:
    - service_map:
  sink:
    - opensearch:
        hosts: ["https://opensearch:9200"]
        insecure: true
        username: admin
        password: "<mot-de-passe>"
index_type: trace-analytics-service-mapMi seguimiento
Inicia sesión para seguir tu progreso y tomar notas. Iniciar sesión
Artículos recomendados
Ingestion Elasticsearch : Bulk API, ingest pipelines, enrich et reindex
Ingérer et transformer des données dans Elasticsearch : Bulk API, ingest pipelines et processeurs...
OpenSearch : concepts, architecture et différences avec Elasticsearch
Comprendre OpenSearch : origine du projet, licence, différences avec Elasticsearch, index, shards...
OpenSearch Dashboards, alertes et observabilité
Explorer ses données dans OpenSearch Dashboards, créer des moniteurs d'alerte et découvrir Trace ...
Indexer et chercher dans OpenSearch : mapping, DSL, PPL et SQL
Déclarer un modèle d'index, indexer avec bulk, chercher avec le Query DSL, agréger et interroger ...
OpenSearch en production : ISM, sauvegardes, sécurité et bonnes pratiques
Automatiser le cycle de vie avec ISM, sauvegarder par snapshots, gérer les rôles et dimensionner ...
Installer OpenSearch et OpenSearch Dashboards
Installer OpenSearch avec Docker Compose ou l'archive : mot de passe initial, vm.max_map_count, c...
Logs dans Datadog : collecte, pipelines, index et maîtrise du volume
Collecter les logs avec l'agent, les structurer avec pipelines et processeurs (grok), utiliser fa...
Bonnes pratiques Logstash : pipelines, performances, fiabilité et supervision
Bonnes pratiques Logstash : pipelines multiples, dissect plutôt que grok, conditionnels, persiste...
Les Data Sources dans Grafana : Connectez et unifiez vos données
Apprenez à étendre les capacités de Grafana via les Data Sources. Découvrez les plugins essentiel...