Este artículo está disponible en francés.
1. Pourquoi corréler #
Le temps de diagnostic est le vrai coût d'un incident.
Sans et avec corrélation #
Sans corrélation, l'ingénieur d'astreinte voit un pic d'erreurs dans un tableau de bord, cherche des logs autour de la même heure, devine quel service est en cause, puis cherche une trace « qui ressemble ». Avec des signaux corrélés, chaque étape est un clic, sur des données qui concernent la même requête.

2. Les mécanismes de corrélation #
Ce qu'il faut mettre en place.
Vue d'ensemble #
| Lien | Mécanisme | À vérifier |
|---|---|---|
| Tous les signaux d'un service | ressource identique (service.name, service.version, deployment.environment.name, k8s.pod.name) | même SDK ou mêmes variables pour tous les signaux ; k8sattributes dans le Collector |
| Log → trace | trace_id et span_id dans chaque log | appender OTel ou ajout dans le format JSON |
| Métrique → trace | exemplars avec trace_id | exemplars activés dans le SDK et stockés par le backend (Prometheus --enable-feature=exemplar-storage) |
| Trace → métriques | span metrics et service graph calculés depuis les spans | connecteurs spanmetrics, servicegraph ou générateur de métriques de Tempo |
| Trace → profil | échantillons étiquetés avec le span_id | SDK de profilage avec span processor |
| Contexte métier | baggage propagé (tenant.id, shop.customer.tier) | processor qui copie le baggage en attributs |
Une ressource partagée #
# Les mêmes variables pour tous les signaux d'un service
export OTEL_SERVICE_NAME=checkout
export OTEL_RESOURCE_ATTRIBUTES=service.namespace=shop,service.version=1.4.0,deployment.environment.name=production
export OTEL_TRACES_EXPORTER=otlp OTEL_METRICS_EXPORTER=otlp OTEL_LOGS_EXPORTER=otlp
Erreur Courante : Si les traces disentcheckoutet les logscheckout-api, aucune navigation automatique ne fonctionne. Le nom du service est la clé de toute la corrélation.
3. Configurer Grafana #
Les liens entre sources de données.
Provisioning des sources #
apiVersion: 1
datasources:
  - name: Tempo
    type: tempo
    uid: tempo
    url: http://tempo:3200
    jsonData:
      tracesToLogsV2:
        datasourceUid: loki
        filterByTraceID: true
        spanStartTimeShift: -5m
        spanEndTimeShift: 5m
      tracesToMetrics: { datasourceUid: prometheus }
      tracesToProfiles: { datasourceUid: pyroscope, profileTypeId: "process_cpu:cpu:nanoseconds:cpu:nanoseconds" }
      serviceMap: { datasourceUid: prometheus }
  - name: Loki
    type: loki
    uid: loki
    url: http://loki:3100
    jsonData:
      derivedFields:
        - { name: TraceID, matcherRegex: '"trace_id":"(\w+)"', url: "$${__value.raw}", datasourceUid: tempo }
  - name: Prometheus
    type: prometheus
    uid: prometheus
    url: http://prometheus:9090
    jsonData:
      exemplarTraceIdDestinations: [{ name: trace_id, datasourceUid: tempo }]
Le parcours type #
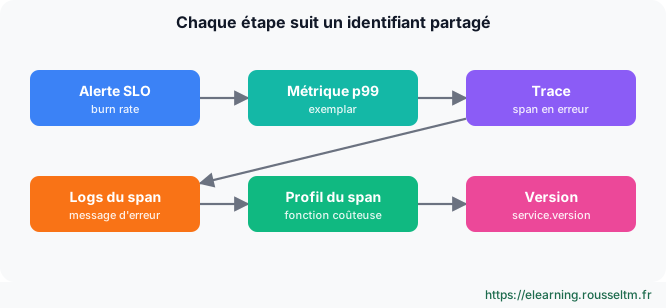
- L'alerte de burn rate se déclenche sur le SLO de latence.
- Le panneau de latence p99 affiche des exemplars : on clique sur le plus haut.
- La trace s'ouvre : le span
paymentdure 2 s et finit en erreur. - « Logs for this span » affiche le log
connection pool exhausted. - « Profiles for this span » montre le temps passé à attendre le pool.
- La version (
service.version) montre que le problème est apparu avec le dernier déploiement.
4. Baggage et contexte métier #
Corréler aussi avec le métier.
Utiliser le baggage #
from opentelemetry import baggage, context
ctx = baggage.set_baggage("shop.customer.tier", "premium")
token = context.attach(ctx)        # propagé aux services appelés (en-tête baggage)
try:
    appeler_paiement()
finally:
    context.detach(token)
Dans les SDK et le Collector, un span processor peut copier certaines clés du baggage en attributs de span pour filtrer « toutes les traces lentes des clients premium ».
Erreur Courante : Le baggage voyage en clair dans les en-têtes HTTP, y compris vers des services tiers : n'y mettez jamais de données sensibles et filtrez-le en sortie du système.
Mi seguimiento
Inicia sesión para seguir tu progreso y tomar notas. Iniciar sesión
💬 Debates recientes del curso
- Quels attributs utiliser pour nommer mes spans HTTP (semconv) ?✓ resuelto · 1 respuesta(s)
- OpenTelemetry Collector : mes traces arrivent mais pas mes métriques✓ resuelto · 2 respuesta(s)
Hacer una pregunta sobre esta lección →Ver todos los debates del curso
Artículos recomendados
Corréler traces, logs, métriques et profils dans Grafana
Relier Tempo aux logs (Loki), aux métriques (Prometheus) et aux profils (Pyroscope) : tracesToLog...
Les profils, le quatrième signal d'OpenTelemetry : profilage continu et corrélation avec les traces
Comprendre le nouveau signal profile d'OpenTelemetry : profilage continu, flame graphs, modèle de...
Les logs avec OpenTelemetry : modèle de données, appenders, corrélation et collecte
Maîtriser le signal log : modèle de données LogRecord, Logs Bridge API et appenders (Logback, Log...
Tempo : générer des métriques à partir des traces (service graph, span metrics, exemplars)
Activer le metrics-generator de Tempo : service graphs, span metrics RED, remote write vers Prome...
Relier traces et profils : span profiles avec Tempo et Pyroscope
Passer d'une trace lente au profil CPU exact de ce span : span profiles en Go et Java, configurat...
Les métriques OpenTelemetry : instruments, temporalité, histogrammes et exemplars
Maîtriser le signal métrique : MeterProvider, instruments synchrones et asynchrones (Counter, UpD...
Projet fil rouge : les quatre signaux de l'OpenTelemetry Demo dans la stack Grafana
Un projet fil rouge qui traverse les formations d'observabilité : déployer l'OpenTelemetry Demo, ...
APM Datadog et OpenTelemetry : traces, services et corrélation avec les logs
Instrumenter ses applications pour l'APM Datadog (dd-trace, instrumentation en une étape, OpenTel...
Tracing distribué : la propagation du contexte (W3C Trace Context et baggage)
Comprendre et mettre en œuvre la propagation de contexte OpenTelemetry : en-tête traceparent, tra...