1. L'API REST #
Tout ce que fait l'interface.
Le parcours #
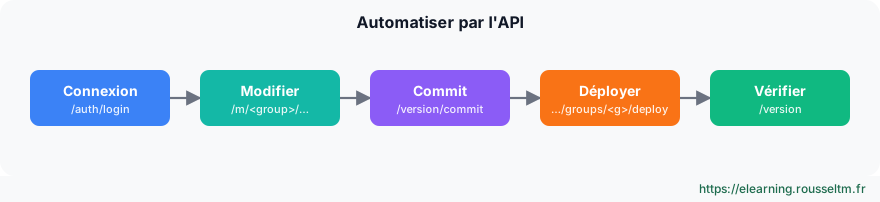
CRIBL=http://localhost:19000
TOKEN=$(curl -s -X POST $CRIBL/api/v1/auth/login -H 'Content-Type: application/json' \
  -d '{"username":"admin","password":"'"$CRIBL_PASSWORD"'"}' | jq -r .token)
H=(-H "Authorization: Bearer $TOKEN" -H 'Content-Type: application/json')

curl -s "${H[@]}" $CRIBL/api/v1/m/default/system/outputs | jq -r '.items[].id'
curl -s "${H[@]}" $CRIBL/api/v1/m/default/routes | jq '.items[0].routes[] | {name, filter, output}'

COMMIT=$(curl -s "${H[@]}" -X POST $CRIBL/api/v1/version/commit \
  -d '{"message":"ci: nouvelle destination archive","group":"default"}' | jq -r '.items[0].commit')
curl -s "${H[@]}" -X PATCH $CRIBL/api/v1/products/stream/groups/default/deploy -d "{\"version\":\"$COMMIT\"}"
curl -s "${H[@]}" -X POST $CRIBL/api/v1/version/commit -d '{"message":"sync leader"}' >/dev/null
POST /api/v1/auth/loginrenvoie un jeton à passer enAuthorization: Bearer.- Les ressources d'un groupe se trouvent sous
/api/v1/m/<groupe>/(system/inputs,system/outputs,pipelines,routes). - Commit du groupe, déploiement avec le hash obtenu, puis commit du Leader pour garder les deux synchronisés.
À savoir : Le chemin de déploiement/api/v1/master/groups/…/deploydes anciennes documentations est remplacé par/api/v1/products/stream/groups/…/deploy; sur Cribl.Cloud, l'adresse est celle de l'espace de travail et l'authentification passe par un client API.
2. Les Packs #
Réutiliser et partager.
Principe #
- Un Pack regroupe routes, pipelines, tables de correspondance et échantillons, avec sa propre table de routage interne.
- On l'utilise comme un pipeline (dans une route ou QuickConnect), on l'exporte en fichier
.crblet on l'importe dans un autre groupe ou environnement. - Le Cribl Packs Dispensary propose des Packs prêts à l'emploi (Palo Alto, Windows, AWS, Cisco…) : point de départ utile, à relire et adapter.
Bonne Pratique : Un Pack par source ou par fournisseur, versionné : c'est la meilleure façon de livrer la même logique en recette puis en production.
3. Git, environnements et Terraform #
Configuration as code.
Les options #
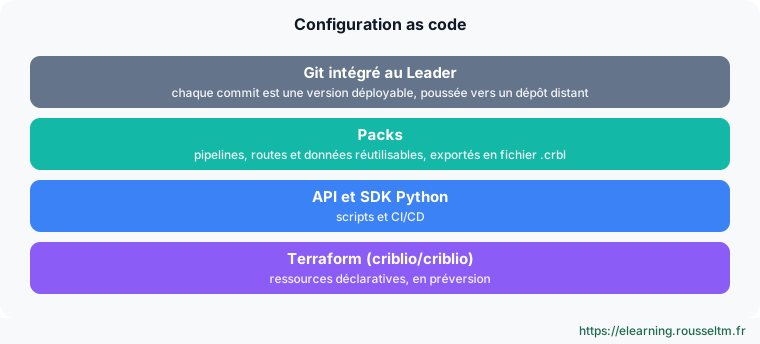
- Git intégré : chaque commit du Leader est versionné ; poussez vers un dépôt distant et protégez la branche.
- Environnements : groupes séparés (ou déploiements séparés) pour recette et production, avec promotion par Pack, API ou Terraform.
- Terraform : fournisseur officiel
criblio/criblio, encore en préversion, avec un exportateur pour migrer une configuration existante. - SDK : le SDK Python reste disponible ; les SDK TypeScript et Go de « Cribl as Code » sont abandonnés depuis la version 4.20.
terraform {
  required_providers {
    criblio = { source = "criblio/criblio", version = "~> 1.25" }
  }
}
# Ressources et authentification : voir la documentation du fournisseur (préversion)
Attention : Le fournisseur Terraform est en préversion : fixez sa version et testez chaque montée de version en recette.
Copilot #
Cribl Copilot aide à écrire des expressions, construire des pipelines et rédiger des recherches. Depuis la version 4.20, on peut le faire passer par son propre fournisseur d'IA ; un administrateur peut désactiver le widget de discussion indépendamment des autres fonctions IA. Relisez toujours ce qu'il propose avant de déployer.
Commandes à connaître #
Commandes à connaître
POST /api/v1/auth/login: obtenir un jetonGET /api/v1/m/default/system/outputs: lister les destinations du groupePOST /api/v1/version/commit: valider une versionPATCH /api/v1/products/stream/groups/default/deploy: déployer sur un groupesource = "criblio/criblio": fournisseur Terraform officiel
Sources #
Vérifié en novembre 2026 (Cribl 4.20) : Cribl publie une version mineure environ tous les deux mois, consultez les notes de version avant de vous appuyer sur un détail.
Mon suivi
Connectez-vous pour suivre votre progression et prendre des notes. Se connecter
💬 Questions sur cette leçon
Aucune question pour l'instant : soyez le premier à demander de l'aide ou à partager votre configuration.
Articles recommandés
Pipelines et fonctions : parser, enrichir, masquer
Construire des pipelines Cribl Stream : pré-traitement, traitement et post-traitement, catalogue ...
Synthetic Monitoring as Code : Industrialisez la gestion des scénarios synthétiques
Découvrez comment intégrer le Synthetic Monitoring dans vos pipelines CI/CD pour des tests de per...
Terraform en CI/CD : pipelines, revue du plan, OIDC et GitOps
Automatiser Terraform : pipeline plan sur demande de fusion et apply après approbation, publicati...
Automatiser Grafana : API HTTP, Terraform et cycle de vie des dashboards
Industrialiser Grafana : API HTTP (dossiers, dashboards, utilisateurs, sources), fournisseur Terr...
Bindplane en production : haute disponibilité, sécurité, Kubernetes et configuration as code
Exploiter Bindplane en production : serveurs actifs-actifs, PostgreSQL et bus d'événements, TLS p...
Bonnes pratiques Bindplane
Check-list pour exploiter Bindplane : organisation par labels et fleets, réduction mesurée, masqu...
Monitors, SLO, dashboards et Datadog as code
Créer des monitors efficaces (métriques, logs, APM, composites, anomalies), des SLO, des dashboar...
Infrastructure as Code sur Azure : Bicep, Terraform, Cost Management et Well-Architected
Décrire et déployer Azure en code avec Bicep (modules, paramètres, what-if, déploiements par pipe...
Bonnes pratiques Datadog : tags, coûts, alertes et gouvernance
Check-list pour exploiter Datadog efficacement : tagging unifié, maîtrise des coûts (hôtes, logs,...