1. Les entrées #
Recevoir les données.
Les inputs courants #
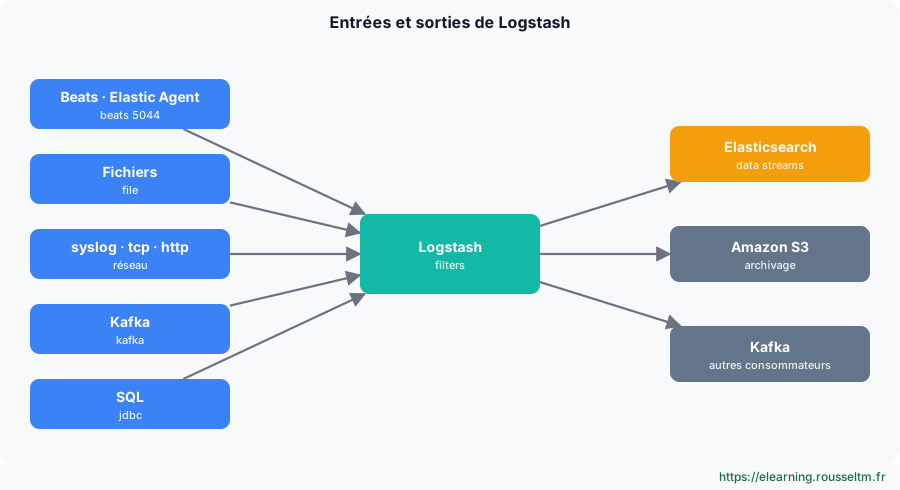
| Input | Usage | Option clé |
|---|---|---|
| beats / elastic_agent | recevoir Beats et Elastic Agent | port => 5044, ssl_enabled |
| file | lire des fichiers locaux | path, start_position, sincedb_path |
| tcp / udp / syslog | flux réseau | port, codec |
| http | recevoir des webhooks | port, codec => json |
| kafka | consommer des topics | bootstrap_servers, topics, group_id |
| jdbc | interroger une base SQL | statement, schedule, tracking_column |
input {
  beats { port => 5044 }
  file  { path => "/var/log/app/*.log" start_position => "beginning" }
  jdbc  {
    jdbc_connection_string => "jdbc:postgresql://db:5432/app"
    jdbc_user => "lecture"
    jdbc_driver_class => "org.postgresql.Driver"
    schedule => "*/5 * * * *"
    statement => "SELECT * FROM commandes WHERE maj > :sql_last_value"
    use_column_value => true
    tracking_column => "maj"
    tracking_column_type => "timestamp"
  }
}
À savoir : Le codec décode les données à l'entrée (json,multiline,plain) ou les encode à la sortie.
2. Les sorties #
Envoyer les données.
La sortie elasticsearch #
output {
  elasticsearch {
    hosts => ["https://es1:9200", "https://es2:9200"]
    api_key => "${ES_API_KEY}"
    ssl_certificate_authorities => ["/etc/logstash/ca.crt"]
    data_stream => true
    data_stream_type => "logs"
    data_stream_dataset => "app"
    data_stream_namespace => "prod"
  }
}
Bonne pratique : Écrivez dans des data streams (logs-app-prod) plutôt que dans des index datés : rotation, rétention ILM et modèles d'index sont alors gérés par Elasticsearch.Autres sorties #
| Output | Usage |
|---|---|
| stdout { codec => rubydebug } | mise au point |
| file | copie locale |
| s3 | archivage long terme bon marché |
| kafka | alimenter d'autres consommateurs |
| pipeline | envoyer vers un autre pipeline Logstash |
Erreur courante : Mettre le mot de passe Elasticsearch en clair dans le fichier de pipeline : utilisez le keystore (bin/logstash-keystore add ES_API_KEY) et référencez la valeur par${ES_API_KEY}.
