1. Enrichir #
Ajouter du contexte.
Les filtres d'enrichissement #
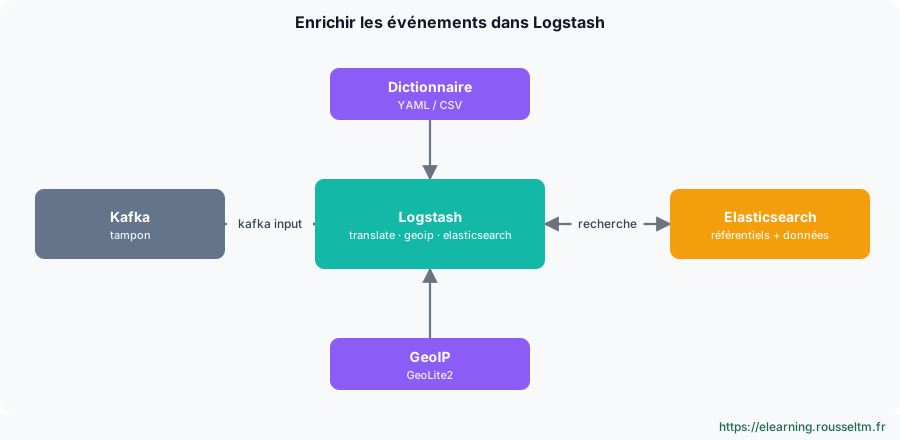
filter {
  translate {
    source => "[http][response][status_code]"
    target => "[http][response][status_label]"
    dictionary => { "200" => "ok" "404" => "introuvable" "500" => "erreur serveur" }
    fallback => "autre"
  }
  geoip { source => "[source][ip]" target => "[source]" }
  elasticsearch {
    hosts => ["https://es:9200"]
    index => "referentiel-serveurs"
    query => "host.name:%{[host][name]}"
    fields => { "equipe" => "[labels][equipe]" }
  }
}| Filtre | Source | Attention |
|---|---|---|
| translate | dictionnaire en ligne ou fichier (rechargé) | idéal pour les petites tables |
| geoip | bases GeoLite2 téléchargées automatiquement | hors ligne : fournir la base avec database |
| elasticsearch | requête par événement | coûteux : à réserver aux faibles volumes |
| jdbc_static / jdbc_streaming | base relationnelle | jdbc_static met en cache localement |
2. Kafka #
Découpler la collecte.
Consommer un topic #
input {
  kafka {
    bootstrap_servers => "kafka-1:9092,kafka-2:9092"
    topics => ["logs-web"]
    group_id => "logstash-web"
    consumer_threads => 3      # au plus le nombre de partitions
    codec => json
  }
}
Kafka absorbe les pics et les arrêts de Logstash ou d'Elasticsearch : les collecteurs écrivent toujours, Logstash rattrape son retard. Plusieurs instances Logstash du même group_id se partagent les partitions.
3. Tester ses pipelines #
Avant la production.
Vérifier la syntaxe et le comportement #
bin/logstash -f web.conf --config.test_and_exit      # syntaxe
bin/logstash -f web.conf --config.reload.automatic   # rechargement à chaud en développement
echo '127.0.0.1 - - [09/Nov/2026:10:00:00 +0100] "GET / HTTP/1.1" 200 512' | bin/logstash -f web.conf
Bonne pratique : Gardez des lignes de log réelles comme jeux d'essai et une sortiestdout { codec => rubydebug }en développement ; surveillez les tags_grokparsefailureet_dissectfailureen production.
4. Superviser #
API et Stack Monitoring.
Les sources #
- L'API de supervision (port 9600) :
_node/stats,_node/stats/pipelines,_node/hot_threads. - L'intégration Logstash d'Elastic Agent alimente Stack Monitoring dans Kibana (débit, latence, file, JVM) ; l'ancienne collecte interne
xpack.monitoringest dépréciée. - La gestion centralisée des pipelines depuis Kibana existe, selon la licence.
Selon la version : la collecte interne de supervision est dépréciée depuis la 8.x ; privilégiez Elastic Agent et l'intégration Logstash.
5. Logstash sur Kubernetes #
Avec ECK.
La ressource Logstash #
apiVersion: logstash.k8s.elastic.co/v1alpha1
kind: Logstash
metadata:
  name: logstash
spec:
  count: 2
  version: 9.1.0
  elasticsearchRefs:
    - name: elasticsearch
      clusterName: prod
  pipelines:
    - pipeline.id: main
      config.string: |
        input { beats { port => 5044 } }
        output {
          elasticsearch {
            hosts => [ "${PROD_ES_HOSTS}" ]
            user => "${PROD_ES_USER}"
            password => "${PROD_ES_PASSWORD}"
            ssl_certificate_authorities => "${PROD_ES_SSL_CERTIFICATE_AUTHORITY}"
          }
        }
  services:
    - name: beats
      service:
        spec:
          type: ClusterIP
          ports: [{ port: 5044, name: beats, protocol: TCP, targetPort: 5044 }]
À savoir : ECK injecte l'adresse, l'utilisateur et le certificat du cluster référencé sous forme de variables (PROD_ES_*pourclusterName: prod) et crée un volume persistant pour les données (PQ, DLQ).
6. Logstash ou ingest pipeline ? #
Choisir où transformer.
Comparatif #
| Critère | Logstash | Ingest pipeline |
|---|---|---|
| Sources | très nombreuses (Kafka, JDBC, S3, syslog…) | ce qui arrive dans Elasticsearch |
| Sorties | multiples (Elasticsearch, S3, Kafka…) | Elasticsearch |
| Exploitation | un service de plus à opérer | intégré au cluster |
| Cas typique | routage, multi-destinations, tampon | intégrations Elastic Agent, parsing simple |
