1. Fleet Management et remotecfg #
Configurer à distance.
Le principe #
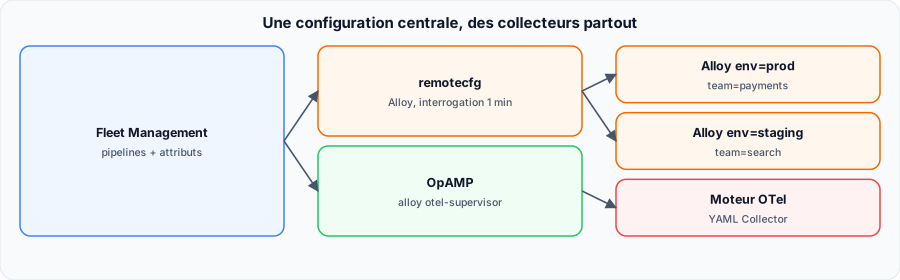
Mettre à jour la configuration de 300 Alloy un par un ne tient pas. Avec Fleet Management (Grafana Cloud, ou en auto-hébergé pour les offres entreprise), vous créez des pipelines associés à des attributs ; chaque Alloy interroge le service grâce au bloc remotecfg et applique les pipelines qui correspondent à ses attributs. L'inventaire montre la santé, la version et les attributs de chaque collecteur.
config.alloy #
remotecfg {
  url            = sys.env("GCLOUD_FLEET_URL")
  id             = constants.hostname
  attributes     = {"env" = "production", "team" = "payments"}
  poll_frequency = "1m"

  basic_auth {
    username = sys.env("GCLOUD_FLEET_USER")
    password = sys.env("GCLOUD_RW_API_KEY")
  }
}
Configuration validée avec alloy validate (Alloy v1.21.3, novembre 2026).
id: identifiant du collecteur ; sans lui, Alloy génère un UUID conservé dansalloy_seed.json.attributes: servent à choisir les pipelines ; le préfixecollector.est réservé (collector.osetcollector.versionsont ajoutés automatiquement).poll_frequency: 1 min par défaut, 10 s minimum.- Le protocole alloy-remote-config est libre (Apache 2.0) : vous pouvez implémenter votre propre serveur.
Gardez une configuration locale minimale (le bloc remotecfg et l'auto-supervision) : si le service est injoignable, Alloy continue avec la dernière configuration reçue.2. Kubernetes Monitoring #
Le chart Helm k8s-monitoring.
Plusieurs Alloy spécialisés #
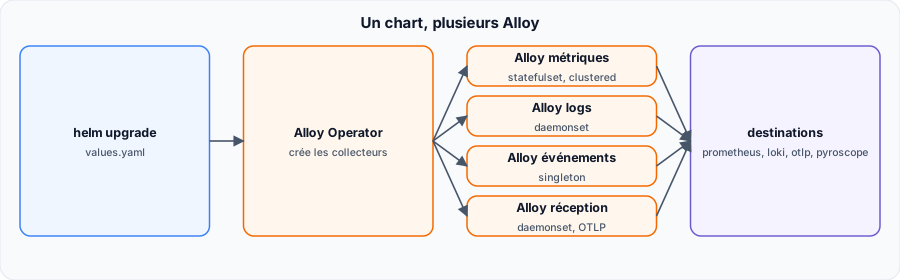
Le chart Helm k8s-monitoring (version 4 et suivantes) déploie, via l'Alloy Operator, plusieurs Alloy aux rôles distincts. En v4, vous nommez vous-même les collecteurs (collectors) et leur appliquez des presets ; chaque fonctionnalité (clusterMetrics, podLogs, applicationObservability, autoInstrumentation…) est rattachée à un collecteur, et les destinations sont typées par protocole (prometheus, loki, otlp, pyroscope).
| Collecteur | Presets | Rôle |
|---|---|---|
| Métriques | clustered, statefulset | kubelet, cAdvisor, kube-state-metrics, ServiceMonitor |
| Événements | singleton | Événements du cluster (une seule instance) |
| Logs | filesystem-log-reader, daemonset | Logs des pods et des nœuds |
| Réception | daemonset | OTLP poussé par les applications |
| Profils | privileged, daemonset | Profilage continu |
helm repo add grafana https://grafana.github.io/helm-charts
helm upgrade --install k8s-monitoring grafana/k8s-monitoring \
  --namespace monitoring --create-namespace -f values.yaml
L'option autoInstrumentation déploie aussi Beyla en DaemonSet. Le format de values.yaml a changé entre les versions majeures : partez de l'assistant de Grafana Cloud ou des exemples du dépôt du chart.
3. Le moteur OpenTelemetry #
Une configuration Collector dans Alloy.
alloy otel #
Vous avez déjà des configurations YAML de l'OpenTelemetry Collector ? Le moteur OTel d'Alloy (en préversion publique) les exécute telles quelles, sans les traduire en syntaxe Alloy. Avec alloy otel-supervisor, un superviseur OpAMP intégré laisse Fleet Management piloter cette configuration à distance.
alloy otel --config otelcol.yaml
alloy convert --source-format=otelcol --output=config.alloy otelcol.yaml # ou convertir vers la syntaxe Alloy| Besoin | Choix |
|---|---|
| Nouvelle configuration, composants Grafana (faro, beyla, clustering) | Moteur par défaut (syntaxe Alloy) |
| Reprendre un parc d’OpenTelemetry Collector existant | Moteur OTel + OpAMP |
Sources #
Mon suivi
Connectez-vous pour suivre votre progression et prendre des notes. Se connecter
💬 Discussions récentes de la formation
- Alloy : recevoir de l'OTLP et l'envoyer vers Tempo et Mimir✓ résolu · 1 réponse(s)
Poser une question sur cette leçon →Voir toutes les discussions de la formation
Glossaire de la formation
Observabilité
La capacité à connaître l'état interne d'un système à partir des données qu'il émet.Ces données sont classées en 3 piliers : logsmétriquestracesprofil...
Traces distribuées
Technique (issue du pilier des Traces) permettant de suivre le cheminement complet d'une requête à travers de multiples micro-services pour identifier...
Métriques
Mesures numériques collectées à intervalles réguliers (ex: CPU, RAM, temps de réponse) utilisées pour évaluer l'état de santé global d'un système au f...
Profilage en continu (Continuous Profiling)
Analyse constante de l'exécution du code en production pour identifier avec précision quelles lignes de code ou fonctions consomment le plus de ressou...
Access Log
Fichier de journalisation enregistrant les requêtes traitées par un serveur web (Apache, Nginx, Lighttpd, etc.). Il permet de tracer l'activité du ser...
Client IP
L'adresse IP de l'utilisateur effectuant la requête vers le serveur web. Lorsqu'un utilisateur passe par un Load Balancer ou un proxy (ex: Cloudflare)...
Timestamp
La date et l'heure exactes auxquelles la requête a été reçue par le serveur.Configuration : %t dans Apache, $time_local ou $time_iso8601 dans Nginx.
Request
La ligne de requête initiale du client. Elle comprend généralement la méthode HTTP (ex: GET), l'URL demandée et la version du protocole HTTP.Configura...
Status Code
Le code de statut HTTP final renvoyé par le serveur au client (ex : 200 pour un succès, 404 pour ressource non trouvée).Configuration : %>s dans Apach...
Size
Le volume des données renvoyées au client, mesuré en octets (généralement sans les en-têtes HTTP).Configuration : %b ou %O dans Apache, $body_bytes_se...
Referrer
L'URL de la page web depuis laquelle le client a cliqué ou suivi un lien pour accéder à la ressource actuelle.Configuration : %{Referer}i dans Apache,...
User-Agent
Les informations d'identification fournies par le client concernant son navigateur, son système d'exploitation et son appareil. Sa structure standard ...
Response Time
La durée totale prise par le serveur pour traiter la requête et renvoyer la réponse au client.Configuration : %D (microsecondes) ou %T (secondes) dans...
Grafana Alloy
Collecteur de télémétrie open source et flexible, successeur de Grafana Agent. Il est conçu pour collecter, transformer et exporter des logs, métrique...
River
Langage de configuration déclaratif utilisé par Grafana Alloy, inspiré de HCL (Terraform). Il permet de définir des pipelines de télémétrie complexes ...
Grafana Loki
Système de journalisation (logs) multi-tenant, hautement disponible et inspiré de Prometheus. Il est conçu pour être très économe en ressources en n'i...
Articles recommandés
Alloy et l'écosystème Grafana Labs : quel composant pour quel outil ?
La carte des intégrations d'Alloy avec Faro, Beyla, k6, Loki, Mimir, Tempo, Pyroscope, Database O...
Fleet Management dans Grafana Cloud
Piloter à distance la configuration de nombreux collecteurs Alloy.
Fleet Management dans Dynatrace
Inventorier, installer et diagnostiquer OneAgent et ActiveGate à grande échelle.
Bonnes Pratiques Grafana Alloy : Optimiser sa Collecte de Télémétrie
Découvrez les règles d'or pour configurer Grafana Alloy de manière robuste : modularité, gestion ...
Faro et Alloy : recevoir le RUM front-end avec faro.receiver
Configurer faro.receiver : CORS, clé d'API, limite de débit, source maps, puis envoyer erreurs, W...
Variables d'environnement de Grafana Alloy : GOMEMLIMIT, sys.env et OTEL_RESOURCE_ATTRIBUTES
Quelles variables Grafana Alloy lit-il vraiment ? GOMEMLIMIT, HTTP_PROXY, sys.env, OTEL_RESOURCE_...
Grafana Alloy : L'importance de l'auto-supervision (Self-Monitoring)
Découvrez pourquoi et comment configurer Grafana Alloy pour qu'il se supervise lui-même, en colle...
OpenTelemetry Collector, Grafana Alloy et Bindplane : comparer trois approches des pipelines de télémétrie
Comparatif détaillé de trois façons de gérer des pipelines de télémétrie : l'OpenTelemetry Collec...
La stack LGTM (Loki, Grafana, Tempo, Mimir) : architecture et mise en place
Comprendre la stack LGTM de Grafana Labs : Loki pour les logs, Grafana pour la visualisation, Tem...