1. Les sources #
Ce que l'interface interroge.
Le principe #
Disponible dans : ✓ Open source ✓ Managed ClickStack
Une source décrit une table ClickHouse et la façon de la lire : colonne de temps, corps du message, niveau, nom du service, identifiants de trace. ClickStack crée les sources par défaut au premier compte ; on peut en ajouter pour toute table ClickHouse, y compris vos propres données.
| Source | Table | Usage |
|---|---|---|
| Logs | otel_logs | recherche, suivi en direct, graphiques |
| Traces | otel_traces | recherche de spans, cascade, latence |
| Métriques | otel_metrics_gauge, _sum, _histogram… | graphiques et dashboards |
| Sessions | hyperdx_sessions | rejeu des sessions navigateur |
Bonne Pratique : Reliez les sources entre elles (logs ↔ traces ↔ sessions) dans leurs réglages : c'est ce qui active les liens de corrélation dans l'interface.
2. Chercher #
Propriétés, plein texte ou SQL.
Syntaxe de recherche #
| Recherche | Trouve |
|---|---|
timeout | les événements dont le corps contient « timeout » |
"connection refused" | l'expression exacte |
level:err | niveau d'erreur (propriété) |
service:checkout level:err | les deux conditions (ET implicite) |
service:checkout OR service:payments | l'une ou l'autre |
-level:info / NOT level:info | exclure |
http.status_code:500 | un attribut (clé de la colonne Map) |
Le mode SQL accepte une condition WHERE directement : SeverityText = 'error' AND LogAttributes['http.route'] LIKE '/api/%'. Pratique pour les fonctions de ClickHouse (expressions régulières, comparaisons numériques).
Explorer les résultats #
- Suivi en direct (live tail) : les nouveaux événements défilent pendant un déploiement ou un test.
- Histogramme du nombre d'événements dans le temps : cliquez-glissez pour zoomer sur un pic.
- Colonnes : ajoutez un attribut comme colonne, filtrez sur une valeur d'un clic depuis le détail d'un événement.
- Recherches enregistrées : réutilisables, partageables, et base des alertes.
3. Traces, logs et sessions #
Corréler les signaux.
Le parcours #
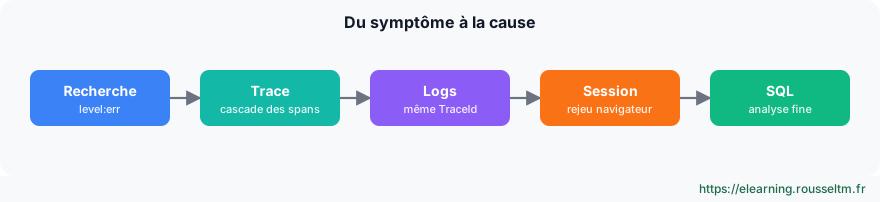
- Trace : la cascade montre chaque span, sa durée et ses attributs ; les logs émis pendant chaque span sont affichés à côté.
- Du log à la trace : un log qui porte un
TraceIdouvre la trace complète de la requête. - De la trace à la session : si le SDK navigateur est en place, la session de l'utilisateur, son parcours et son rejeu.
Une enquête type #
- Une alerte signale des erreurs : recherchez
service:checkout level:errsur la dernière heure. - L'histogramme montre le début du problème ; le détail d'un log donne l'attribut
http.routeen cause. - Ouvrez la trace : le span le plus long est un appel à la base de données qui expire.
- La session montre l'action de l'utilisateur et le message d'erreur affiché.
- Mesurez l'ampleur en SQL (nombre d'utilisateurs touchés) avant de communiquer.
4. Aller plus loin en SQL #
Quand l'interface ne suffit plus.
Requêtes utiles #
-- Utilisateurs distincts touchés par l'erreur sur la dernière heure
SELECT uniq(LogAttributes['user.id']) AS utilisateurs
FROM otel_logs
WHERE ServiceName = 'checkout' AND SeverityText ILIKE 'err%' AND Timestamp > now() - INTERVAL 1 HOUR;

-- Routes les plus lentes (p95) à partir des traces
SELECT SpanAttributes['http.route'] AS route, quantile(0.95)(Duration) / 1e6 AS p95_ms, count() AS appels
FROM otel_traces
WHERE ServiceName = 'checkout' AND SpanKind = 'Server' AND Timestamp > now() - INTERVAL 1 HOUR
GROUP BY route ORDER BY p95_ms DESC LIMIT 10;
À savoir : En Managed ClickStack, des notebooks assistés par l'IA aident à écrire ces analyses ; vérifiez toujours la requête générée avant de vous fier au résultat.
Commandes à connaître #
Commandes à connaître
service:checkout level:err: recherche par propriétés"connection refused": expression exacte-level:info: exclusionLogAttributes['http.route']: lire un attribut en SQLquantile(0.95)(Duration) / 1e6: latence p95 en millisecondes
Sources #
Vérifié en novembre 2026 : ClickStack évolue vite (Managed ClickStack est en bêta), consultez la documentation de ClickHouse avant de vous appuyer sur un détail.
Mon suivi
Connectez-vous pour suivre votre progression et prendre des notes. Se connecter
💬 Questions sur cette leçon
Aucune question pour l'instant : soyez le premier à demander de l'aide ou à partager votre configuration.
Articles recommandés
Exploiter une plateforme d'observabilité sur ClickHouse et choisir son outil
Exploiter ClickHouse pour la télémétrie (réplication, disques, fusions, stockage objet, supervisi...
Utiliser SigNoz : APM, traces, logs, dashboards et alertes
Exploiter SigNoz au quotidien : vue APM des services, explorateur de traces et de logs, query bui...
Analyser des traces dans l'interface de Jaeger
Rechercher des traces, lire une chronologie, repérer le chemin critique, comparer deux traces, ut...
Explorer ses données dans OpenObserve : SQL, PromQL et VRL
Chercher en SQL, interroger les métriques en PromQL, optimiser un flux (index, partitions, rétent...
Les profils, le quatrième signal d'OpenTelemetry : profilage continu et corrélation avec les traces
Comprendre le nouveau signal profile d'OpenTelemetry : profilage continu, flame graphs, modèle de...
Les logs avec OpenTelemetry : modèle de données, appenders, corrélation et collecte
Maîtriser le signal log : modèle de données LogRecord, Logs Bridge API et appenders (Logback, Log...
Les traces OpenTelemetry en profondeur : spans, statuts, événements, liens et échantillonnage
Maîtriser le signal trace : anatomie d'une trace distribuée, span et SpanKind, attributs, statut ...
Corréler traces, métriques, logs et profils avec OpenTelemetry
Relier les quatre signaux pour diagnostiquer vite : ressource commune, trace_id dans les logs, ex...
Le trilemme de l'observabilité : coût, exhaustivité et performance, et comment les solutions le résolvent
Comprendre le trilemme de l'observabilité (coût, exhaustivité des données, performance des requêt...