1. Le trilemme en bref #
Trois qualités souhaitées, deux à la fois.
Définition #
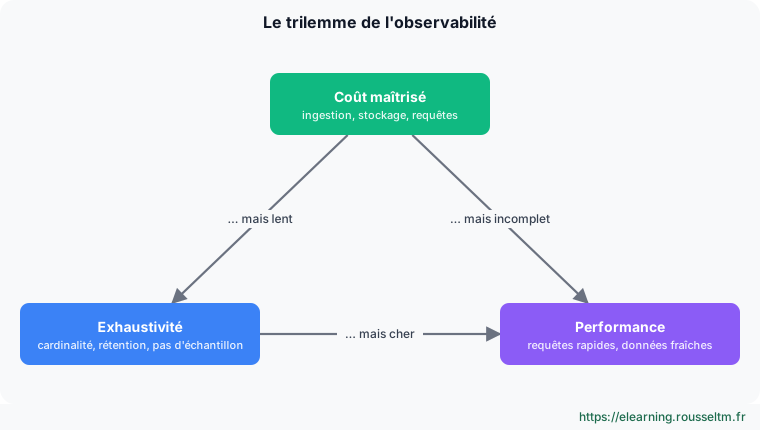
Toute plateforme d'observabilité cherche à offrir trois qualités : un coût maîtrisé, des données exhaustives (toutes les dimensions, sur une longue durée, sans échantillonnage) et des requêtes rapides sur des données fraîches. Le trilemme de l'observabilité constate qu'à volume croissant, on ne peut en optimiser pleinement que deux à la fois : le troisième devient le prix à payer.
D'où vient l'idée #
L'idée a été popularisée en 2019 par Ben Sigelman (cofondateur de LightStep, ancien de Dapper chez Google) : parmi plusieurs propriétés désirables (requêtes à haute cardinalité, longue rétention, données non échantillonnées…), on ne peut en obtenir que certaines à la fois sans que le coût explose. Cindy Sridharan l'a rapprochée du théorème CAP des systèmes distribués. Depuis, le vocabulaire varie selon les auteurs, mais la tension reste la même : coût, exhaustivité, performance.
À savoir : Le trilemme n'est pas une loi physique : c'est une contrainte économique liée au stockage et à l'indexation. Les progrès techniques (stockage colonne, stockage objet) déplacent la frontière, sans la supprimer.
2. Les trois sommets en détail #
Ce que recouvre chaque mot.
Le coût #
Le coût ne se limite pas à la facture du fournisseur. Il faut compter :
| Poste | Ce qui le fait grimper |
|---|---|
| Ingestion | volume de logs, nombre de spans, nombre de séries de métriques |
| Stockage | rétention, taux de compression, stockage SSD ou objet, réplication |
| Indexation | index inversés complets, champs indexés, cardinalité des labels |
| Requêtes | calcul à la demande, données lues, tableaux de bord rafraîchis en continu, agents IA |
| Licences et modèle de facturation | par hôte, par Go ingéré ou indexé, par métrique personnalisée, par utilisateur |
| Humain | exploitation de la plateforme, montées de version, réglages |
L'exhaustivité #
- Cardinalité : pouvoir filtrer par
user_id,pod,trace_id, version, client… Dans un système à séries temporelles, chaque combinaison de labels crée une série : la cardinalité y coûte cher. - Rétention : garder assez longtemps pour comparer avec la semaine, le mois ou l'année précédente, et pour les audits.
- Fidélité : pas d'échantillonnage ni d'agrégation qui effacent l'événement rare, précisément celui qu'on cherche pendant un incident.
- Couverture : tous les signaux (métriques, logs, traces, profils, sessions) et tous les services, pas seulement les plus critiques.
La performance #
- Latence des requêtes : quelques secondes au plus pendant un incident, sur des périodes et des volumes importants.
- Fraîcheur : délai entre l'émission d'un événement et sa visibilité (secondes, pas minutes) ; essentiel pour l'alerting.
- Concurrence : tenir la charge de dizaines de tableaux de bord, d'alertes évaluées en continu et, de plus en plus, d'agents IA qui lancent des centaines de requêtes.
Bonne Pratique : Mesurez chaque sommet avec un indicateur chiffré : coût par Go ou par service et par mois, rétention et taux d'échantillonnage par signal, p95 de la durée des requêtes de tableaux de bord. Sans chiffres, le trilemme se discute en opinions.
3. Les trois compromis #
Chaque paire a son prix.
Vue d'ensemble #
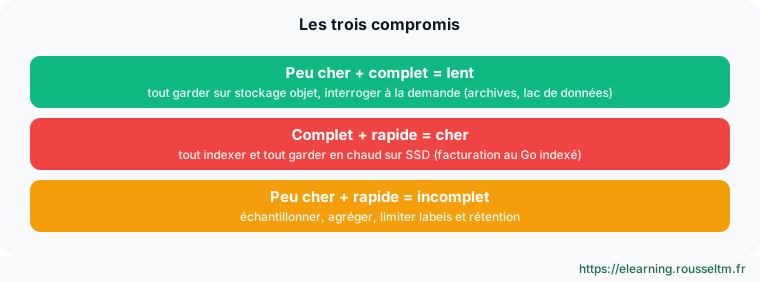
| Paire choisie | Technique typique | Sacrifice | Exemple |
|---|---|---|---|
| Coût + exhaustivité | tout garder, compressé, sur stockage objet | requêtes lentes ou différées | archives de logs sur S3 interrogées avec un moteur SQL à la demande |
| Exhaustivité + performance | index complets, tout en chaud, ressources généreuses | coût élevé | cluster de recherche dimensionné pour 90 jours de logs indexés |
| Coût + performance | échantillonnage, agrégats, labels limités, rétention courte | données incomplètes | Prometheus avec 15 jours de rétention et labels contrôlés ; 1 % des traces conservé |
Les symptômes dans la vraie vie #
- « On n'a pas la trace de cette requête » : l'échantillonnage l'a écartée (coût + performance).
- « Impossible de filtrer par client » : le label a été retiré pour éviter l'explosion des séries (coût + performance).
- « La facture des logs a doublé ce trimestre » : tout est indexé et gardé en chaud (exhaustivité + performance).
- « La requête sur 6 mois prend 20 minutes » : les données sont dans l'archive froide (coût + exhaustivité).
Attention : Réduire à l'aveugle le volume envoyé (« envoyez moins de données ») revient à choisir l'incomplétude sans le dire. Filtrer est sain, à condition de savoir ce que l'on perd et de l'avoir décidé.
4. Pourquoi le trilemme se durcit #
Plus de données, plus de dimensions, plus de requêtes.
Les causes #
- Volumes : microservices, Kubernetes et architectures événementielles multiplient les composants qui émettent de la télémétrie ; une seule requête utilisateur traverse des dizaines de services.
- Cardinalité : pods éphémères, identifiants de conteneur, versions déployées plusieurs fois par jour, attributs métier (client, offre) : le nombre de combinaisons croît plus vite que le trafic.
- Nouveaux signaux : profils continus, sessions navigateur, traces d'applications LLM (prompts, jetons, évaluations) très volumineuses.
- Nouveaux consommateurs : les agents IA d'investigation interrogent la télémétrie bien plus souvent qu'un humain, et ont besoin de données détaillées et longues pour comparer.
- Facturation : les modèles au Go ou à la métrique transforment chaque décision d'instrumentation en décision budgétaire.
5. Les leviers pour desserrer l'étau #
Déplacer la frontière plutôt que subir.
Les leviers #
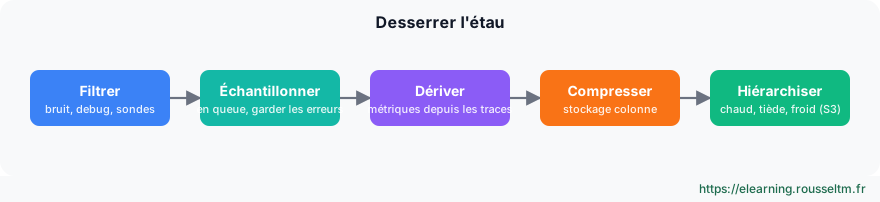
| Levier | Sommet gagné | Prix payé |
|---|---|---|
| Stockage colonne et compression (ClickHouse, Parquet) | coût, sans perdre l'exhaustivité | recherche plein texte moins fine qu'un index inversé |
| Séparer calcul et stockage (stockage objet) | coût et rétention longue | latence sur les données froides |
| Index minimal (labels seuls, comme Loki) | coût d'ingestion | requêtes « force brute » plus lentes sur gros volumes |
| Niveaux chaud / tiède / froid | coût, en gardant la performance sur le récent | complexité de gestion |
| Échantillonnage en queue | coût, en gardant erreurs et traces lentes | les traces « normales » deviennent statistiques |
| Métriques dérivées (spanmetrics, logs vers métriques) | performance et coût des tableaux de bord | dimensions figées à l'avance |
| Agrégats adaptatifs (Adaptive Metrics/Logs, Chronosphere) | coût, guidé par l'usage réel | dépend des recommandations de l'outil |
| Pipelines de télémétrie (OTel Collector, Bindplane, Cribl) | les trois, en routant chaque donnée vers le bon stockage | une brique de plus à exploiter |
Échantillonner sans perdre les tendances #
# Collecteur OpenTelemetry : échantillonnage en queue (toutes les erreurs, les traces lentes, 5 % du reste)
processors:
  tail_sampling:
    decision_wait: 10s
    num_traces: 100000
    policies:
      - { name: erreurs, type: status_code, status_code: { status_codes: [ERROR] } }
      - { name: lentes,  type: latency,     latency: { threshold_ms: 1500 } }
      - { name: reste,   type: probabilistic, probabilistic: { sampling_percentage: 5 } }
connectors:
  spanmetrics:            # métriques RED calculées sur 100 % des spans AVANT l'échantillonnage
    dimensions: [{ name: http.route }, { name: http.response.status_code }]
service:
  pipelines:
    traces/in:      { receivers: [otlp], processors: [memory_limiter], exporters: [spanmetrics, forward] }
    traces/sampled: { receivers: [forward], processors: [tail_sampling, batch], exporters: [otlphttp/traces] }
    metrics/red:    { receivers: [spanmetrics], processors: [batch], exporters: [prometheusremotewrite] }
Les métriques RED sont calculées sur tous les spans, avant l'échantillonnage : les tableaux de bord restent exacts, et seules les traces individuelles « banales » sont écartées.
Router selon la valeur #
# Router selon la valeur : logs d'erreur en chaud, tout en archive compressée
exporters:
  otlphttp/chaud: { endpoint: https://logs-chaud.interne:4318 }
  awss3/archive:
    s3uploader: { region: eu-west-3, s3_bucket: telemetrie-archive, s3_prefix: logs }
    marshaler: otlp_proto
    compression: gzip
processors:
  filter/sans-debug:
    logs:
      log_record: ['severity_number < SEVERITY_NUMBER_INFO']   # supprime DEBUG et TRACE
service:
  pipelines:
    logs/chaud:   { receivers: [otlp], processors: [filter/sans-debug, batch], exporters: [otlphttp/chaud] }
    logs/archive: { receivers: [otlp], processors: [batch], exporters: [awss3/archive] }
Bonne Pratique : Archiver 100 % des logs bruts sur stockage objet coûte peu : on ne paie le prix « chaud » que pour ce qui sert aux enquêtes du quotidien, et l'on peut réhydrater l'archive si un audit l'exige.
6. Comparaison des solutions : sur quoi chacune excelle #
Aucune ne résout le trilemme ; chacune choisit son terrain.
Positionnement #
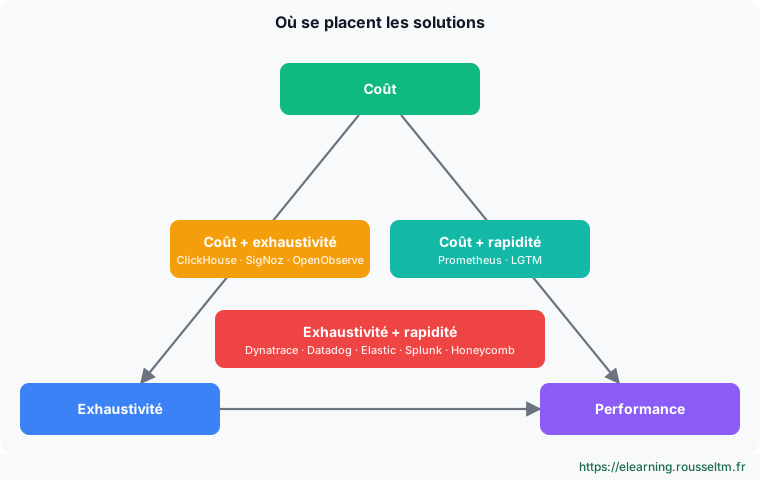
Chaque solution est née d'un choix d'architecture qui la place, par défaut, sur une paire du trilemme. Toutes proposent ensuite des options pour corriger leur point faible (niveaux froids, échantillonnage, agrégats), mais leur point d'excellence reste lié à ce choix initial.
Ce sur quoi chacune excelle #
| Solution | Architecture | Excelle sur | Point de vigilance |
|---|---|---|---|
| ClickHouse (ClickStack, SigNoz) | base orientée colonnes, SQL, stockage objet possible | coût à haute cardinalité : compression forte, filtres sur n'importe quel attribut, analyses SQL et jointures avec les données métier | une base à exploiter (sauf offres managées), écosystème plus jeune |
| Dynatrace | agent unique OneAgent, lac de données Grail sans index (schéma à la lecture), langage DQL, IA Davis | automatisation et analyse de cause : découverte automatique, topologie Smartscape, causalité calculée par l'IA, peu de configuration | coût de licence (consommation), forte dépendance à l'agent et à la plateforme |
| Datadog | SaaS unifié, agent et plus de 900 intégrations | largeur fonctionnelle et rapidité de mise en route : APM, logs, RUM, sécurité, synthétiques dans une même interface très soignée | facture difficile à prévoir (hôtes, métriques personnalisées, logs indexés) ; Flex Logs pour le stockage long |
| LGTM (Loki, Grafana, Tempo, Mimir, Pyroscope) | composants spécialisés sur stockage objet, index minimal | coût de stockage et ouverture : rétention longue bon marché, open source, Grafana fédère des dizaines de sources | requêtes plein texte et haute cardinalité plus lentes (Loki), plusieurs langages (PromQL, LogQL, TraceQL), plusieurs composants à exploiter |
| Elastic (Elasticsearch, Kibana) | index inversé, ES|QL, niveaux chaud à gelé (snapshots interrogeables), mode LogsDB | recherche plein texte et analyse des logs : recherche ad hoc très rapide, agrégations, et convergence observabilité et sécurité (SIEM) | coût de l'indexation et du stockage en chaud ; réglage des index et des niveaux |
| Splunk | index et langage SPL, schéma à la lecture | investigation ad hoc et sécurité : SPL très expressif, écosystème SIEM mature | coût à fort volume |
| Honeycomb | événements larges (« wide events ») en stockage colonne | exploration à haute cardinalité : découper par n'importe quel champ, BubbleUp pour trouver ce qui distingue les requêtes lentes | centré sur traces et événements ; moins orienté métriques d'infrastructure |
| Prometheus | base de séries temporelles locale, PromQL, modèle pull | métriques et alerting en temps réel : standard de fait, très rapide, simple, gratuit | cardinalité et rétention longue limitées : Mimir ou Thanos pour passer à l'échelle |
| OpenObserve | Rust, fichiers Parquet sur stockage objet, binaire unique | coût de stockage et simplicité : logs, métriques et traces dans un seul binaire léger | projet plus jeune, communauté plus réduite |
Grille indicative #
| Solution | Coût | Exhaustivité | Performance | Simplicité d'exploitation |
|---|---|---|---|---|
| ClickHouse (ClickStack, SigNoz) | ●●● | ●●● | ●●○ | ●●○ |
| Dynatrace | ●○○ | ●●● | ●●● | ●●● |
| Datadog | ●○○ | ●●○ | ●●● | ●●● |
| LGTM | ●●● | ●●○ | ●●○ | ●○○ |
| Elastic | ●●○ | ●●○ | ●●● | ●●○ |
| Splunk | ●○○ | ●●● | ●●● | ●●○ |
| Honeycomb | ●●○ | ●●● | ●●● | ●●● |
| Prometheus | ●●● | ●○○ | ●●● | ●●● |
| OpenObserve | ●●● | ●●○ | ●●○ | ●●● |
Attention : Grille volontairement simplifiée, établie en novembre 2026 pour des usages courants : chaque offre évolue vite (niveaux froids, agrégats adaptatifs, offres managées), et le résultat dépend fortement de vos volumes et de vos réglages. Faites toujours un essai avec vos propres données avant de décider.
Comment chacune corrige son point faible #
- Elastic : niveau gelé sur snapshots interrogeables et mode d'index LogsDB (jusqu'à environ 65 % de stockage en moins selon Elastic) pour réduire le coût.
- Datadog : Flex Logs et « Logging without Limits » séparent ingestion, indexation et stockage pour garder plus longtemps à moindre coût.
- Dynatrace : Grail supprime l'indexation à l'ingestion (schéma à la lecture) pour garder plus de données sans les préparer.
- LGTM : blooms et index de structure dans Loki, Adaptive Metrics et Adaptive Logs dans Grafana Cloud pour réduire volume et latence.
- ClickHouse : vues matérialisées, index de saut et offres managées (Managed ClickStack) pour gagner en performance et en simplicité.
- Prometheus : Mimir ou Thanos ajoutent stockage objet, haute disponibilité et rétention longue.
7. Choisir et arbitrer #
Une paire par usage, pas une pour toute l'entreprise.
La méthode #
- Mesurer : volume par signal et par service, cardinalité des métriques, durée réelle des requêtes, coût actuel.
- Classer les usages : alerting, enquête d'incident, tableaux de bord, analyse de tendance, audit et conformité.
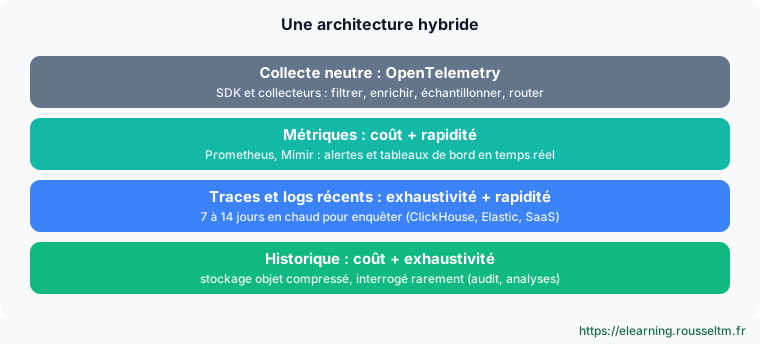
- Choisir une paire par usage (tableau ci-dessous) plutôt qu'une plateforme pour tout.
- Instrumenter en OpenTelemetry pour pouvoir router chaque signal vers le bon stockage et changer d'outil sans réinstrumenter.
- Revoir chaque trimestre : volume par service, labels inutilisés, tableaux de bord jamais ouverts, rétention réellement consultée.
Une paire par usage #
| Usage | Paire à privilégier | Exemple de mise en œuvre |
|---|---|---|
| Alerting temps réel | coût + performance | métriques Prometheus ou Mimir, labels maîtrisés |
| Enquête d'incident (7 à 14 jours) | exhaustivité + performance | traces et logs détaillés en chaud (ClickHouse, Elastic, SaaS) |
| Tableaux de bord de long terme | coût + performance | agrégats (vues matérialisées, métriques dérivées) |
| Audit, conformité, analyses ponctuelles | coût + exhaustivité | archive compressée sur stockage objet |
Mesurer avant de décider #
# Prometheus : les 10 métriques qui créent le plus de séries
topk(10, count by (__name__) ({__name__=~".+"}))
# Prometheus : séries actives au total
prometheus_tsdb_head_series

# Loki : labels qui font exploser le nombre de flux
logcli series '{namespace="prod"}' --analyze-labels

# ClickHouse : taille et compression des tables de télémétrie
SELECT table, formatReadableSize(sum(data_compressed_bytes)) AS disque,
       round(sum(data_uncompressed_bytes) / sum(data_compressed_bytes), 1) AS ratio
FROM system.parts WHERE active GROUP BY table ORDER BY sum(data_compressed_bytes) DESC;

# Elasticsearch : index les plus volumineux
GET _cat/indices?v&s=store.size:desc&h=index,docs.count,store.size

# Dynatrace (DQL) : volume de logs par source sur 24 h
fetch logs, from: now() - 24h | summarize n = count(), by: { log.source } | sort n desc
8. À retenir #
Synthèse et liste de contrôle.
Synthèse #
- Le trilemme oppose coût, exhaustivité et performance : à volume croissant, on n'en optimise que deux à la fois.
- Chaque solution excelle sur une paire liée à son architecture : ClickHouse sur coût et cardinalité, Dynatrace sur l'automatisation, Datadog sur la largeur fonctionnelle, LGTM sur le coût de stockage et l'ouverture, Elastic sur la recherche plein texte, Prometheus sur les métriques temps réel.
- La meilleure réponse est rarement un outil unique : c'est une architecture par usage, alimentée par OpenTelemetry et des pipelines qui routent chaque donnée vers le bon compromis.
Liste de contrôle #
| Question | Bonne réponse |
|---|---|
| Connaissez-vous votre coût par service ? | oui, revu chaque mois |
| L'échantillonnage garde-t-il toutes les erreurs ? | oui, échantillonnage en queue et métriques calculées avant |
| La rétention est-elle définie par signal ? | oui, et alignée sur l'usage réel |
| Les labels à forte cardinalité sont-ils maîtrisés ? | dans les métriques, oui ; dans les traces et logs, ils sont permis |
| Peut-on changer d'outil sans réinstrumenter ? | oui, grâce à OpenTelemetry |
Commandes à connaître #
Commandes à connaître
topk(10, count by (__name__) ({__name__=~".+"})): métriques qui créent le plus de sérieslogcli series '{namespace="prod"}' --analyze-labels: cardinalité des labels LokiSELECT … FROM system.parts WHERE active: taille et compression ClickHouseGET _cat/indices?v&s=store.size:desc: index Elasticsearch les plus lourdstail_sampling (OTel Collector): échantillonner en gardant erreurs et traces lentesspanmetrics (OTel Collector): métriques RED exactes malgré l'échantillonnage
Sources #
- InfoQ : Rethinking Observability (Ben Sigelman, 2019)
- ClickHouse : rétention, échantillonnage et agrégats (2026)
- DevOps.com : « envoyer moins de données » n'est pas une stratégie
- OpenTelemetry : processeur tail_sampling
- Dynatrace Grail
- Datadog Flex Logs
- Grafana Loki : principe de l'index minimal
Vérifié en novembre 2026 : les offres et modèles de facturation évoluent vite, vérifiez la documentation de chaque éditeur avant de vous appuyer sur un détail.
Pour aller plus loin
 Dynatrace : de la découverte à l’expertise
 Prometheus : de la découverte à l'expertise
 Opentelemetry : de la découverte à l'expertise
 Grafana : de la découverte à l'expertise
 Kibana et Elastic Observability : de la découverte à l'expertise
 SigNoz : de la découverte à l'expertise
 Datadog : de la découverte à l'expertise
 Bindplane : pipelines de télémétrie OpenTelemetry de la découverte à l'expertise
 ClickStack : de la découverte à l'expertise
 OpenObserve : de la découverte à l'expertise