1. LogHouse : ClickHouse observe ClickHouse Cloud #
Le cas fondateur.
L'essentiel #
Pour observer son propre service cloud, ClickHouse a projeté une facture Datadog de 26 M$ par mois au prix catalogue (30 jours de rétention, à 19 PiB). La plateforme interne LogHouse, bâtie sur ClickHouse, est au moins 200 fois moins chère aux prix catalogue ; la migration des logs a demandé 1,5 ingénieur pendant moins de trois mois. Elle dépasse aujourd'hui 200 Po de télémétrie dans plus de 30 régions.
La leçon : à très grand volume, le coût de l'observabilité dépend d'abord du moteur de stockage, pas de l'interface.
2. Qonto : les traces au service du déploiement et des incidents #
Une néobanque, ses traces et ses automatisations.
L'architecture #
- Les traces (back-end, front-end, Kubernetes, outils comme GitHub) passent par des collecteurs OpenTelemetry, en HTTP ou gRPC, vers ClickHouse Cloud, avec le schéma OpenTelemetry conventionnel.
- Le stockage colonne leur donne un taux de compression d'environ 26 sur les traces.
- Le calcul est séparé : un service en écriture pour les collecteurs, un service en lecture pour Grafana et les outils d'analyse, un service en lecture « critique » réservé aux automatisations.
Trois automatisations #
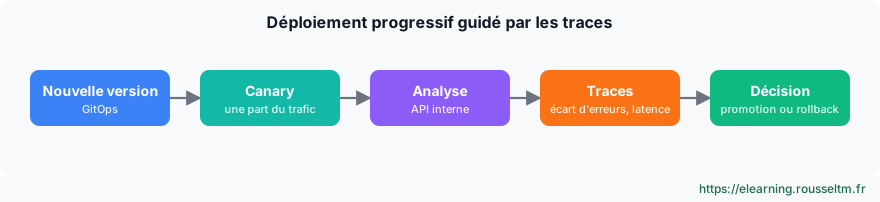
| Automatisation | Fonctionnement |
|---|---|
| Analyse canary | à chaque nouvelle version, un modèle d'analyse du déploiement progressif interroge une API interne qui calcule sur les traces l'écart d'erreurs et la latence de la version canary ; la version n'est promue que si la condition de succès est remplie |
| Page de statut | une API de disponibilité vérifie toutes les 30 secondes, sur les traces, la part de requêtes réussies et assez rapides de chaque fonction clé, avec des seuils « dégradé » et « en panne » ; la page de statut publique (outil open source kener) est construite à partir de ces résultats |
| Remédiation | une API de gestion d'incident s'appuie sur ces vérifications pour déclencher un retour arrière automatique |
À savoir : Limite identifiée par l'équipe : leur disponibilité est calculée par tranches de temps (SLO basé sur le temps). La prochaine étape annoncée est un SLO basé sur les événements, avec le SLI posé sur chaque span dans une colonne dédiée. Voir l'article « SLO basé sur le temps ou sur les événements ».
Ce qu'on peut en retenir #
- Les traces ne servent pas qu'à enquêter : ce sont des données pour décider (promouvoir, revenir en arrière, publier un statut).
- Réservez un calcul dédié aux automatisations, pour qu'une requête de dashboard ne retarde jamais une décision de déploiement.
- Décrivez les vérifications en configuration déclarative (service, filtres, condition de succès, seuils), versionnée avec le code.
3. Ringover : contrôle total, responsabilité totale #
Une plateforme auto-hébergée.
Le contexte #
Ringover (téléphonie et conversations clients) exploite sa propre infrastructure, en Europe et aux États-Unis : plus de 500 nœuds physiques. Son observabilité est donc auto-hébergée : « la liberté de choisir les composants, et le devoir de les exploiter ». ClickHouse a été choisi après des essais sur des charges réelles (premières traces Jaeger, analytique utilisateur), pas sur un benchmark ; il atteint une compression d'environ 16.
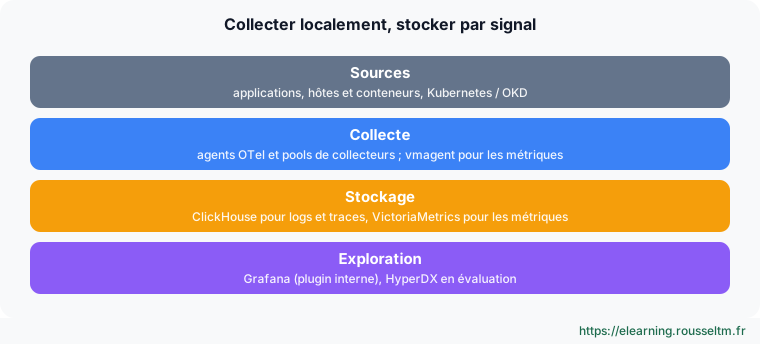
Avant : Prometheus central, Vector et Loki pour les logs, une flotte qui a doublé en deux ans. Après : agents locaux et pipelines en push, ClickHouse pour logs et traces, VictoriaMetrics pour les métriques. « Pas un changement de base de données : un nouveau modèle de collecte et d'exploitation. »
Leurs leçons #
| Sujet | Leçon |
|---|---|
| Ingestion | regrouper délibérément : lots d'environ 80 000 lignes, fenêtre de 5 à 10 s, files persistantes par signal |
| Schéma | passer de Map à JSON a rendu recherches et filtres 3 à 4 fois plus rapides, mais la longue rétention a imposé de longues doubles écritures |
| Requêtes | dashboards, requêtes MCP et doubles écritures se disputent les ressources : limiter parallélisme, concurrence et durée, dimensionner les caches |
| Rétention | 180 jours de logs, dont 30 sur SSD local ; la donnée froide sur S3 coûte peu à stocker, pas à lire |
| Expérience développeur | quand l'interface manque, on la construit (plugin Grafana interne) puis on la maintient ; HyperDX est en évaluation, l'IAM restant à résoudre |
« Si nous recommencions demain » #
- Regrouper en amont : des lots de 10 000 à 100 000 lignes dans le collecteur, une file par signal.
- Cloisonner les requêtes : un profil de requêtes dédié, l'ingestion garde la priorité.
- Choisir le schéma tôt : adopter les attributs JSON avant que la rétention ne rende les migrations longues.
- Et prévoir dès le premier jour l'expérience développeur et la gestion des accès.
« Le travail n'a pas disparu : il est devenu le nôtre. » L'auto-hébergement apporte le contrôle de la capacité et du réglage, au prix de l'exploitation de l'ingestion, des montées de version, de la rétention et des accès.
4. Synthèse #
Trois modèles, un même moteur.
Comparer #
| LogHouse | Qonto | Ringover | |
|---|---|---|---|
| Modèle | plateforme interne de l'éditeur | ClickHouse Cloud | auto-hébergé sur métal nu |
| Signaux | logs (puis tous signaux) | traces en priorité | logs et traces ; métriques dans VictoriaMetrics |
| Point fort | coût à très grand volume | automatisations fondées sur les traces | maîtrise complète |
| Effort | migration courte | APIs internes à maintenir | exploitation complète à assumer |
Sources #
Présentations de LogHouse (ClickHouse), Qonto et Ringover à la Matinée de l'Observabilité ClickHouse, Paris, 17 novembre 2026 ; chiffres de LogHouse publiés sur le blog de ClickHouse. Les détails internes des entreprises ne sont repris qu'au niveau des principes.
