1. Archiver sur stockage objet #
Le socle du rejeu.
Une destination S3 bien partitionnée #
Bucket:               archive-telemetrie
Key prefix:           cribl
Partitioning expr.:   `${C.Time.strftime(_time ? _time : Date.now()/1000, '%Y/%m/%d/%H')}/${sourcetype}/${host}`
Data format:          JSON   (ou Parquet)
Compression:          gzip
Max file size: 32 MB · Max file open time: 300 s- Le partitionnement par date puis par type permet de rejouer une heure d'un type de log sans lire tout le reste.
- Parquet (format colonne) se compresse mieux et s'interroge directement par Cribl Search, Athena ou ClickHouse ; JSON gzip reste le plus simple à relire.
- Une règle de cycle de vie du bucket (passage en classe froide, expiration) fixe la rétention et le coût.
2. Rejouer #
Réinjecter une période précise.
Collecteur et rejeu #
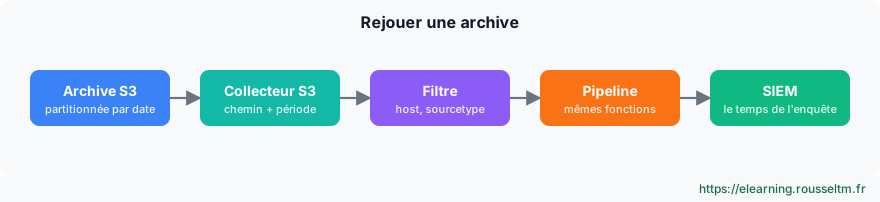
- Créez un collecteur S3 qui pointe sur l'archive, avec un chemin qui reprend le partitionnement :
/cribl/${_time:%Y}/${_time:%m}/${_time:%d}/${_time:%H}/${sourcetype}/${host}/. - Lancez-le à la demande (Run) en précisant la période et un filtre (
host=="srv-42") : Cribl ne lit que les partitions concernées grâce aux variables du chemin. - Les événements rejoués passent par les routes comme les autres : ajoutez un champ (
replayed=true) pour les router vers le SIEM et les distinguer. - Le mode Preview du collecteur montre un échantillon avant de lancer la collecte complète.
Bonne Pratique : Planifiez aussi des collectes régulières (Schedule) pour les API qui ne poussent pas leurs données : audit SaaS, inventaires, métriques cloud.
3. Cribl Lake et Cribl Search #
Stocker et interroger sans réingérer.
Cribl Lake #
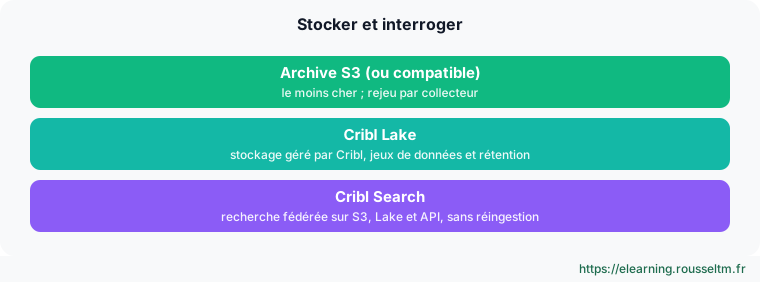
Cribl Lake est un stockage géré dans Cribl.Cloud : on y crée des jeux de données (datasets) avec leur rétention, et une destination Cribl Lake y écrit depuis Stream ou Edge, sans gérer de bucket ni de format.
Cribl Search #
Cribl Search interroge les données là où elles sont : Cribl Lake, buckets S3, et certaines API, avec un langage proche de Kusto (KQL). Depuis la version 4.17, une destination Cribl Search permet aussi d'y envoyer directement des données depuis Stream ou Edge.
dataset="archive_fw" action="deny"
| summarize count() by src_ip
| sort by count_ desc
| limit 10
À savoir : La syntaxe exacte et les jeux de données disponibles dépendent de votre espace Cribl.Cloud : partez des requêtes d'exemple proposées par l'interface.
Quand utiliser quoi #
| Besoin | Solution |
|---|---|
| Garder tout au moindre coût | archive S3 + règles de cycle de vie |
| Réinjecter une période dans le SIEM | collecteur S3 et rejeu |
| Chercher une aiguille sans réingérer | Cribl Search |
| Stockage géré, sans bucket à administrer | Cribl Lake |
Commandes à connaître #
Commandes à connaître
C.Time.strftime(_time, '%Y/%m/%d/%H'): partitionner par heure/${_time:%Y}/${_time:%m}/${_time:%d}/: variables de chemin d'un collecteuraws s3 ls s3://archive/cribl/2026/11/17/ --recursive | head: vérifier l'archivedataset="…" | summarize count() by host: requête Cribl Search
Sources #
Vérifié en novembre 2026 (Cribl 4.20) : Cribl publie une version mineure environ tous les deux mois, consultez les notes de version avant de vous appuyer sur un détail.
Mon suivi
Connectez-vous pour suivre votre progression et prendre des notes. Se connecter
💬 Questions sur cette leçon
Aucune question pour l'instant : soyez le premier à demander de l'aide ou à partager votre configuration.
Articles recommandés
Bindplane : gérer ses pipelines de télémétrie OpenTelemetry
Comprendre Bindplane : plan de contrôle des collecteurs OpenTelemetry via OpAMP, BDOT Collector, ...
OpenTelemetry Collector, Grafana Alloy et Bindplane : comparer trois approches des pipelines de télémétrie
Comparatif détaillé de trois façons de gérer des pipelines de télémétrie : l'OpenTelemetry Collec...
RUM et Synthetic Monitoring avec Datadog : synthetic transaction monitoring et expérience utilisateur
Mesurer l'expérience utilisateur avec Datadog : RUM navigateur et mobile, Core Web Vitals, Sessio...
Dynatrace : Gestion du RGPD et protection de la vie privée (Data Privacy)
Apprenez à configurer Dynatrace pour respecter le RGPD, masquer les données sensibles et activer ...
Bonnes pratiques Bindplane
Check-list pour exploiter Bindplane : organisation par labels et fleets, réduction mesurée, masqu...
Logs avancés avec OpenPipeline : traitement, masquage, buckets et rétention
Gérer les logs dans Dynatrace avec OpenPipeline : ingestion, routage, traitement DQL (parsing, en...
Logs Datadog avancés : index, filtres d'exclusion, Flex Logs, archives et Sensitive Data Scanner
Maîtriser coût et conformité des logs Datadog : pipelines et processeurs, index et rétention, fil...
Logs dans Datadog : collecte, pipelines, index et maîtrise du volume
Collecter les logs avec l'agent, les structurer avec pipelines et processeurs (grok), utiliser fa...
Le trilemme de l'observabilité : coût, exhaustivité et performance, et comment les solutions le résolvent
Comprendre le trilemme de l'observabilité (coût, exhaustivité des données, performance des requêt...