1. D'où vient le gaspillage #
Ce qui coûte sans servir.
Les sources de volume inutile #
- Champs vides ou redondants : un log de pare-feu compte souvent plus de 100 champs, dont une bonne partie ne sert jamais.
- Événements sans valeur de sécurité : trafic autorisé vers le DNS interne, sondes de santé, logs de debug.
- Doublons : le même message répété des milliers de fois par minute pendant un incident.
- Détail inutile pour l'usage : un tableau de bord qui n'affiche que des comptages n'a pas besoin de chaque événement.
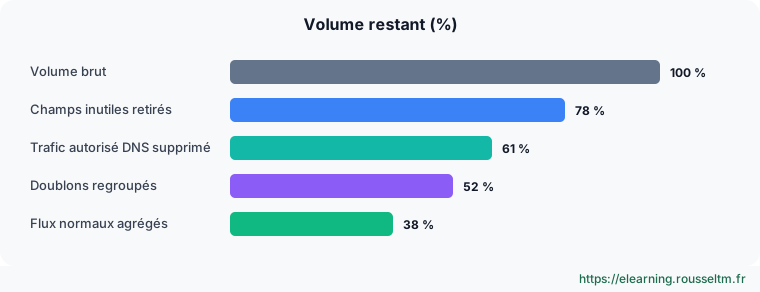
Les pourcentages du schéma sont illustratifs : mesurez sur vos propres données, les gains varient fortement selon les sources.
2. Les techniques #
Du plus sûr au plus agressif.
Panorama #
| Technique | Fonction | Perte d'information |
|---|---|---|
| Retirer des champs vides ou inutiles | Eval (Remove), Serialize (liste de champs), Parser en mode « reserialize » | aucune si bien choisis |
| Supprimer des événements sans valeur | Drop, Regex Filter | totale pour ces événements (à archiver ailleurs) |
| Regrouper les doublons | Suppress | faible : un compteur garde la trace |
| Agréger | Aggregations, Rollup Metrics | le détail individuel |
| Échantillonner | Sampling, Dynamic Sampling | statistique ; à réserver aux flux très répétitifs |
| Transformer en métriques | Publish Metrics, Aggregations | le texte des logs |
Réglages types #
# Aggregations : 1 événement par minute et par couple source/destination au lieu de milliers
time window: 60s
aggregations: [ "count().as(flows)", "sum(bytes).as(bytes)" ]
group by: [ src_ip, dst_ip, dst_port, action ]

# Suppress : un seul événement identique toutes les 5 minutes, avec le compteur des supprimés
key expression: `${host}:${message}`
number to allow: 1
suppression period: 300

# Dynamic Sampling : échantillonner davantage ce qui est très fréquent
sample mode: logarithmic
group by key: `${status}:${uri}`
Ces réglages se saisissent dans les formulaires des fonctions ; l'extrait en résume les champs principaux.
3. Réduire sans rien perdre #
Le double flux.
Archive complète, SIEM réduit #
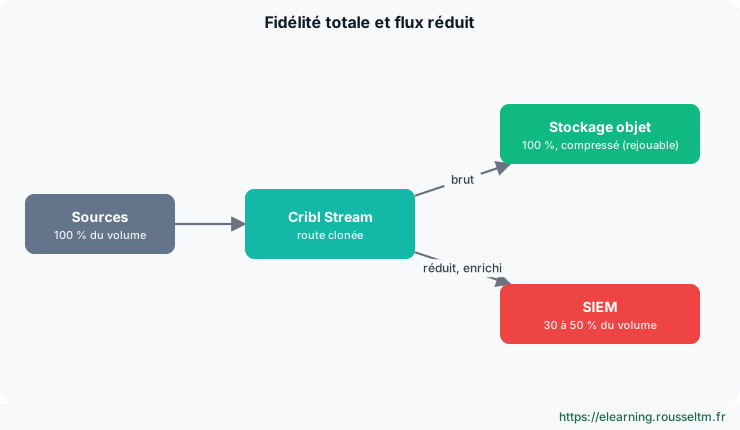
- Une première route non finale envoie 100 % des données brutes vers le stockage objet, compressées.
- Une seconde route applique le pipeline de réduction et envoie le résultat au SIEM.
- En cas d'enquête, on rejoue la période utile depuis l'archive vers le SIEM (chapitre suivant).
Bonne Pratique : Cette architecture rend la réduction réversible : l'équipe sécurité accepte bien plus facilement de filtrer quand elle sait pouvoir tout récupérer.
4. Protéger et mesurer #
Masquer, puis prouver le gain.
Masquer #
- Mask remplace par expression régulière : numéros de carte, adresses e-mail, jetons, mots de passe dans les URL.
- Hachez plutôt que supprimer (
C.Mask.sha256()) quand il faut pouvoir corréler sans connaître la valeur. - Masquez dans le pipeline de traitement, avant toute destination externe, y compris l'archive si elle sort de votre périmètre.
Mesurer #
- Monitoring › Data : octets et événements entrants et sortants par source, route, pipeline et destination.
- Comparez l'entrée de la route et la sortie vers le SIEM sur une semaine ; présentez le gain en Go par jour et en coût de licence évité.
- Vérifiez avec l'équipe sécurité que les détections restent identiques (mêmes alertes sur la même période).
Attention : Ne supprimez jamais un type d'événement sans l'accord des équipes qui l'exploitent : une règle de détection peut reposer sur un log qui semble inutile.
Commandes à connaître #
Commandes à connaître
action=='allow' && dst_port==53: filtre de Drop typiquecount().as(flows): agrégation de comptageC.Mask.sha256(email): pseudonymiser par hachageMonitoring › Data › Routes: mesurer la réduction
Sources #
Vérifié en novembre 2026 (Cribl 4.20) : Cribl publie une version mineure environ tous les deux mois, consultez les notes de version avant de vous appuyer sur un détail.
Mon suivi
Connectez-vous pour suivre votre progression et prendre des notes. Se connecter
💬 Questions sur cette leçon
Aucune question pour l'instant : soyez le premier à demander de l'aide ou à partager votre configuration.
Articles recommandés
Transformer avec VRL et tester ses pipelines Vector
Le langage VRL (Vector Remap Language) : analyse de logs (JSON, regex, syslog), gestion des erreu...
Installer et administrer Cribl Stream
Installer Cribl Stream en Docker ou sur Linux, le lancer comme service, comprendre $CRIBL_HOME, d...
Coûts et gouvernance Datadog : usage, attribution, RBAC et politiques de tags
Maîtriser la facture et gouverner Datadog : suivi de l'usage et de l'estimation, attribution des ...
OpenTelemetry Collector : les Processors (transformer, filtrer et protéger la télémétrie)
Maîtriser les processors du Collector OpenTelemetry : batch, memory_limiter, attributes, resource...
Bonnes pratiques Bindplane
Check-list pour exploiter Bindplane : organisation par labels et fleets, réduction mesurée, masqu...
Bonnes Pratiques OpenTelemetry (OTel) : Le Guide de l'Observabilité Moderne
Maîtrisez OpenTelemetry grâce à nos conseils d'experts : implémentation du Collector, respect des...
Logs avancés avec OpenPipeline : traitement, masquage, buckets et rétention
Gérer les logs dans Dynatrace avec OpenPipeline : ingestion, routage, traitement DQL (parsing, en...
Le trilemme de l'observabilité : coût, exhaustivité et performance, et comment les solutions le résolvent
Comprendre le trilemme de l'observabilité (coût, exhaustivité des données, performance des requêt...
Logs Datadog avancés : index, filtres d'exclusion, Flex Logs, archives et Sensitive Data Scanner
Maîtriser coût et conformité des logs Datadog : pipelines et processeurs, index et rétention, fil...