1. Qu'est-ce que le chaos engineering ? #
Définition, origine et objectifs.
Définition #
Le chaos engineering est la discipline qui consiste à expérimenter sur un système pour gagner en confiance dans sa capacité à supporter des conditions turbulentes en production. Il ne s'agit pas de « casser au hasard », mais de mener des expériences contrôlées, guidées par une hypothèse, pour découvrir les faiblesses avant qu'elles ne provoquent un incident.
La pratique est née chez Netflix vers 2010 avec Chaos Monkey, qui arrêtait aléatoirement des instances en production pour obliger les équipes à concevoir des services tolérants aux pannes. Les principes ont été formalisés sur principlesofchaos.org.
Pourquoi en faire ? #
- Vérifier que les mécanismes de résilience (redondance, bascule, retries, timeouts, disjoncteurs) fonctionnent vraiment.
- Découvrir des dépendances cachées et des modes de défaillance inattendus.
- Réduire le temps de détection et de rétablissement en entraînant les équipes.
- Valider les alertes, les tableaux de bord et les procédures (runbooks).
- Construire une culture où la défaillance est attendue et étudiée.
À savoir : Une bascule de secours jamais testée échoue souvent le jour où l'on en a besoin. Le chaos engineering transforme l'espoir en preuve.
2. Les principes d'une expérience #
Régime permanent, hypothèse, rayon d'impact.
Les cinq principes #
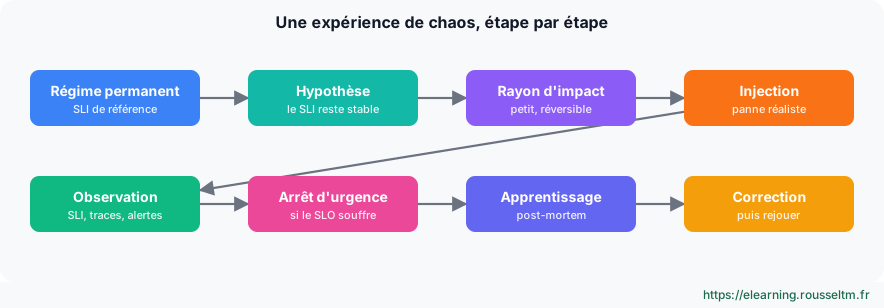
- Définir le régime permanent : une mesure du comportement normal visible par les utilisateurs, en pratique un SLI (taux de succès, latence p99, commandes par minute).
- Formuler une hypothèse : « le régime permanent se maintient dans le groupe expérimental comme dans le groupe de contrôle ».
- Introduire des événements réels : pannes de serveurs, latence réseau, saturation, erreurs de dépendances.
- Expérimenter en production quand c'est possible, car le trafic et l'environnement réels révèlent ce que les tests ne montrent pas.
- Automatiser et exécuter en continu, en minimisant le rayon d'impact.
Maîtriser le rayon d'impact #
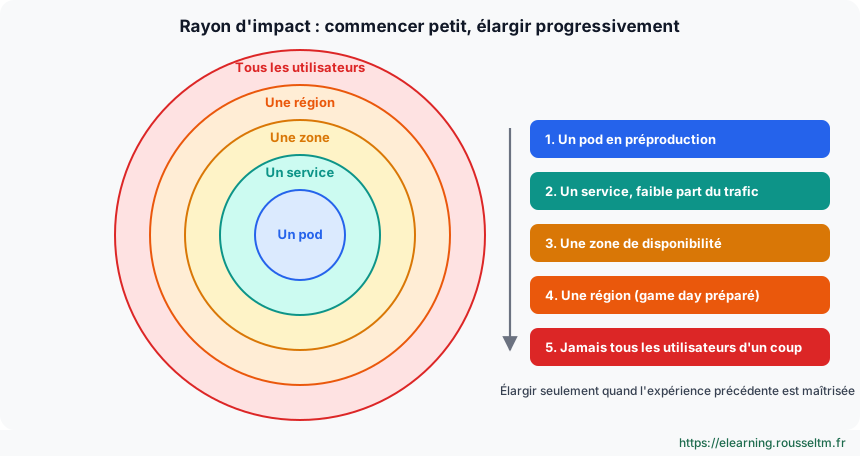
Commencez petit : un pod, une instance, un faible pourcentage de trafic, en préproduction puis en production. Définissez à l'avance les conditions d'arrêt (le SLI passe sous un seuil, une alerte critique se déclenche) et un moyen d'annuler immédiatement l'injection.
Erreur courante : Lancer une expérience sans observabilité ni conditions d'arrêt, c'est provoquer un incident, pas une expérience.
3. Chaos engineering et SRE #
SLO, budget d'erreur et apprentissage.
S'appuyer sur les SLO #
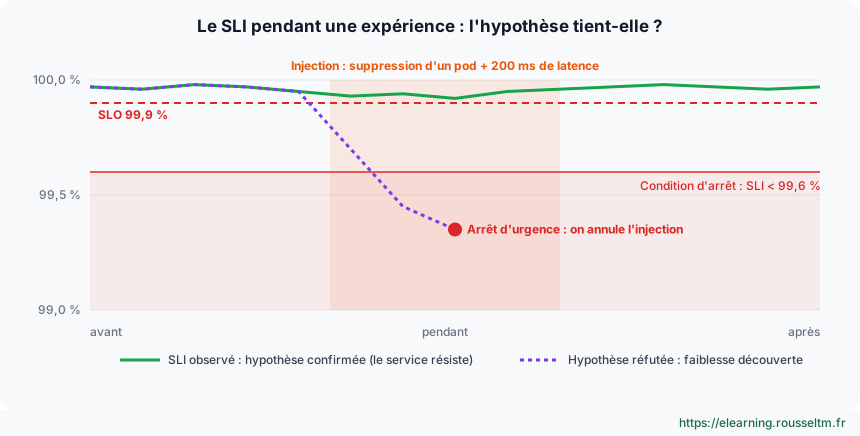
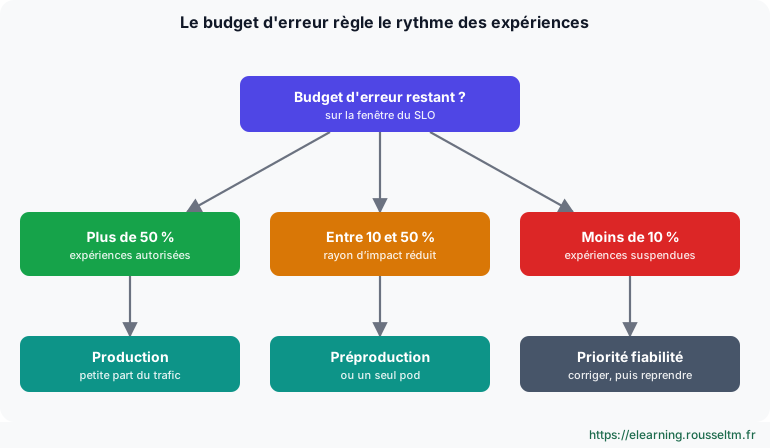
Le SRE fournit le cadre idéal : les SLI définissent le régime permanent, les SLO fixent le seuil d'arrêt et le budget d'erreur indique combien d'indisponibilité l'équipe peut se permettre. Certaines équipes réservent explicitement une part du budget aux expériences : tant qu'il reste du budget, on expérimente ; s'il est épuisé, on fige les expériences risquées comme les mises en production.
| Notion SRE | Rôle dans le chaos engineering |
|---|---|
| SLI | Mesure du régime permanent pendant l'expérience |
| SLO | Limite au-delà de laquelle l'expérience est arrêtée |
| Budget d'erreur | Autorise ou suspend les expériences selon la consommation |
| Alertes burn rate | Doivent se déclencher si l'injection dégrade réellement le service |
| Post-mortem sans blâme | Format de restitution des enseignements de l'expérience |
Ce que l'on apprend #
Une expérience réussie n'est pas celle qui ne casse rien : c'est celle qui apprend quelque chose. Si l'hypothèse est réfutée, documentez la faiblesse, priorisez la correction, puis rejouez l'expérience pour vérifier.
4. Quelles pannes injecter ? #
Catalogue des défaillances réalistes.
Types de pannes #
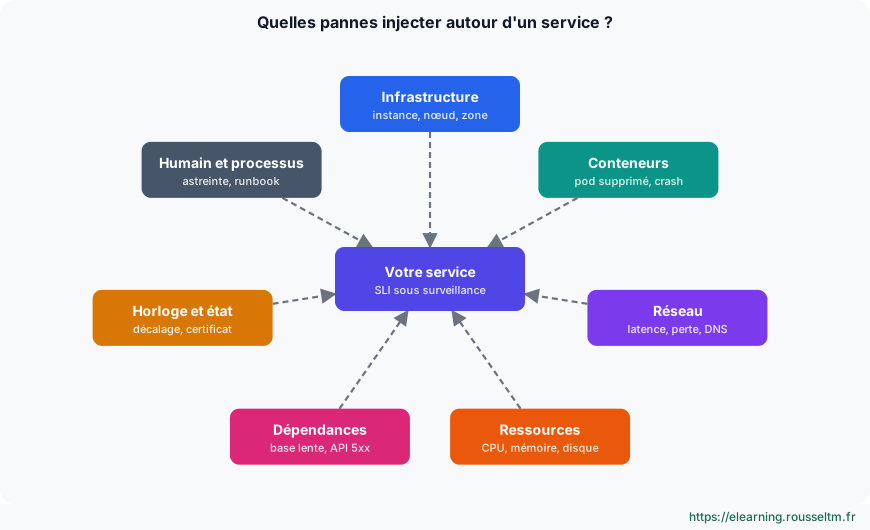
| Catégorie | Exemples | Ce que l'on vérifie |
|---|---|---|
| Infrastructure | Arrêt d'une instance, d'un nœud, d'une zone | Redondance, auto-réparation, bascule |
| Conteneurs | Suppression de pods, redémarrages en boucle | Réplicas, probes, PodDisruptionBudget |
| Réseau | Latence, perte de paquets, coupure, DNS en échec | Timeouts, retries, disjoncteurs |
| Ressources | Saturation CPU, mémoire, disque | Limites, autoscaling, dégradation progressive |
| Dépendances | Base de données lente, API tierce en erreur 5xx | Cache, mode dégradé, files d'attente |
| Horloge et état | Décalage d'horloge, certificat expiré | Robustesse des contrôles de validité |
| Humaines et processus | Absence d'une personne clé, procédure manquante | Documentation, astreinte, runbooks |
5. Les outils #
Comparatif des principaux outils.
Panorama #
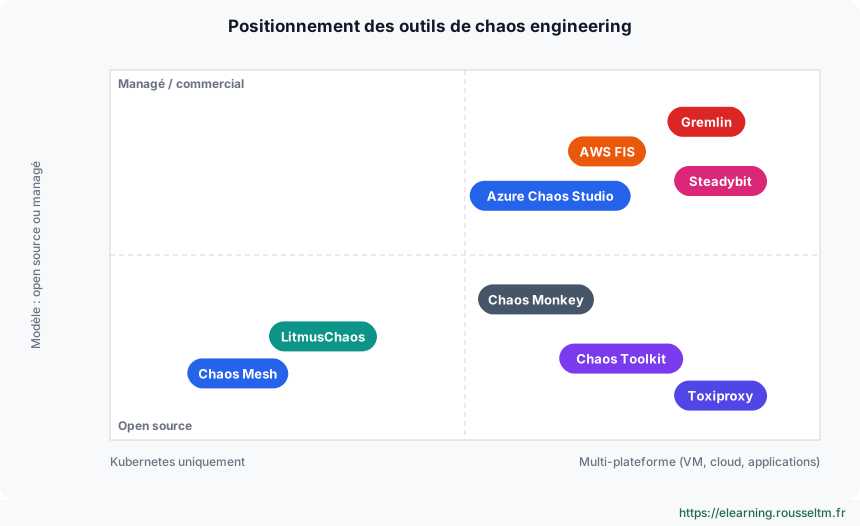
| Outil | Type | Points forts |
|---|---|---|
| Chaos Mesh | Open source (CNCF), Kubernetes | Ressources PodChaos, NetworkChaos, StressChaos, IOChaos ; tableau de bord ; workflows |
| LitmusChaos | Open source (CNCF), Kubernetes | ChaosHub d'expériences prêtes à l'emploi, sondes de validation |
| Chaos Toolkit | Open source, multi-plateforme | Expériences déclaratives en JSON/YAML, extensions cloud et Kubernetes |
| AWS Fault Injection Service | Service managé AWS | Modèles d’expériences sur EC2, ECS, EKS, RDS ; conditions d’arrêt CloudWatch |
| Azure Chaos Studio | Service managé Azure | Pannes de VM, AKS, réseau ; expériences planifiées |
| Gremlin, Steadybit | Plateformes commerciales | Bibliothèque de scénarios, garde-fous, rapports |
| Toxiproxy | Proxy de test | Latence et coupures entre une application et ses dépendances, idéal en tests d’intégration |
| Chaos Monkey | Netflix (Spinnaker) | Arrêt aléatoire d’instances, historique de la discipline |
6. Mise en pratique sur Kubernetes #
Chaos Mesh et Chaos Toolkit pas à pas.
Installer Chaos Mesh #
helm repo add chaos-mesh https://charts.chaos-mesh.org
helm install chaos-mesh chaos-mesh/chaos-mesh -n chaos-mesh --create-namespace \
  --set chaosDaemon.runtime=containerd --set chaosDaemon.socketPath=/run/containerd/containerd.sock
kubectl get pods -n chaos-mesh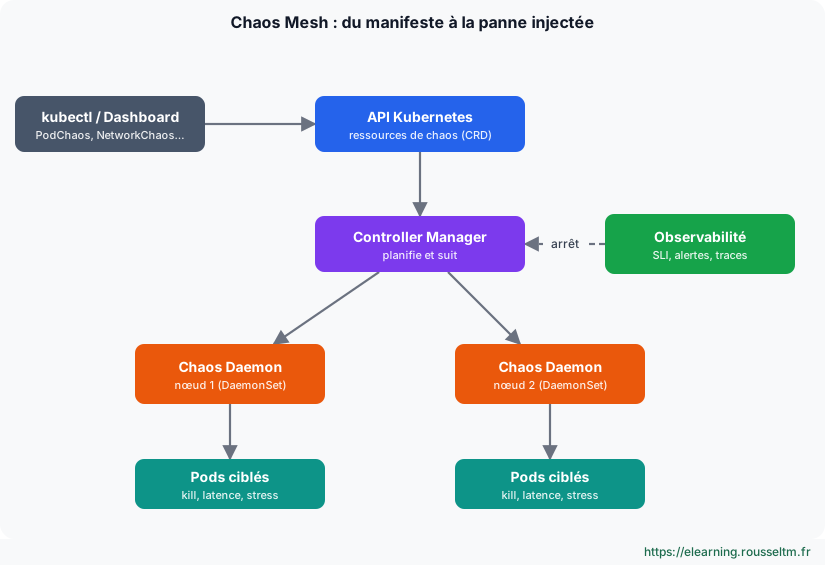
Expérience 1 : supprimer un pod #
Hypothèse : avec trois réplicas et une readiness probe, la suppression d'un pod de l'API ne fait pas baisser le taux de succès sous 99,9 %.
apiVersion: chaos-mesh.org/v1alpha1
kind: PodChaos
metadata: { name: api-pod-kill, namespace: boutique }
spec:
  action: pod-kill
  mode: one                 # un seul pod : rayon d'impact minimal
  selector:
    namespaces: [boutique]
    labelSelectors: { app: api }
kubectl apply -f api-pod-kill.yaml
kubectl get pods -n boutique -l app=api -w # un pod est recréé
kubectl delete -f api-pod-kill.yaml # fin de l'expérience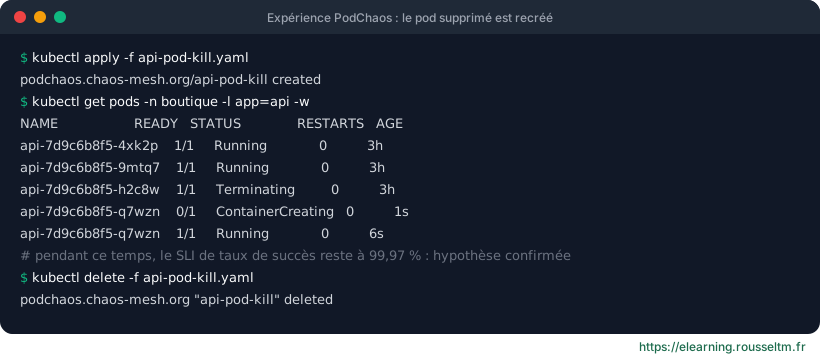
Expérience 2 : ajouter de la latence réseau #
Hypothèse : si la base de données répond 200 ms plus lentement, le p99 de l'API reste sous 800 ms grâce au cache.
apiVersion: chaos-mesh.org/v1alpha1
kind: NetworkChaos
metadata: { name: db-latence, namespace: boutique }
spec:
  action: delay
  mode: all
  selector: { namespaces: [boutique], labelSelectors: { app: postgres } }
  delay: { latency: 200ms, jitter: 20ms }
  duration: 5m
Bonne Pratique : Observez pendant l'expérience le SLI de latence, les traces de l'API et le déclenchement (ou non) des alertes burn rate : une alerte qui ne se déclenche pas alors que les utilisateurs souffrent est aussi un enseignement.
Une expérience déclarative avec Chaos Toolkit #
{
  "title": "L'API tolère la perte d'un pod",
  "steady-state-hypothesis": {
    "title": "L'API répond",
    "probes": [{ "type": "probe", "name": "api-ok", "tolerance": 200,
                 "provider": { "type": "http", "url": "https://api.exemple.fr/healthz" } }]
  },
  "method": [{ "type": "action", "name": "supprimer-un-pod",
               "provider": { "type": "python", "module": "chaosk8s.pod.actions",
                             "func": "terminate_pods",
                             "arguments": { "label_selector": "app=api", "ns": "boutique", "qty": 1 } } }],
  "rollbacks": []
}
pip install chaostoolkit chaostoolkit-kubernetes
chaos run experience.json # vérifie l'hypothèse avant et après l'injection7. Organiser des game days #
Préparer, animer, restituer.
Déroulé d'un game day #
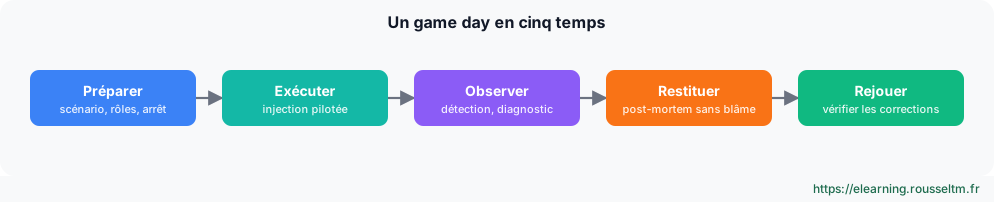
- Préparer : choisir un scénario réaliste, l'hypothèse, les participants (équipes concernées, astreinte), les conditions d'arrêt et la communication.
- Exécuter : un animateur injecte la panne, les équipes détectent et réagissent comme en incident réel.
- Observer : noter le temps de détection, de diagnostic et de rétablissement, les alertes reçues ou manquantes.
- Restituer : post-mortem sans blâme, actions correctives avec responsables et échéances.
- Rejouer plus tard pour vérifier les corrections.
Pièges à éviter #
- Expérimenter sans observabilité ni SLO : impossible de savoir si l'hypothèse tient.
- Commencer par une panne de grande ampleur en production.
- Ne pas prévenir les équipes et le support lors des premières expériences.
- Ne pas suivre les actions correctives : les mêmes faiblesses réapparaissent.
- Confondre chaos engineering et tests de charge : les deux sont complémentaires.
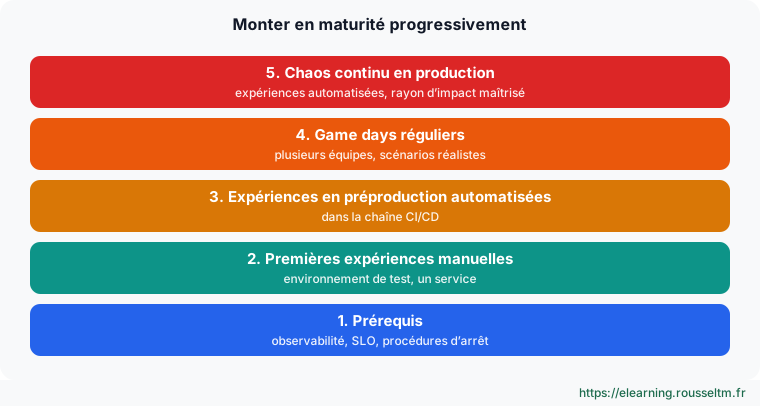
Bonne Pratique : Intégrez progressivement des expériences automatisées dans la chaîne CI/CD (préproduction) : chaque version est ainsi vérifiée face aux pannes connues.
Mon suivi
Connectez-vous pour suivre votre progression et prendre des notes. Se connecter
Articles recommandés
Kubernetes : fiabilité et mise à l'échelle (probes, ressources, HPA, PDB)
Rendre une application résiliente dans Kubernetes : liveness, readiness et startup probes, reques...
Mesurer des SLI avec Prometheus
Implémenter des SLI de disponibilité et de latence avec Prometheus : métriques nécessaires, requê...
Les SLO Dynatrace : Comprendre et Gérer les Objectifs de Niveau de Service
Découvrez comment utiliser les SLO (Service Level Objectives) dans Dynatrace pour définir et surv...
Alertes, connecteurs et SLO dans Kibana
Créer des règles d'alerte dans Kibana (requête Elasticsearch, ES|QL, seuil personnalisé, logs), c...
Grafana Alerting et gestion des astreintes
Créer des alertes dans Grafana (règles, points de contact, politiques de notification), les provi...
CI/CD de bout en bout (5/5) : GitHub Actions, GitLab CI, Jenkins et Argo CD en pratique
Comparer et utiliser les outils CI/CD : GitHub Actions, GitLab CI, Jenkins, Argo CD et Flux ; pip...
Comprendre AWS : infrastructure mondiale, comptes, outils et tarification
Les bases indispensables pour démarrer sur Amazon Web Services : régions, zones de disponibilité ...
XLA : Pourquoi l'Expérience Utilisateur est le nouveau standard de l'Observabilité
Découvrez le concept de XLA (Experience Level Agreements), la différence avec les SLAs traditionn...
Monitors, SLO, dashboards et Datadog as code
Créer des monitors efficaces (métriques, logs, APM, composites, anomalies), des SLO, des dashboar...