1. Qu’est-ce qu’un bucket ? #
L’unité de stockage de Grail.
Définition #
Dans Grail, chaque enregistrement (ligne de log, span, événement, événement métier) est stocké dans un bucket. Un bucket est un conteneur logique qui a trois propriétés : la table qu'il alimente (logs, spans, events, bizevents…), sa durée de rétention en jours, et les droits qui permettent d'y lire. C'est l'outil qui permet de ne pas traiter toutes les données de la même façon.
À savoir : Les métriques ne passent pas par les buckets de la même façon : leur conservation et leur résolution sont gérées par la plateforme. Les buckets concernent surtout les logs, les spans, les événements et les événements métier.
Les buckets par défaut #
Chaque environnement dispose de buckets par défaut, qui reçoivent les données tant qu'aucune règle ne les envoie ailleurs, et de buckets système en lecture seule.
| Bucket | Table | Contenu |
|---|---|---|
default_logs | logs | tous les logs non routés ailleurs |
default_spans | spans | traces distribuées |
default_events | events | événements (déploiements, Davis, personnalisés) |
default_bizevents | bizevents | événements métier |
dt_system_…, dt_… | selon le cas | données système (facturation, audit) : lecture seule |
Selon la version : La liste exacte et la rétention par défaut (de l'ordre de 10 jours pour les spans et 35 jours pour les logs et les événements) dépendent de votre contrat et de la version de la plateforme : vérifiez-les dans Storage management.
2. Pourquoi créer ses propres buckets #
Quatre bonnes raisons.
Les motivations #
| Besoin | Exemple | Bucket dédié |
|---|---|---|
| Rétention différente | audit conservé 1 an, debug 7 jours | logs_audit_1y, logs_debug_7d |
| Droits d’accès | logs de sécurité visibles par la seule équipe sécurité | logs_security |
| Coût | ne pas payer 35 jours de rétention pour des logs verbeux | logs_debug_7d |
| Performance des requêtes | interroger un bucket ciblé plutôt que tous les logs | un bucket par grand usage |
Mesurer avant de découper #
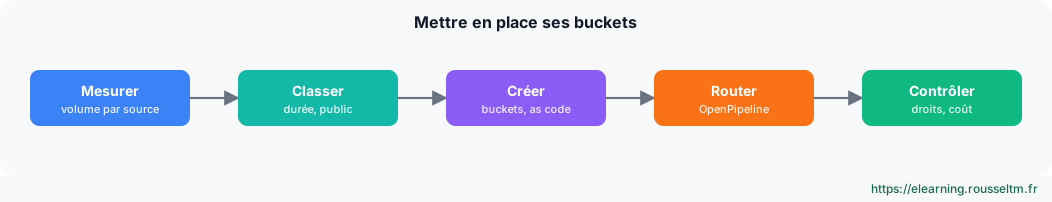
Commencez par regarder d'où viennent les volumes : quelques sources représentent souvent l'essentiel des données.
// Volume ingéré par bucket et par source sur 7 jours (avant de décider d'une stratégie)
fetch logs, from: -7d
| summarize lignes = count(), by: { dt.system.bucket, log.source }
| sort lignes desc
| limit 30
Bonne pratique : Visez quelques buckets bien pensés (par durée de conservation et par public), pas un bucket par application : trop de buckets compliquent les droits, les requêtes et la maintenance, et leur nombre par environnement est limité.
3. Créer un bucket #
Interface, API ou Terraform.
Dans l’interface #
- Ouvrez Storage management (menu Manage ou Settings, selon la version).
- Choisissez Create bucket.
- Renseignez le nom technique (minuscules, chiffres et tirets bas, sans préfixe réservé comme
dt_oudefault_), le nom affiché, la table et la rétention en jours. - Enregistrez : le bucket passe à l'état actif après quelques instants.
Erreur courante : Choisir le nom à la légère : il apparaît dans les règles de routage, les politiques IAM et les requêtes, et ne peut pas être renommé. Adoptez une convention, par exemple<table>_<usage>_<durée>(logs_audit_1y).
Par l’API et en Terraform #
La gestion des buckets passe par l'API de la plateforme (apps.dynatrace.com) avec un jeton de plateforme ou un client OAuth ayant les droits sur les définitions de buckets :
curl -X POST "https://abc12345.apps.dynatrace.com/platform/storage/management/v1/bucket-definitions" \
  -H "Authorization: Bearer $DT_PLATFORM_TOKEN" -H "Content-Type: application/json" \
  -d '{
    "bucketName": "logs_audit_1y",
    "displayName": "Logs d’audit (1 an)",
    "table": "logs",
    "retentionDays": 365
  }'
curl -H "Authorization: Bearer $DT_PLATFORM_TOKEN" \
"https://abc12345.apps.dynatrace.com/platform/storage/management/v1/bucket-definitions"resource "dynatrace_platform_bucket" "audit" {
name = "logs_audit_1y"
display_name = "Logs d’audit (1 an)"
table = "logs"
retention = 365
}Selon la version : Les noms exacts des points d'API, des permissions et de la ressource Terraform peuvent évoluer : vérifiez la référence de l'API Storage management et du provider Terraform Dynatrace de votre version.
Bonne pratique : Déclarez les buckets en code (Terraform ou Monaco) avec les règles OpenPipeline et les politiques IAM qui les utilisent : l'ensemble se recrée à l'identique dans un autre environnement.
4. Router les données #
OpenPipeline décide du bucket.
Les règles de stockage #
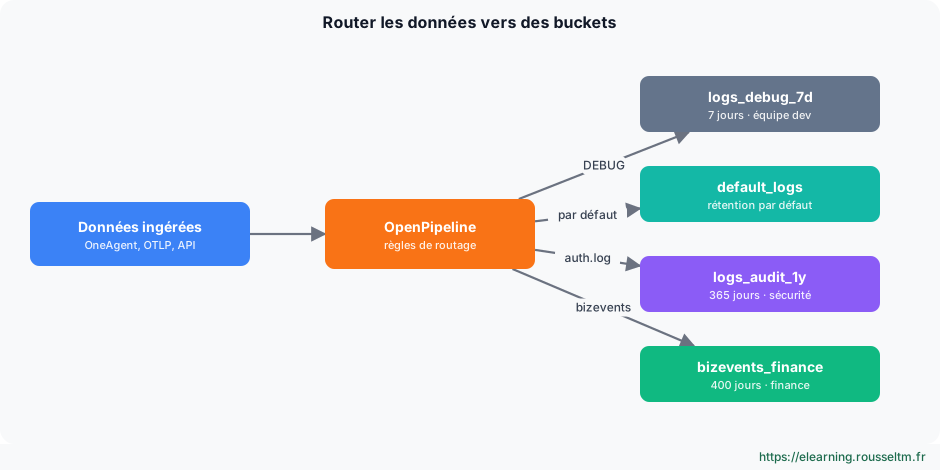
Un bucket vide ne sert à rien : il faut y envoyer des données. Dans OpenPipeline, chaque pipeline se termine par une étape de stockage qui affecte les enregistrements à un bucket selon une condition DQL. Les enregistrements qui ne correspondent à aucune règle vont dans le bucket par défaut.
// Condition de routage (OpenPipeline) : logs d'authentification Linux vers le bucket d'audit
matchesValue(log.source, "/var/log/auth.log") or matchesValue(log.source, "/var/log/secure")

// Logs de débogage d'un namespace vers le bucket court
k8s.namespace.name == "boutique" and loglevel == "DEBUG"
Détails sur les pipelines, le routage et le traitement dans Logs avancés avec OpenPipeline.
À savoir : Le routage s'applique aux données reçues après sa mise en place : les données déjà stockées restent dans leur bucket d'origine jusqu'à la fin de leur rétention.
Selon la version : Sur les environnements qui n'ont pas encore migré vers OpenPipeline pour les logs, l'affectation se fait par les règles d'attribution de bucket du traitement des logs (Log Monitoring) ; le principe est le même.
5. Interroger et contrôler #
DQL et droits IAM.
Cibler un bucket en DQL #
Chaque enregistrement porte le nom de son bucket dans le champ dt.system.bucket. Filtrer dessus réduit le volume lu, donc le temps de réponse et le coût de la requête.
// Ne lire que le bucket d'audit
fetch logs, from: -30d
| filter dt.system.bucket == "logs_audit_1y"
| filter contains(content, "sudo")
| fields timestamp, host.name, content
| sort timestamp desc
// Lister les buckets de l'environnement et leur rétention
fetch dt.system.buckets
| fields name, table, retentionDays, status
| sort name ascSelon la version : La liste des buckets par DQL (fetch dt.system.buckets) et ses champs dépendent de la version ; l'application Storage management donne la même information.Les droits par bucket #
Les politiques IAM peuvent limiter la lecture à certains buckets, et réserver la création et la modification des buckets aux administrateurs :
// Équipe sécurité : lecture des logs du seul bucket d'audit
ALLOW storage:logs:read, storage:buckets:read
  WHERE storage:bucket-name = "logs_audit_1y";

// Administrateurs de la plateforme : création et modification des buckets
ALLOW storage:bucket-definitions:read, storage:bucket-definitions:write;
Principes et organisation des droits : Gérer les permissions.
Erreur courante : Donner storage:logs:read sans condition : la personne lit alors tous les buckets de logs, y compris l'audit. Ajoutez la condition sur le nom du bucket.6. Modifier, vider, supprimer #
Des opérations à manier avec soin.
Les effets #
| Opération | Effet |
|---|---|
| Augmenter la rétention | les données déjà présentes sont conservées plus longtemps |
| Réduire la rétention | les données plus anciennes que la nouvelle durée sont supprimées |
| Vider le bucket | toutes ses données sont supprimées, le bucket reste |
| Supprimer le bucket | le bucket et ses données disparaissent ; les règles qui l’utilisent doivent être corrigées |
Erreur courante : Réduire une rétention pour faire des économies sans vérifier les obligations légales ou contractuelles : la suppression est définitive. Documentez la durée retenue pour chaque bucket (voir La rétention des données dans Dynatrace).
7. Coûts #
Ce que la rétention coûte.
Ce qui est facturé #
Avec la licence DPS, les données Grail sont facturées à l'ingestion, à la rétention (volume conservé multiplié par la durée) et aux requêtes (volume lu). Le choix du bucket agit donc directement sur la facture (voir Licences Dynatrace et Licensing et FinOps).
- Envoyez les logs verbeux dans un bucket court plutôt que de les garder 35 jours.
- Pour un indicateur de long terme, extrayez une métrique dans OpenPipeline et gardez le log brut peu de temps.
- Supprimez à l'ingestion ce qui ne sert jamais (sondes de santé, logs de bibliothèques bavardes).
Selon la version : Selon le contrat, certaines offres de rétention incluent une partie des requêtes : comparez les options de votre abonnement avant de fixer les durées.
8. Commandes à connaître et TP #
L’aide-mémoire et un exercice guidé.
Commandes à connaître #
| Action | Commande ou écran |
|---|---|
| Voir les buckets et leur rétention | Storage management, ou fetch dt.system.buckets |
| Créer un bucket | POST /platform/storage/management/v1/bucket-definitions |
| Mesurer le volume par bucket | fetch logs | summarize count(), by: { dt.system.bucket } |
| Lire un seul bucket | | filter dt.system.bucket == "…" |
| Router vers un bucket | OpenPipeline, étape de stockage avec une condition DQL |
| Restreindre la lecture | WHERE storage:bucket-name = "…" |
TP : un bucket d’audit #
- Mesurez le volume des logs d'authentification Linux sur 7 jours (
log.sourcecontenantauth.logousecure). - Créez le bucket
logs_audit_1y(table logs, 365 jours), dans l'interface ou par l'API. - Dans OpenPipeline, ajoutez une règle de stockage qui envoie ces logs vers le nouveau bucket.
- Provoquez quelques connexions SSH sur un hôte supervisé, puis vérifiez avec la requête de la section 5 que les nouvelles lignes arrivent dans
logs_audit_1y. - Créez une politique IAM qui réserve la lecture de ce bucket au groupe sécurité, et testez avec un compte qui n'en fait pas partie.
Résultat attendu : les logs d'authentification sont conservés un an, lisibles par la seule équipe sécurité, et les autres logs gardent la rétention par défaut.
