1. Pourquoi un pipeline de données ? #
Le problème que Cribl résout.
Le constat #
Les entreprises envoient leurs logs, métriques et traces directement vers leurs outils : SIEM, plateforme d'observabilité, archive. Chaque source est reliée à chaque outil, chaque outil facture le volume reçu, et changer d'outil oblige à reconfigurer des centaines d'agents. Un pipeline de données s'intercale entre les sources et les destinations pour router, réduire, enrichir et normaliser les données en un seul endroit.
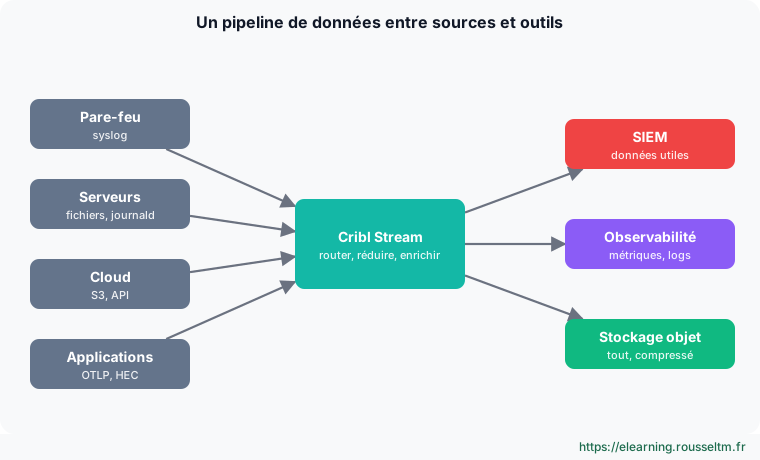
Ce que l'on gagne #
- Coût : ne pas indexer dans le SIEM ce qui n'y sert pas (trafic autorisé, champs vides, doublons) ; il est courant de réduire de 30 à 50 % le volume envoyé.
- Liberté : changer ou ajouter un outil sans toucher aux sources ; envoyer la même donnée à deux outils pendant une migration.
- Qualité : normaliser les formats, ajouter du contexte (équipe, géolocalisation, criticité), masquer les données personnelles avant qu'elles ne quittent l'entreprise.
- Rétention : garder 100 % des données brutes à bas coût sur stockage objet et les rejouer à la demande.
2. La suite Cribl #
Cinq produits complémentaires.
Les produits #
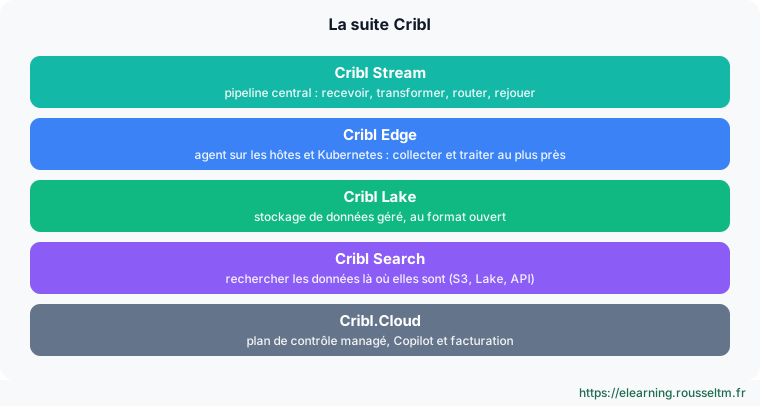
| Produit | Rôle | Où il tourne |
|---|---|---|
| Cribl Stream | le pipeline central : sources, routes, pipelines, destinations, rejeu | vos serveurs, Kubernetes ou Cribl.Cloud |
| Cribl Edge | agent léger : fichiers, journald, événements Windows, métriques, Kubernetes | sur chaque hôte ou nœud |
| Cribl Lake | stockage géré de jeux de données, rétention par jeu | Cribl.Cloud |
| Cribl Search | recherche fédérée là où sont les données (S3, Lake, API), sans les réingérer | Cribl.Cloud |
| Cribl.Cloud | plan de contrôle managé, espaces de travail, Copilot (assistant IA) | SaaS |
À savoir : Cette formation se concentre sur Cribl Stream, le cœur de la suite, et couvre Edge, Lake et Search dans leurs rôles de collecte, de stockage et de recherche.
3. Le modèle de traitement #
Sources, routes, pipelines, destinations.
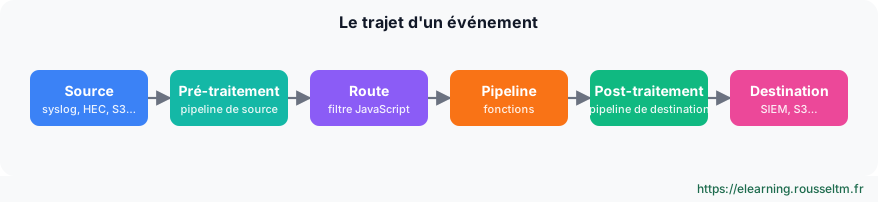
Le trajet d'un événement #
| Notion | Définition |
|---|---|
| Source | point d'entrée des données : écoute (syslog, HEC, OTLP) ou collecte (S3, API REST) |
| Route | règle ordonnée : un filtre JavaScript, un pipeline, une destination |
| Pipeline | suite de fonctions appliquées aux événements |
| Fonction | traitement unitaire : Parser, Eval, Drop, Mask, Lookup, Aggregations… |
| Destination | sortie : Splunk, Elastic, Datadog, S3, Kafka, Loki, Cribl Lake… |
| Pack | ensemble réutilisable de routes, pipelines et données de référence |
L'événement Cribl #
Un événement est un objet JSON. Quelques champs ont un sens particulier :
| Champ | Signification |
|---|---|
_raw | le texte d'origine de l'événement |
_time | horodatage en secondes depuis l'époque Unix |
host, source, sourcetype, index | métadonnées héritées du monde Splunk, utilisées pour filtrer et router |
__inputId, __* | champs internes (deux soulignés) : utilisables dans les filtres, jamais envoyés aux destinations |
cribl_* | informations ajoutées par Cribl (pipeline, découpage) |
4. Licences et versions #
Commencer gratuitement.
Les offres #
- Gratuit : jusqu'à 1 To par jour, sur Cribl.Cloud ou en auto-hébergé. En auto-hébergé, la licence gratuite impose l'envoi de télémétrie anonymisée à Cribl et se limite à un seul groupe de Workers.
- Payant (Standard, Enterprise) : volumes supérieurs, plusieurs groupes de Workers, RBAC, authentification unique, support ; sur Cribl.Cloud, la consommation est décomptée en crédits.
- Versions : une version mineure environ tous les deux mois (4.17 en mars 2026, 4.19 en juillet, 4.20 ensuite) ; sur Cribl.Cloud, un canal de publication « Regular » ou « Slow » par espace de travail.
Bonne Pratique : Cribl University propose gratuitement des cours et des parcours de certification (Cribl Certified User, puis Admin Stream ou Edge, puis Engineer) : un bon complément à cette formation.
5. Cribl et les alternatives #
Où se place Cribl.
Comparaison #
| Outil | Point fort | Différence avec Cribl Stream |
|---|---|---|
| OpenTelemetry Collector | standard ouvert, gratuit, natif OTLP | configuration YAML, pas d'interface ni d'aperçu des données, écosystème sécurité moins riche |
| Bindplane | gestion de flottes de collecteurs OpenTelemetry | repose sur OpenTelemetry ; Cribl a son propre moteur et son format d'événement |
| Vector | très performant, open source (Datadog) | configuration en fichiers, pas de plan de contrôle graphique |
| Logstash, Fluent Bit | historiques, gratuits, très répandus | pas de routage multi-outils centralisé ni de rejeu intégré |
| Cribl Stream | interface avec aperçu avant/après, rejeu, plus de 100 intégrations, orienté SIEM | logiciel propriétaire, payant au-delà de 1 To par jour |
Commandes à connaître #
Commandes à connaître
docker run -d -p 9000:9000 cribl/cribl:latest: lancer Cribl Stream en local/opt/cribl/bin/cribl status: état du service/opt/cribl/bin/cribl version: version installéesourcetype=='pan:traffic': exemple de filtre de route
Sources #
Vérifié en novembre 2026 (Cribl 4.20) : Cribl publie une version mineure environ tous les deux mois, consultez les notes de version avant de vous appuyer sur un détail.
Mon suivi
Connectez-vous pour suivre votre progression et prendre des notes. Se connecter
💬 Questions sur cette leçon
Aucune question pour l'instant : soyez le premier à demander de l'aide ou à partager votre configuration.
Articles recommandés
Bonnes pratiques Cribl Stream et Edge
Les bonnes pratiques pour exploiter Cribl en production : conception des routes et pipelines, nom...
Archiver, rejouer et rechercher : S3, Replay, Cribl Lake et Cribl Search
Garder toutes les données à bas coût et les retrouver à la demande : destination S3 partitionnée,...
Réduire, transformer et optimiser les volumes avec Cribl
Réduire le volume envoyé aux SIEM et outils d'observabilité sans perdre d'information utile : Dro...
Cribl Edge : collecter au plus près des sources
Déployer Cribl Edge sur Linux, Windows et Kubernetes : rôle de l'agent, flottes et sous-flottes, ...
Sources, destinations et routes dans Cribl Stream
Recevoir et envoyer des données avec Cribl Stream : sources push, pull, collecteurs et internes, ...
Cribl Stream en production : architecture distribuée, files persistantes et supervision
Passer Cribl Stream en production : Leader, groupes de Workers et processus, commit et déploiemen...
Pipelines et fonctions : parser, enrichir, masquer
Construire des pipelines Cribl Stream : pré-traitement, traitement et post-traitement, catalogue ...
Installer et administrer Cribl Stream
Installer Cribl Stream en Docker ou sur Linux, le lancer comme service, comprendre $CRIBL_HOME, d...
Automatiser Cribl : API REST, Packs, Git et Terraform
Gérer Cribl comme du code : API REST (authentification, chemins par groupe, commit et déploiement...