1. De l'alerte à l'incident #
Un parcours outillé.
Cycle #
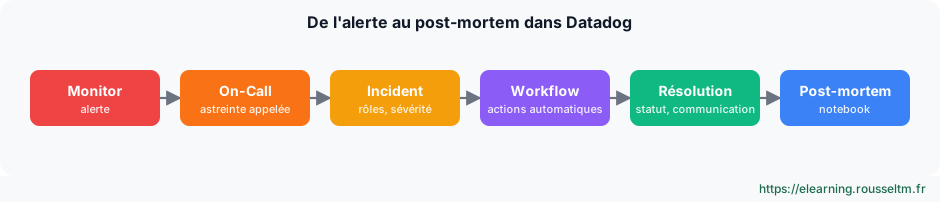
| Étape | Outil | Bonne pratique |
|---|---|---|
| Détecter | Monitors (métrique, logs, APM, composite, anomalies) | Alerter sur le symptôme (SLO, erreurs utilisateur), pas sur chaque cause |
| Appeler | On-Call (plannings, escalades) ou outil tiers (PagerDuty, Opsgenie) | Une politique d'escalade par équipe, via le Software Catalog |
| Coordonner | Incident Management (rôles, sévérité, chronologie) | Un commandant d'incident, une communication régulière |
| Agir | Workflow Automation, runbooks liés | Automatiser les premières actions sûres |
| Apprendre | Post-mortem généré depuis l'incident | Actions de suivi assignées et suivies |
2. Workflow Automation #
Automatiser sans code.
Exemples #
- À la création d'un incident SEV-1 : créer un canal Slack, inviter l'équipe propriétaire, ouvrir un ticket Jira.
- Sur un monitor « disque presque plein » : lancer un nettoyage via une action ou un webhook, puis vérifier la métrique.
- Sur un signal de sécurité : isoler un utilisateur dans l'IdP après validation humaine.
Erreur Courante : Une remédiation automatique sans garde-fou peut aggraver un incident (redémarrages en boucle). Prévoyez une étape d'approbation humaine pour les actions destructrices et une limite de fréquence.
Mon suivi
Connectez-vous pour suivre votre progression et prendre des notes. Se connecter
💬 Discussions récentes de la formation
- Datadog : relier traces, logs et métriques du même service✓ résolu · 1 réponse(s)
Poser une question sur cette leçon →Voir toutes les discussions de la formation
Articles recommandés
Monitors, SLO, dashboards et Datadog as code
Créer des monitors efficaces (métriques, logs, APM, composites, anomalies), des SLO, des dashboar...
Bonnes pratiques Datadog : tags, coûts, alertes et gouvernance
Check-list pour exploiter Datadog efficacement : tagging unifié, maîtrise des coûts (hôtes, logs,...
Datadog sur Kubernetes : Operator, Cluster Agent et Autodiscovery
Superviser Kubernetes avec Datadog : Datadog Operator et ressource DatadogAgent, Cluster Agent, A...
Coûts et gouvernance Datadog : usage, attribution, RBAC et politiques de tags
Maîtriser la facture et gouverner Datadog : suivi de l'usage et de l'estimation, attribution des ...
Release monitoring dans Dynatrace : versions, événements de déploiement et suivi des incidents
Suivre les versions déployées dans Dynatrace : variables DT_RELEASE, labels Kubernetes, événement...
Exploiter l'API Dynatrace v2 : Guide Complet de l'Automatisation
Apprenez à utiliser l'API Dynatrace pour automatiser votre observabilité : gestion des scopes, ro...
Dashboards et notebooks Datadog : widgets, template variables et bonnes pratiques
Concevoir des dashboards Datadog utiles : types de widgets, template variables, groupes, Powerpac...
APM Datadog avancé : échantillonnage, rétention, profiler et Software Catalog
Aller plus loin avec l'APM Datadog : contrôle d'ingestion et échantillonnage, filtres de rétentio...
RUM et Synthetic Monitoring avec Datadog : synthetic transaction monitoring et expérience utilisateur
Mesurer l'expérience utilisateur avec Datadog : RUM navigateur et mobile, Core Web Vitals, Sessio...