1. Enrichir #
Ajouter du contexte.
Les filtres d'enrichissement #
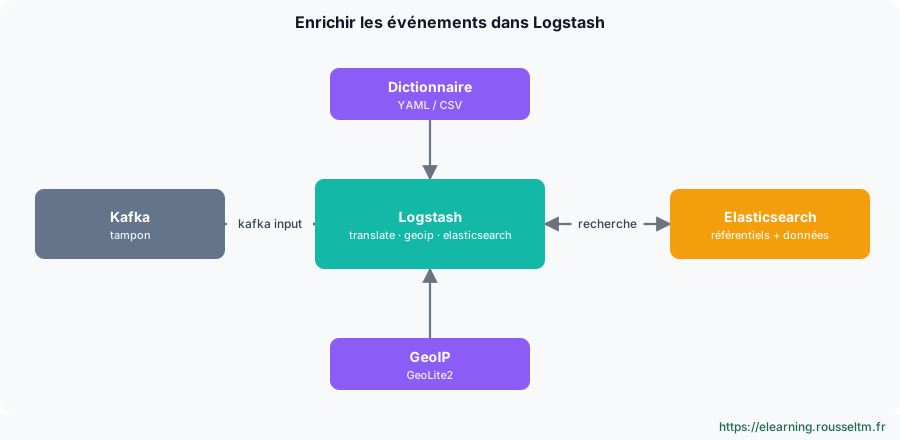
filter {
  translate {
    source => "[http][response][status_code]"
    target => "[http][response][status_label]"
    dictionary => { "200" => "ok" "404" => "introuvable" "500" => "erreur serveur" }
    fallback => "autre"
  }
  geoip { source => "[source][ip]" target => "[source]" }
  elasticsearch {
    hosts => ["https://es:9200"]
    index => "referentiel-serveurs"
    query => "host.name:%{[host][name]}"
    fields => { "equipe" => "[labels][equipe]" }
  }
}| Filtre | Source | Attention |
|---|---|---|
| translate | dictionnaire en ligne ou fichier (rechargé) | idéal pour les petites tables |
| geoip | bases GeoLite2 téléchargées automatiquement | hors ligne : fournir la base avec database |
| elasticsearch | requête par événement | coûteux : à réserver aux faibles volumes |
| jdbc_static / jdbc_streaming | base relationnelle | jdbc_static met en cache localement |
2. Kafka #
Découpler la collecte.
Consommer un topic #
input {
  kafka {
    bootstrap_servers => "kafka-1:9092,kafka-2:9092"
    topics => ["logs-web"]
    group_id => "logstash-web"
    consumer_threads => 3      # au plus le nombre de partitions
    codec => json
  }
}
Kafka absorbe les pics et les arrêts de Logstash ou d'Elasticsearch : les collecteurs écrivent toujours, Logstash rattrape son retard. Plusieurs instances Logstash du même group_id se partagent les partitions.
3. Tester ses pipelines #
Avant la production.
Vérifier la syntaxe et le comportement #
bin/logstash -f web.conf --config.test_and_exit      # syntaxe
bin/logstash -f web.conf --config.reload.automatic   # rechargement à chaud en développement
echo '127.0.0.1 - - [09/Nov/2026:10:00:00 +0100] "GET / HTTP/1.1" 200 512' | bin/logstash -f web.conf
Bonne pratique : Gardez des lignes de log réelles comme jeux d'essai et une sortiestdout { codec => rubydebug }en développement ; surveillez les tags_grokparsefailureet_dissectfailureen production.
4. Superviser #
API et Stack Monitoring.
Les sources #
- L'API de supervision (port 9600) :
_node/stats,_node/stats/pipelines,_node/hot_threads. - L'intégration Logstash d'Elastic Agent alimente Stack Monitoring dans Kibana (débit, latence, file, JVM) ; l'ancienne collecte interne
xpack.monitoringest dépréciée. - La gestion centralisée des pipelines depuis Kibana existe, selon la licence.
Selon la version : la collecte interne de supervision est dépréciée depuis la 8.x ; privilégiez Elastic Agent et l'intégration Logstash.
5. Logstash sur Kubernetes #
Avec ECK.
La ressource Logstash #
apiVersion: logstash.k8s.elastic.co/v1alpha1
kind: Logstash
metadata:
  name: logstash
spec:
  count: 2
  version: 9.1.0
  elasticsearchRefs:
    - name: elasticsearch
      clusterName: prod
  pipelines:
    - pipeline.id: main
      config.string: |
        input { beats { port => 5044 } }
        output {
          elasticsearch {
            hosts => [ "${PROD_ES_HOSTS}" ]
            user => "${PROD_ES_USER}"
            password => "${PROD_ES_PASSWORD}"
            ssl_certificate_authorities => "${PROD_ES_SSL_CERTIFICATE_AUTHORITY}"
          }
        }
  services:
    - name: beats
      service:
        spec:
          type: ClusterIP
          ports: [{ port: 5044, name: beats, protocol: TCP, targetPort: 5044 }]
À savoir : ECK injecte l'adresse, l'utilisateur et le certificat du cluster référencé sous forme de variables (PROD_ES_*pourclusterName: prod) et crée un volume persistant pour les données (PQ, DLQ).
6. Logstash ou ingest pipeline ? #
Choisir où transformer.
Comparatif #
| Critère | Logstash | Ingest pipeline |
|---|---|---|
| Sources | très nombreuses (Kafka, JDBC, S3, syslog…) | ce qui arrive dans Elasticsearch |
| Sorties | multiples (Elasticsearch, S3, Kafka…) | Elasticsearch |
| Exploitation | un service de plus à opérer | intégré au cluster |
| Cas typique | routage, multi-destinations, tampon | intégrations Elastic Agent, parsing simple |
Mon suivi
Connectez-vous pour suivre votre progression et prendre des notes. Se connecter
💬 Questions sur cette leçon
Aucune question pour l'instant : soyez le premier à demander de l'aide ou à partager votre configuration.
Glossaire de la formation
Observabilité
La capacité à connaître l'état interne d'un système à partir des données qu'il émet.Ces données sont classées en 3 piliers : logsmétriquestracesprofil...
Elastic Common Schema (ECS)
Une spécification open source qui permet de structurer vos données de manière homogène dans l'écosystème Elastic.
Logstash
Moteur de collecte de données permettant de traiter, d'enrichir et de transformer les logs et autres événements avant de les indexer.
Access Log
Fichier de journalisation enregistrant les requêtes traitées par un serveur web (Apache, Nginx, Lighttpd, etc.). Il permet de tracer l'activité du ser...
Client IP
L'adresse IP de l'utilisateur effectuant la requête vers le serveur web. Lorsqu'un utilisateur passe par un Load Balancer ou un proxy (ex: Cloudflare)...
Timestamp
La date et l'heure exactes auxquelles la requête a été reçue par le serveur.Configuration : %t dans Apache, $time_local ou $time_iso8601 dans Nginx.
Request
La ligne de requête initiale du client. Elle comprend généralement la méthode HTTP (ex: GET), l'URL demandée et la version du protocole HTTP.Configura...
Status Code
Le code de statut HTTP final renvoyé par le serveur au client (ex : 200 pour un succès, 404 pour ressource non trouvée).Configuration : %>s dans Apach...
Size
Le volume des données renvoyées au client, mesuré en octets (généralement sans les en-têtes HTTP).Configuration : %b ou %O dans Apache, $body_bytes_se...
Referrer
L'URL de la page web depuis laquelle le client a cliqué ou suivi un lien pour accéder à la ressource actuelle.Configuration : %{Referer}i dans Apache,...
User-Agent
Les informations d'identification fournies par le client concernant son navigateur, son système d'exploitation et son appareil. Sa structure standard ...
Response Time
La durée totale prise par le serveur pour traiter la requête et renvoyer la réponse au client.Configuration : %D (microsecondes) ou %T (secondes) dans...
Articles recommandés
Transforms et enrich : résumer et enrichir les données dans Elasticsearch
Créer des index centrés sur les entités avec les transforms pivot et latest, et enrichir les docu...
Logstash en production : files persistantes, DLQ et multi-pipelines
Rendre Logstash fiable en production : file persistante, dead letter queue, plusieurs pipelines e...
Elasticsearch sur Kubernetes avec ECK : déploiement, stockage persistant et mises à jour
Déployer Elasticsearch et Kibana sur Kubernetes avec Elastic Cloud on Kubernetes (ECK) : opérateu...
Logstash : les entrées (inputs) et les sorties (outputs)
Version écrite des leçons vidéo : les inputs courants (beats, file, tcp/udp, http, kafka, jdbc) e...
Logstash : gérer les plugins et adopter Elastic Common Schema (ECS)
Version écrite des leçons vidéo : lister, installer, mettre à jour et embarquer hors ligne les pl...
Elastic Agent sur Kubernetes
Déployer Elastic Agent sur Kubernetes : DaemonSet géré par Fleet, intégration Kubernetes, kube-st...
Logstash : rôle, concept de pipeline et installation
Version écrite des leçons vidéo : à quoi sert Logstash, comment fonctionne un pipeline (inputs, f...
Logstash : les filtres, grok et dissect
Version écrite des leçons vidéo : les filtres essentiels (mutate, date, json, kv, drop), le plugi...
Machine learning dans Elastic : détection d'anomalies et AIOps
Détecter automatiquement les comportements anormaux : jobs de détection d'anomalies, datafeeds, d...