1. OpenSearch en bref #
Un moteur de recherche et d'analyse open source.
Présentation #
OpenSearch est un moteur de recherche et d'analyse distribué, construit sur Apache Lucene, et sa console OpenSearch Dashboards. Il sert à la recherche applicative, à l'analyse de logs, à l'observabilité, à la sécurité et, de plus en plus, à la recherche vectorielle. Tous ses composants sont publiés sous licence Apache 2.0.
Son histoire avec Elasticsearch #
En 2021, Elastic a quitté la licence Apache 2.0 pour Elasticsearch et Kibana. AWS et des contributeurs ont alors créé OpenSearch à partir des dernières versions sous Apache 2.0 (7.10). Depuis 2024, le projet est hébergé par l'OpenSearch Software Foundation, au sein de la Linux Foundation. Elastic a de son côté ajouté une option AGPL à ses licences en 2024.
| Point | OpenSearch | Elasticsearch |
|---|---|---|
| Licence | Apache 2.0 | Elastic License, SSPL ou AGPL selon le choix |
| Sécurité, alerting, ISM | Plugins inclus | Selon l’abonnement |
| Cycle de vie des index | ISM (_plugins/_ism) | ILM |
| Langages | DSL, SQL, PPL | DSL, SQL, ES|QL |
| Console | OpenSearch Dashboards | Kibana |
Les deux projets ont divergé. Les concepts et une grande partie de l'API restent communs, mais ne supposez pas la compatibilité d'une configuration, d'un client ou d'un plugin : vérifiez. Certains clients officiels Elasticsearch refusent de se connecter à OpenSearch ; utilisez les clients OpenSearch.
2. Les concepts #
Index, shards et répliques.
Le vocabulaire #
| Concept | Sens |
|---|---|
| Document | Un objet JSON |
| Index | Une collection de documents |
| Shard | Un morceau d’index, qui est un index Lucene |
| Primaire / réplique | L’original et sa copie |
| Mapping | Le type de chaque champ |
| Cluster manager | Nœud gérant l’état du cluster : l’ancien « master » |
Le cluster #
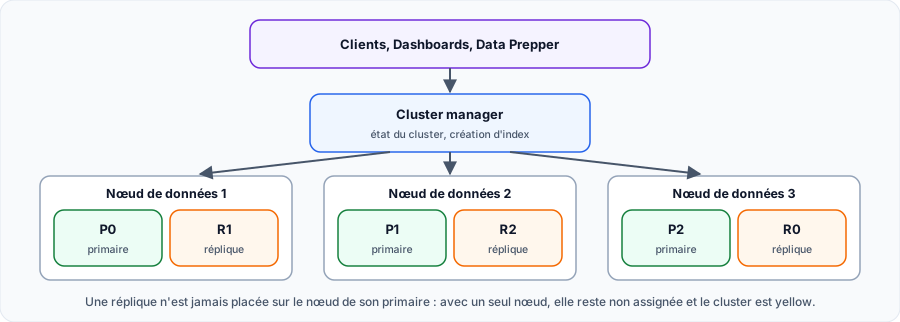
| État | Sens | Que faire ? |
|---|---|---|
| green | Tous les shards sont assignés | Rien |
| yellow | Des répliques ne sont pas assignées | Normal avec un seul nœud ; sinon, ajouter un nœud |
| red | Des primaires manquent | Urgence : des données sont indisponibles |
3. Les composants #
Ce qui entoure le moteur.
L'écosystème #
| Composant | Rôle |
|---|---|
| OpenSearch Dashboards | Exploration, visualisations, administration |
| Data Prepper | Collecte et transformation, recommandé pour l’ingestion |
| Plugins inclus | Security, Alerting, Index Management, SQL/PPL, k-NN, Observability, Anomaly Detection… |
L'archive officielle 3.9 embarque ces plugins et son propre JDK ; vous pouvez les lister avec GET _cat/plugins.
Mon suivi
Connectez-vous pour suivre votre progression et prendre des notes. Se connecter
Articles recommandés
Data streams et templates Elasticsearch : component templates, index templates et séries temporelles
Gérer les données horodatées avec les data streams : index templates et component templates, conv...
Index Lifecycle Management (ILM) : data tiers, rollover et rétention
Automatiser le cycle de vie des index avec ILM : data tiers hot, warm, cold et frozen, rollover p...
Différences entre Technologies et Services dans Dynatrace
Dans Dynatrace, les concepts de 'Technologie' et de 'Services' aident à organiser et surveiller l...
Dynatrace : Différences entre SQL Modifications, SQL Queries or Procedures, et SQL Transactions
Cet article détaille les différences entre trois concepts essentiels dans l'exécution des instruc...
Cross-cluster search et cross-cluster replication : architectures multi-clusters Elasticsearch
Concevoir des architectures multi-clusters Elasticsearch : clusters distants, cross-cluster searc...
Kibana : rôle, installation et premiers pas
Ce qu'est Kibana dans la suite Elastic, comment l'installer avec Elasticsearch (start-local, Dock...
Ingestion Elasticsearch : Bulk API, ingest pipelines, enrich et reindex
Ingérer et transformer des données dans Elasticsearch : Bulk API, ingest pipelines et processeurs...
Grafana Loki vs Elasticsearch : La bataille du stockage de logs
Comparatif entre Loki, le système de logs inspiré par Prometheus, et Elasticsearch, le moteur de ...
Explorer ses données dans Discover : KQL, Lucene et ES|QL
Rechercher et analyser des logs dans Kibana Discover : filtres, KQL, syntaxe Lucene, et le langag...