1. OpenSearch en bref #
Un moteur de recherche et d'analyse open source.
Présentation #
OpenSearch est un moteur de recherche et d'analyse distribué, construit sur Apache Lucene, et sa console OpenSearch Dashboards. Il sert à la recherche applicative, à l'analyse de logs, à l'observabilité, à la sécurité et, de plus en plus, à la recherche vectorielle. Tous ses composants sont publiés sous licence Apache 2.0.
Son histoire avec Elasticsearch #
En 2021, Elastic a quitté la licence Apache 2.0 pour Elasticsearch et Kibana. AWS et des contributeurs ont alors créé OpenSearch à partir des dernières versions sous Apache 2.0 (7.10). Depuis 2024, le projet est hébergé par l'OpenSearch Software Foundation, au sein de la Linux Foundation. Elastic a de son côté ajouté une option AGPL à ses licences en 2024.
| Point | OpenSearch | Elasticsearch |
|---|---|---|
| Licence | Apache 2.0 | Elastic License, SSPL ou AGPL selon le choix |
| Sécurité, alerting, ISM | Plugins inclus | Selon l’abonnement |
| Cycle de vie des index | ISM (_plugins/_ism) | ILM |
| Langages | DSL, SQL, PPL | DSL, SQL, ES|QL |
| Console | OpenSearch Dashboards | Kibana |
Les deux projets ont divergé. Les concepts et une grande partie de l'API restent communs, mais ne supposez pas la compatibilité d'une configuration, d'un client ou d'un plugin : vérifiez. Certains clients officiels Elasticsearch refusent de se connecter à OpenSearch ; utilisez les clients OpenSearch.
2. Les concepts #
Index, shards et répliques.
Le vocabulaire #
| Concept | Sens |
|---|---|
| Document | Un objet JSON |
| Index | Une collection de documents |
| Shard | Un morceau d’index, qui est un index Lucene |
| Primaire / réplique | L’original et sa copie |
| Mapping | Le type de chaque champ |
| Cluster manager | Nœud gérant l’état du cluster : l’ancien « master » |
Le cluster #
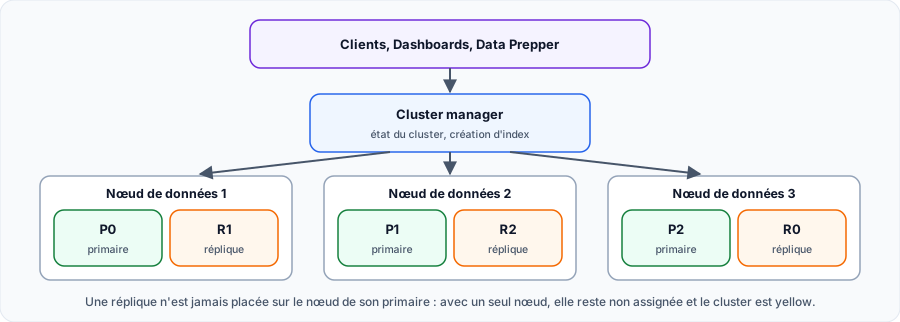
| État | Sens | Que faire ? |
|---|---|---|
| green | Tous les shards sont assignés | Rien |
| yellow | Des répliques ne sont pas assignées | Normal avec un seul nœud ; sinon, ajouter un nœud |
| red | Des primaires manquent | Urgence : des données sont indisponibles |
3. Les composants #
Ce qui entoure le moteur.
L'écosystème #
| Composant | Rôle |
|---|---|
| OpenSearch Dashboards | Exploration, visualisations, administration |
| Data Prepper | Collecte et transformation, recommandé pour l’ingestion |
| Plugins inclus | Security, Alerting, Index Management, SQL/PPL, k-NN, Observability, Anomaly Detection… |
L'archive officielle 3.9 embarque ces plugins et son propre JDK ; vous pouvez les lister avec GET _cat/plugins.
Mon suivi
Connectez-vous pour suivre votre progression et prendre des notes. Se connecter
Articles recommandés
Alimenter OpenSearch : pipelines d'ingestion et Data Prepper
Transformer les données avec les pipelines d'ingestion, collecter avec Data Prepper, recevoir l'O...
Architecture distribuée Elasticsearch : rôles des nœuds, shards, répliques et allocation
Comprendre le fonctionnement distribué d'Elasticsearch : rôles des nœuds, nœuds master et quorum,...
OpenSearch en production : ISM, sauvegardes, sécurité et bonnes pratiques
Automatiser le cycle de vie avec ISM, sauvegarder par snapshots, gérer les rôles et dimensionner ...
OpenSearch Dashboards, alertes et observabilité
Explorer ses données dans OpenSearch Dashboards, créer des moniteurs d'alerte et découvrir Trace ...
Performance et capacity planning Elasticsearch : shards, heap, indexation et benchmarks
Dimensionner et optimiser Elasticsearch : taille et nombre de shards, heap JVM, caches, réglages ...
Installer OpenSearch et OpenSearch Dashboards
Installer OpenSearch avec Docker Compose ou l'archive : mot de passe initial, vm.max_map_count, c...
Monitoring et troubleshooting Elasticsearch : santé, shards non assignés, JVM, hot threads et slow logs
Diagnostiquer un cluster Elasticsearch : cluster health et CAT APIs, shards non assignés et alloc...
Indexer et chercher dans OpenSearch : mapping, DSL, PPL et SQL
Déclarer un modèle d'index, indexer avec bulk, chercher avec le Query DSL, agréger et interroger ...
Bonnes pratiques Elasticsearch : mappings, shards, cycle de vie et exploitation
Bonnes pratiques Elasticsearch : dimensionnement des shards, mappings explicites, templates, ILM,...