1. Pourquoi des recording rules ? #
Calculer à l'avance plutôt qu'à chaque lecture.
Le problème #
Une requête PromQL est calculée au moment où on la lance. Sur un tableau de bord de vingt panneaux, actualisé toutes les trente secondes et ouvert par dix personnes, Prometheus refait sans cesse les mêmes calculs sur les mêmes échantillons. Le tableau de bord devient lent, et chaque utilisateur supplémentaire aggrave la situation.
Une recording rule (règle d'enregistrement) résout ce problème : Prometheus évalue l'expression à intervalle régulier et écrit le résultat dans une nouvelle série. Les lectures deviennent de simples accès à cette série.
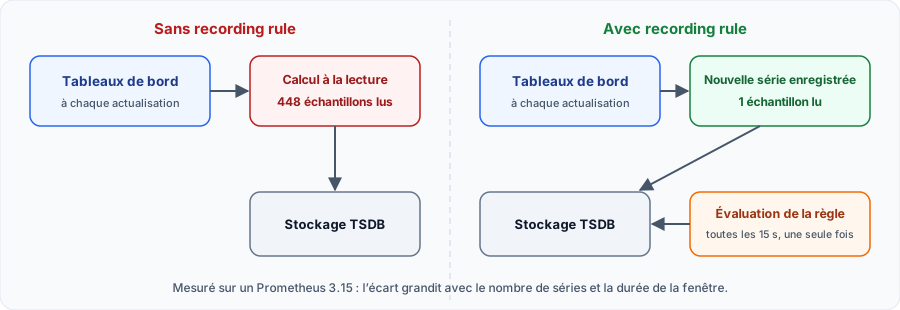
Mesure réelle : sur un Prometheus 3.15 de test, avecstats=all,sum by (job) (rate(prometheus_http_requests_total[5m]))lit 448 échantillons, et la série enregistrée équivalente un seul. L'écart est bien plus grand sur un serveur de production.
Quand en utiliser, et quand s'en passer #
| Bonne idée | Mauvaise idée |
|---|---|
| Requête coûteuse et fréquente (tableau de bord très consulté) | Requête lancée rarement, à la main |
| Alerte dont l’expression est lourde | Requête déjà rapide sur peu de séries |
| Indicateur partagé (SLI, taux d’erreur) à définir une seule fois | Conserver toutes les étiquettes d’origine : on ne réduit rien |
| Agrégats à conserver longtemps ou à fédérer | Remplacer une exploration : la fenêtre (5m) est figée |
Une règle n'est pas gratuite : chaque série enregistrée consomme du stockage et de la mémoire, comme une série collectée. Le gain vient de l'agrégation : remplacer des milliers de séries par quelques dizaines.
2. Comment Prometheus les évalue #
Groupes, intervalle, ordre et absence d'effet rétroactif.
Le fonctionnement #
- Les règles sont rangées dans des groupes, déclarés dans des fichiers référencés par
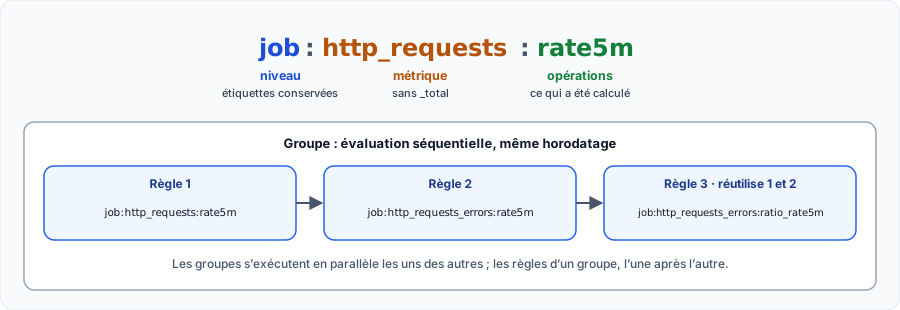
rule_files. - Dans un groupe, elles s'exécutent dans l'ordre, au même horodatage. Une règle peut donc utiliser le résultat de celle qui la précède.
- L'intervalle est celui du groupe (
interval), sinon leevaluation_intervalglobal. - Le résultat garde les étiquettes de l'expression ; le nom de la métrique est remplacé par
record. - Une règle ne calcule que le présent : une nouvelle règle n'a pas d'historique, sauf recalcul manuel (voir plus loin).
Attention à l'intervalle : une série qui n'a pas de point depuis plus de cinq minutes (le délai de recherche par défaut) n'apparaît plus dans les requêtes instantanées. Un groupe évalué toutes les dix minutes produit donc des trous.
Mon suivi
Connectez-vous pour suivre votre progression et prendre des notes. Se connecter
Glossaire de la formation
Observabilité
La capacité à connaître l'état interne d'un système à partir des données qu'il émet.Ces données sont classées en 3 piliers : logsmétriquestracesprofil...
Métriques
Mesures numériques collectées à intervalles réguliers (ex: CPU, RAM, temps de réponse) utilisées pour évaluer l'état de santé global d'un système au f...
Alerting
Processus consistant à notifier les équipes (via email, Slack, Teams) lorsqu'un événement spécifique, un dépassement de seuil ou une anomalie est déte...
Architecture
Conception globale et structurelle d'un système informatique, définissant ses différents composants, leurs relations et les principes guidant son évol...
OpenTelemetry
Framework open source fournissant des standards, APIs et SDKs pour collecter et exporter des données d'observabilité (traces, métriques, logs) de mani...
Articles recommandés
Bonnes pratiques Prometheus : métriques, cardinalité, règles et exploitation
Bonnes pratiques Prometheus : nommage des métriques, labels et cardinalité, intervalles de scrape...
Thanos Ruler : règles et alertes sur la vue globale
Évaluer des règles d'enregistrement et d'alerte sur l'ensemble des clusters avec Thanos Ruler : c...
Mesurer des SLI avec Prometheus
Implémenter des SLI de disponibilité et de latence avec Prometheus : métriques nécessaires, requê...
Mimir : ruler, Alertmanager et mimirtool
Évaluer des règles d'enregistrement et d'alerte dans Mimir, configurer l'Alertmanager multi-tenan...
Écrire de bonnes règles d'alerte Prometheus (et les tester)
Concevoir des alertes utiles : alerter sur les symptômes, choisir for et les seuils, labels de sé...
Alerter sur les logs avec le Ruler de Loki
Mettre en place des alertes et des recording rules LogQL avec le Ruler Loki : configuration, fich...
Générer ses SLO Prometheus avec Sloth
Décrire un SLO en quelques lignes avec Sloth et générer automatiquement règles d'enregistrement m...
Prometheus : alerter avec Alertmanager (règles, routage, silences)
Mettre en place l'alerting Prometheus : règles d'alerte, Alertmanager, routage, regroupement, inh...
PromQL : introduction au langage de requête de Prometheus
Apprendre PromQL, le langage de requête de Prometheus : sélecteurs, rate, sum by, histogrammes et...