1. Les rôles des nœuds #
Qui fait quoi dans le cluster.
Vue d'ensemble #
À savoir : Les requêtes sont écrites au format de la console Dev Tools d'OpenSearch Dashboards (GET _cluster/health). En ligne de commande, la même requête s'écritcurl -sk -u 'admin:Str0ng!Passw0rd-2026' https://localhost:9200/_cluster/health, avec-H 'Content-Type: application/json' -d '…'quand il y a un corps.
Les rôles #
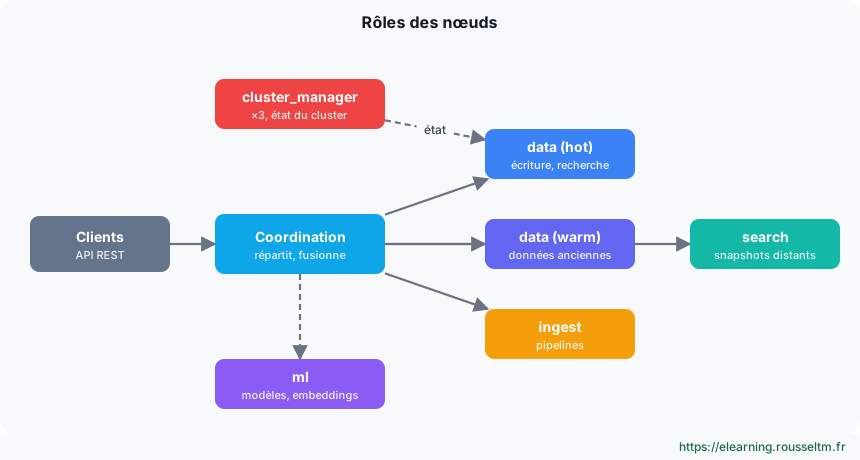
| Rôle | Responsabilité | Ressource critique |
|---|---|---|
| cluster_manager | tient l'état du cluster : index, mappings, emplacement des shards | stabilité, peu de charge |
| data | stocke les shards, exécute écritures et recherches | disque, mémoire, CPU |
| ingest | exécute les pipelines d'ingestion | CPU |
| ml | fait tourner les modèles de ML Commons (embeddings…) | mémoire native, GPU éventuel |
| search | sert les snapshots interrogeables et les répliques de recherche | cache disque |
| remote_cluster_client | interroge d'autres clusters (recherche inter-clusters) | réseau |
coordination seule (node.roles: []) | reçoit les requêtes, répartit, fusionne les résultats | mémoire, CPU |
Sur un petit cluster, chaque nœud cumule tous les rôles. On spécialise quand la charge grandit : d'abord trois nœuds cluster manager dédiés, puis des nœuds de coordination devant les tableaux de bord, puis des nœuds ingest ou ml.
2. Le cluster manager et le quorum #
Pourquoi trois et pas deux.
Élection #
Parmi les nœuds éligibles, un seul est élu cluster manager. Toute décision (créer un index, déplacer un shard) demande l'accord d'une majorité des nœuds éligibles : c'est le quorum.
| Nœuds éligibles | Quorum | Pannes tolérées |
|---|---|---|
| 1 | 1 | 0 |
| 2 | 2 | 0 (pas mieux qu'un seul) |
| 3 | 2 | 1 |
| 5 | 3 | 2 |
Bonne Pratique : Trois nœuds éligibles cluster manager suffisent dans la plupart des cas. Un nombre pair n'apporte rien : 4 nœuds tolèrent une panne, comme 3.
L'état du cluster #
L'état du cluster est diffusé à tous les nœuds à chaque changement. Des milliers d'index, de champs ou de shards le rendent lourd : c'est la première raison de limiter le nombre de shards (par défaut 1 000 par nœud de données, cluster.max_shards_per_node).
GET _cat/cluster_manager?v
GET _cluster/state/metadata?filter_path=metadata.cluster_uuid
GET _cluster/stats?filter_path=indices.count,indices.shards.total
3. Shards et répliques #
Répartition, routage et réplication.
Répartition #
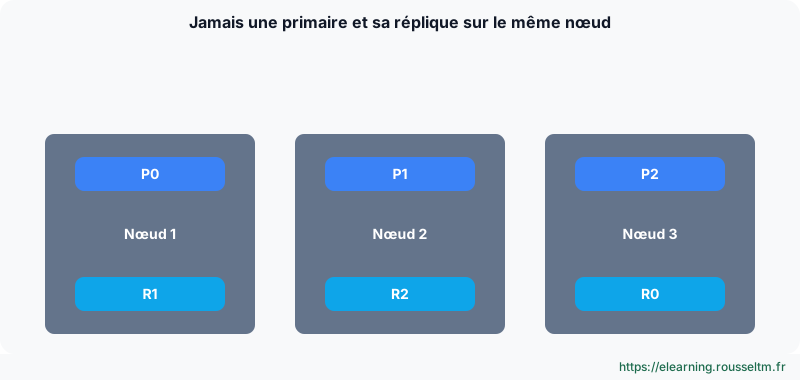
OpenSearch place les shards pour équilibrer le nombre de shards par nœud, sans jamais mettre une primaire et sa réplique sur le même nœud. Si un nœud tombe, une réplique est promue primaire, puis de nouvelles répliques sont recréées ailleurs.
Chemin d'une écriture #
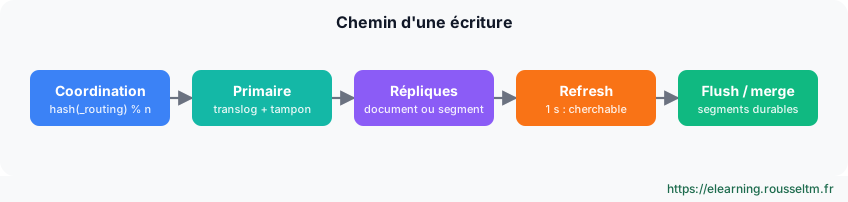
Le shard cible est calculé à partir de l'identifiant (ou du champ _routing) : c'est pourquoi le nombre de primaires est fixé à la création. Le document est écrit dans le translog (durabilité) et un tampon mémoire ; il devient cherchable au prochain refresh (1 s par défaut).
Réplication par document ou par segment #
| Mode | Fonctionnement | Intérêt |
|---|---|---|
| Document (défaut historique) | chaque réplique réindexe le document | répliques à jour immédiatement |
| Segment | la primaire indexe, les répliques copient les segments | jusqu'à 2 fois moins de CPU à l'écriture |
| Stockage distant (remote store) | segments et translog écrits dans un stockage objet | durabilité sans dépendre des répliques |
PUT logs-app-000010
{
  "settings": {
    "index.number_of_shards": 3,
    "index.number_of_replicas": 1,
    "index.replication.type": "SEGMENT"
  }
}
À savoir : En réplication par segment, une réplique peut avoir quelques instants de retard sur la primaire : une lecture juste après l'écriture peut ne pas voir le document.
4. Diagnostiquer l'allocation #
Un cluster jaune ou rouge.
Trouver le shard en cause #
GET _cat/shards?v&h=index,shard,prirep,state,node,unassigned.reason&s=state

GET _cluster/allocation/explain
{"index": "logs-app-000010", "shard": 0, "primary": false}
La réponse explique, nœud par nœud, pourquoi le shard n'est pas placé :
| Raison affichée | Signification | Action |
|---|---|---|
| same_shard | la primaire est déjà sur le seul nœud | ajouter un nœud ou passer à 0 réplique |
| disk_threshold | disque au-delà du seuil haut | libérer de l'espace, ajouter un nœud |
| max_retry | 5 échecs d'allocation | POST _cluster/reroute?retry_failed=true |
| awareness / filter | règle d'allocation (zone, attribut) | vérifier les attributs des nœuds |
Commandes à connaître #
Commandes à connaître
GET _cat/nodes?v&h=name,node.role,cluster_manager: rôles et cluster manager éluGET _cat/shards?v: emplacement des shardsGET _cluster/allocation/explain: pourquoi un shard n'est pas assignéPOST _cluster/reroute?retry_failed=true: relancer les allocations échouéesGET _cat/recovery?v&active_only=true: copies de shards en cours
Sources #
Vérifié en novembre 2026 (OpenSearch 3.x, Data Prepper 2.x) : OpenSearch publie une version mineure environ toutes les six semaines, consultez les notes de version avant de vous appuyer sur un détail.