1. Les familles d'agrégations #
Grouper, calculer, enchaîner.
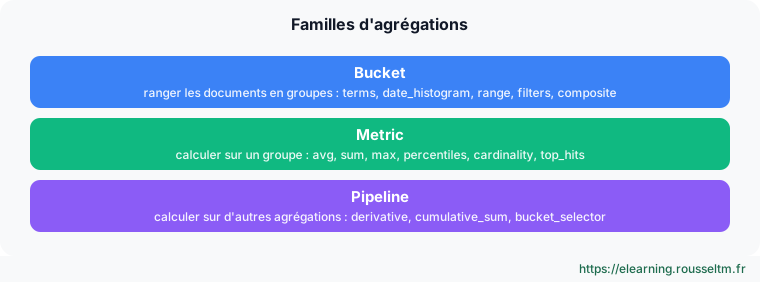
Trois familles #
À savoir : Les requêtes sont écrites au format de la console Dev Tools d'OpenSearch Dashboards (GET _cluster/health). En ligne de commande, la même requête s'écritcurl -sk -u 'admin:Str0ng!Passw0rd-2026' https://localhost:9200/_cluster/health, avec-H 'Content-Type: application/json' -d '…'quand il y a un corps.
Taux d'erreur par service et par heure #
GET logs-app-*/_search
{
  "size": 0,
  "query": {"range": {"@timestamp": {"gte": "now-24h"}}},
  "aggs": {
    "par_heure": {
      "date_histogram": {"field": "@timestamp", "fixed_interval": "1h", "time_zone": "Europe/Paris"},
      "aggs": {
        "par_service": {
          "terms": {"field": "service", "size": 10},
          "aggs": {
            "erreurs": {"filter": {"term": {"level": "ERROR"}}},
            "p95": {"percentiles": {"field": "duree_ms", "percents": [95]}}
          }
        }
      }
    }
  }
}
size: 0 évite de renvoyer les documents : seules les agrégations comptent. fixed_interval prend une durée fixe (1h, 5m) ; calendar_interval suit le calendrier (1M pour un mois réel).
2. Les agrégations à connaître #
Et leurs pièges.
Sélection #
| Agrégation | Usage | Piège |
|---|---|---|
| terms | top N valeurs | comptes approximatifs sur plusieurs shards (doc_count_error_upper_bound) |
| cardinality | nombre de valeurs distinctes (utilisateurs uniques) | approché (HyperLogLog++), précis sous precision_threshold |
| percentiles | p50, p95, p99 de latence | approché (t-digest) |
| composite | parcourir toutes les combinaisons, page par page | pas de tri par compte |
| top_hits | exemples de documents par groupe | coûteux si beaucoup de groupes |
| significant_terms | ce qui est anormalement fréquent dans un sous-ensemble | demande assez de données |
Agrégations pipeline #
GET logs-app-*/_search
{
  "size": 0,
  "aggs": {
    "par_minute": {
      "date_histogram": {"field": "@timestamp", "fixed_interval": "1m"},
      "aggs": {
        "volume": {"value_count": {"field": "@timestamp"}},
        "variation": {"derivative": {"buckets_path": "volume"}},
        "pics": {"bucket_selector": {"buckets_path": {"v": "volume"}, "script": "params.v > 1000"}}
      }
    }
  }
}
derivative calcule la variation d'une minute à l'autre ; bucket_selector ne garde que les minutes au-delà de 1 000 événements.
Tout parcourir avec composite #
GET logs-app-*/_search
{
  "size": 0,
  "aggs": {
    "couples": {
      "composite": {
        "size": 500,
        "sources": [{"service": {"terms": {"field": "service"}}}, {"niveau": {"terms": {"field": "level"}}}]
      }
    }
  }
}
La réponse contient after_key : renvoyez-la dans "after" pour obtenir la page suivante, jusqu'à une réponse vide.
3. Explorer avec PPL #
Le langage à la manière d'un shell.
Principe #
| Commande | Rôle | Exemple |
|---|---|---|
| where | filtrer | where level = 'ERROR' and duree_ms > 1000 |
| fields | choisir les champs | fields @timestamp, service, message |
| stats | agréger | stats avg(duree_ms), count() by service |
| eval | calculer un champ | eval secondes = duree_ms / 1000 |
| sort / head | trier, limiter | sort - duree_ms | head 20 |
| dedup | dédoublonner | dedup utilisateur |
| top / rare | valeurs fréquentes ou rares | top 5 service |
| parse | extraire par expression régulière | parse message 'utilisateur=(? |
| patterns | regrouper les messages similaires | patterns message | stats count() by patterns_field |
Exemples #
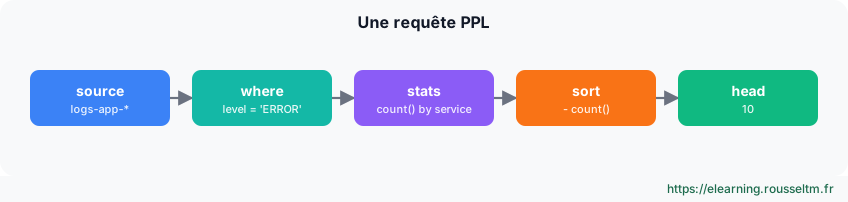
source=logs-app-* | where level = 'ERROR' | stats count() as erreurs by span(@timestamp, 1h), service | sort - erreurs

source=logs-app-* | parse message 'utilisateur=(?<utilisateur>\w+)' | where isnotnull(utilisateur) | top 5 utilisateur

source=web-logs | eval lent = if(duree_ms > 1000, 1, 0) | stats sum(lent) as lentes, count() as total by request | eval taux = lentes * 100 / total | sort - taux | head 10
À savoir : Les versions 3.x enrichissent PPL (nouveau moteur de requêtes, jointures et sous-requêtes selon la version). Vérifiez la liste des commandes de votre version dans la documentation.
4. SQL et Query Workbench #
Pour ceux qui pensent en tables.
SQL #
SELECT service, COUNT(*) AS n, AVG(duree_ms) AS moyenne
FROM logs-app-*
WHERE level = 'ERROR' AND @timestamp > NOW() - INTERVAL 1 DAY
GROUP BY service
ORDER BY n DESC
LIMIT 10
Le Query Workbench de la console exécute SQL et PPL, affiche le plan (_explain) et exporte en CSV ou JSON. Par API : POST _plugins/_sql?format=csv.
| Langage | Points forts |
|---|---|
| DSL | tout est possible, utilisé par les applications |
| PPL | exploration interactive de logs, enchaînement lisible |
| SQL | rapports, outils BI (pilotes JDBC et ODBC) |
Commandes à connaître #
Commandes à connaître
POST _plugins/_ppl: exécuter une requête PPLPOST _plugins/_sql?format=csv: exécuter du SQL, réponse CSVPOST _plugins/_sql/_explain: traduction de la requête en DSL"size": 0, "aggs": {…}: agréger sans renvoyer de documents
Sources #
Vérifié en novembre 2026 (OpenSearch 3.x, Data Prepper 2.x) : OpenSearch publie une version mineure environ toutes les six semaines, consultez les notes de version avant de vous appuyer sur un détail.