1. L'index inversé #
Pourquoi la recherche est rapide.
Principe #
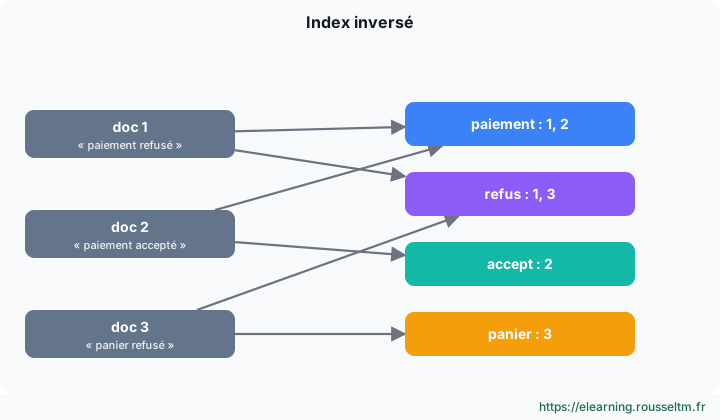
Comme l'index d'un livre, l'index inversé associe chaque terme à la liste des documents qui le contiennent. Chercher « refus » revient à lire une seule entrée, quelle que soit la taille de l'index. Tout dépend donc de la façon dont le texte est découpé en termes : c'est le rôle de l'analyseur.
À savoir : Les requêtes sont écrites au format de la console Dev Tools d'OpenSearch Dashboards (GET _cluster/health). En ligne de commande, la même requête s'écritcurl -sk -u 'admin:Str0ng!Passw0rd-2026' https://localhost:9200/_cluster/health, avec-H 'Content-Type: application/json' -d '…'quand il y a un corps.
2. Les analyseurs #
Du texte aux termes.
Anatomie #
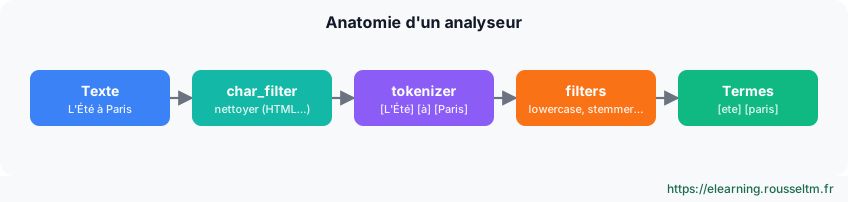
| Étape | Rôle | Exemples |
|---|---|---|
| char_filter | modifier le texte brut | html_strip, mapping, pattern_replace |
| tokenizer | découper en jetons | standard, whitespace, keyword, ngram |
| filter | transformer les jetons | lowercase, asciifolding, elision, stop, stemmer, synonym |
Tester avec _analyze #
POST _analyze
{"analyzer": "standard", "text": "L'Été à Paris"}

POST _analyze
{"analyzer": "french", "text": "L'Été à Paris"}| Analyseur | Termes obtenus |
|---|---|
| standard | l'été, à, paris |
| french | ete, pari |
L'analyseur french retire l'élision (l'), les mots vides (à) et réduit les mots à leur racine : « paiements » et « paiement » donnent le même terme.
Un analyseur sur mesure #
PUT produits-v1
{
  "settings": {
    "analysis": {
      "filter": {
        "fr_elision": {"type": "elision", "articles_case": true, "articles": ["l", "d", "j", "qu", "n", "s", "c", "m", "t"]},
        "fr_stem":    {"type": "stemmer", "language": "light_french"},
        "synonymes":  {"type": "synonym", "synonyms": ["pc, ordinateur", "tv, téléviseur"]}
      },
      "analyzer": {
        "francais_sans_accents": {
          "tokenizer": "standard",
          "filter": ["fr_elision", "lowercase", "asciifolding", "synonymes", "fr_stem"]
        }
      }
    }
  },
  "mappings": {
    "properties": {
      "nom":   {"type": "text", "analyzer": "francais_sans_accents", "fields": {"exact": {"type": "keyword"}}},
      "description": {"type": "text", "analyzer": "francais_sans_accents"},
      "prix":  {"type": "float"},
      "stock": {"type": "integer"}
    }
  }
}
Erreur Courante : L'analyseur d'un champ ne se change pas sur un index existant : il faut réindexer. Testez-le avec _analyze sur des exemples réels avant de créer l'index.3. Les requêtes plein texte #
Choisir la bonne requête.
Panorama #
| Requête | Comportement | Exemple d'usage |
|---|---|---|
| match | analyse le texte, cherche les termes (OU par défaut) | barre de recherche |
| match + operator: and | tous les termes requis | affiner |
| match_phrase | termes dans l'ordre, slop pour la tolérance | « carte bancaire » |
| multi_match | plusieurs champs, pondération ^ | nom et description |
| fuzziness: AUTO | tolère les fautes de frappe | « ordinatuer » |
| term | valeur exacte, sans analyse | champ keyword uniquement |
Une recherche de produits #
GET produits/_search
{
  "query": {
    "bool": {
      "must": [{
        "multi_match": {
          "query": "ordinatuer portable",
          "fields": ["nom^3", "description"],
          "fuzziness": "AUTO"
        }
      }],
      "filter": [
        {"range": {"prix": {"lte": 1200}}},
        {"range": {"stock": {"gt": 0}}}
      ]
    }
  },
  "highlight": {"fields": {"description": {}}},
  "_source": ["nom", "prix"]
}
nom^3 donne trois fois plus de poids au nom qu'à la description. Les filtres de prix et de stock ne comptent pas dans le score et sont mis en cache.
Erreur Courante : Une requêtetermsur un champtextne trouve rien : la valeur cherchée n'est pas analysée alors que le contenu l'a été. Utilisezmatch, ou le sous-champkeyword.
4. La pertinence #
Comprendre et régler le score.
BM25 #
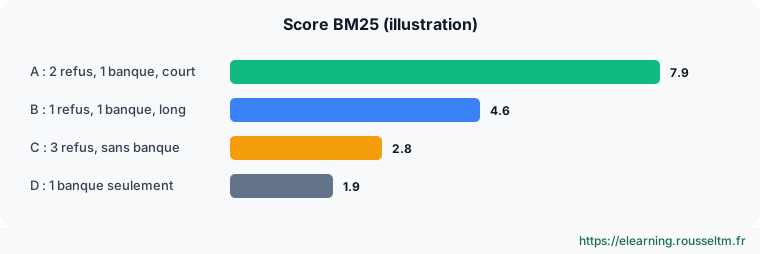
- Fréquence du terme : plus un terme apparaît dans le document, plus le score monte, avec un effet de saturation (paramètre
k1, 1,2 par défaut). - Rareté : un terme rare dans l'index pèse plus qu'un terme fréquent.
- Longueur : un champ court où le terme apparaît pèse plus qu'un long texte (paramètre
b, 0,75).
Expliquer et ajuster #
GET produits/_search
{"explain": true, "query": {"match": {"nom": "portable"}}}

GET produits/_search
{
  "query": {
    "function_score": {
      "query": {"match": {"nom": "portable"}},
      "functions": [{"field_value_factor": {"field": "stock", "modifier": "log1p", "factor": 0.5}}],
      "boost_mode": "sum"
    }
  }
}
explain détaille le calcul du score de chaque document. function_score ajoute un critère métier (stock, popularité, fraîcheur) au score textuel.
5. Paginer sans limite #
from/size, search_after et point in time.
Les méthodes #
| Méthode | Limite | Usage |
|---|---|---|
| from + size | 10 000 résultats (index.max_result_window) | pages d'un site |
| search_after + PIT | aucune, vue figée des données | exports, pagination profonde |
| scroll | ancienne méthode, coûteuse | à remplacer par PIT |
POST produits/_search/point_in_time?keep_alive=2m

GET _search
{
  "size": 100,
  "pit": {"id": "<pit_id>", "keep_alive": "2m"},
  "sort": [{"prix": "asc"}, {"_id": "asc"}],
  "search_after": [499.0, "sku-1234"]
}
Commandes à connaître #
Commandes à connaître
POST _analyze: voir les termes produits par un analyseurGET <index>/_search {"explain": true}: détail du scorePOST <index>/_search/point_in_time?keep_alive=2m: figer une vue pour paginerGET <index>/_termvectors/<id>: termes indexés d'un documentPOST <index>/_validate/query?explain: valider et réécrire une requête
Sources #
Vérifié en novembre 2026 (OpenSearch 3.x, Data Prepper 2.x) : OpenSearch publie une version mineure environ toutes les six semaines, consultez les notes de version avant de vous appuyer sur un détail.