1. Où placer un pipeline #
Trois emplacements.
Les trois places #
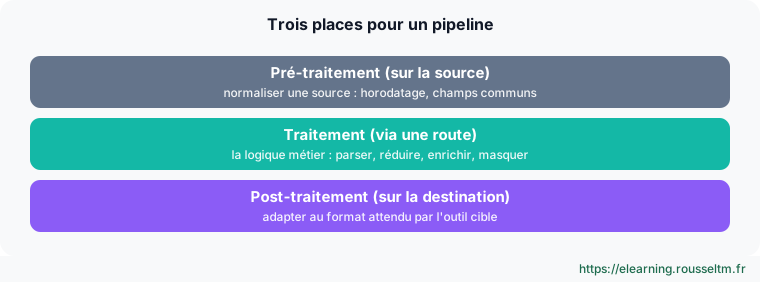
Un pipeline est une liste ordonnée de fonctions. Chaque fonction a un filtre (elle ne s'applique qu'aux événements qui y répondent) et peut être marquée Final pour arrêter le traitement des événements concernés. Les fonctions se regroupent pour la lisibilité et se désactivent sans être supprimées.
2. Le catalogue des fonctions #
Les plus utilisées.
Par usage #
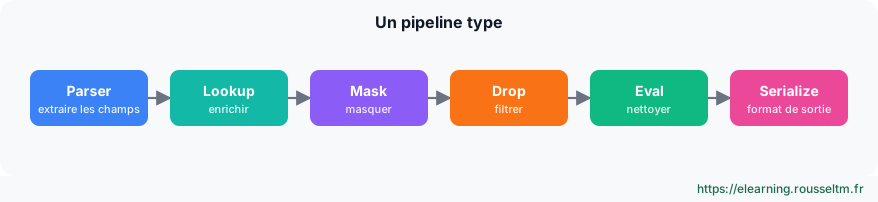
| Usage | Fonctions |
|---|---|
| Extraire | Parser (JSON, CSV, clé=valeur, délimité, Grok), Regex Extract, Auto Timestamp, XML / JSON Unroll |
| Modifier | Eval, Rename, Flatten, Numerify, Serialize, Code |
| Enrichir | Lookup, GeoIP, DNS Lookup, Redis |
| Protéger | Mask (expressions régulières, hachage), Drop de champs sensibles |
| Réduire | Drop, Regex Filter, Sampling, Dynamic Sampling, Suppress, Aggregations, Rollup Metrics |
| Métriques | Publish Metrics, Prometheus Publisher, Aggregations |
| Organiser | Chain (appeler un autre pipeline), Comment, groupes |
À savoir : La fonction Tee est dépréciée depuis la version 4.18 : utilisez des routes non finales ou l'Output Router pour dupliquer un flux.
3. Les expressions Cribl #
Du JavaScript partout.
Exemples #
Filtres, valeurs calculées et noms de fichiers s'écrivent en JavaScript, enrichi d'un objet C de fonctions utilitaires :
| Expression | Résultat |
|---|---|
status >= 500 | vrai pour les erreurs serveur |
uri.split('?')[0] | l'URL sans paramètres |
C.Mask.md5(user) | haché MD5 d'un identifiant (pseudonymisation) |
C.Time.strftime(_time, '%Y-%m-%d') | date formatée |
C.Lookup('assets.csv', 'ip').match(src_ip, 'owner') | propriétaire de l'adresse dans une table |
C.Net.cidrMatch('192.168.0.0/16', dst_ip) | appartenance à un réseau |
`${host}:${port}` | chaîne composée (gabarit) |
Attention : Les valeurs de champs dans Eval sont des expressions : une chaîne s'écrit entre apostrophes ('prod'), sinon Cribl cherche un champ nomméprod.
4. Un pipeline complet #
Logs d'accès Apache.
Configuration #
# local/cribl/pipelines/apache_access/conf.yml (extrait)
functions:
  - id: regex_extract
    filter: "true"
    conf:
      source: _raw
      regex: '/^(?<client>\S+) \S+ \S+ \[[^\]]+\] "(?<method>\S+) (?<uri>\S+) [^"]*" (?<status>\d{3}) (?<bytes>\d+|-)/'
  - id: lookup
    conf:
      file: http_status.csv
      inFields: [{ eventField: status, lookupField: status }]
      outFields: [{ lookupField: category, eventField: status_category }]
  - id: mask
    conf:
      fields: [_raw]
      rules: [{ matchRegex: '/(email=)[^&\s]+/g', replaceExpr: "`${g1}${C.Mask.md5(g0)}`" }]
  - id: eval
    conf:
      add: [{ name: env, value: "'prod'" }]
remove: [bytes]- Regex Extract crée les champs
client,method,uri,status,bytes. - Lookup ajoute
status_categorydepuis une table CSV (Processing › Knowledge › Lookups). - Mask remplace les adresses e-mail des paramètres par un haché.
- Eval ajoute
envet retire un champ inutile.
On construit un pipeline dans l'interface, pas en YAML : l'extrait montre seulement ce qui est enregistré dans local/.
L'aperçu #
- Chargez un fichier d'échantillon dans le panneau de droite : IN montre l'événement entrant, OUT le résultat, avec les champs ajoutés en vert et retirés en rouge.
- L'icône de statistiques indique le nombre d'événements et d'octets avant et après : la réduction se mesure dès la conception.
- Full preview exécute aussi la route et le pipeline de post-traitement pour voir l'événement tel qu'il partira.
Bonne Pratique : Pour la performance : filtrez tôt (Drop en tête), préférez Parser à de longues expressions régulières, ancrez vos regex, et réservez la fonction Code aux cas sans équivalent.
Commandes à connaître #
Commandes à connaître
C.Mask.md5(user): pseudonymiser un champC.Lookup('assets.csv','ip').match(src_ip,'owner'): enrichir depuis une tableC.Time.strftime(_time, '%Y-%m-%d'): formater une date/(?<status>\d{3})/: groupe nommé de Regex Extract
Sources #
Vérifié en novembre 2026 (Cribl 4.20) : Cribl publie une version mineure environ tous les deux mois, consultez les notes de version avant de vous appuyer sur un détail.
Mon suivi
Connectez-vous pour suivre votre progression et prendre des notes. Se connecter
💬 Questions sur cette leçon
Aucune question pour l'instant : soyez le premier à demander de l'aide ou à partager votre configuration.
Articles recommandés
Bonnes pratiques Cribl Stream et Edge
Les bonnes pratiques pour exploiter Cribl en production : conception des routes et pipelines, nom...
Cribl : le pipeline de données pour l'observabilité et la sécurité
Découvrir Cribl : pourquoi un pipeline de données de télémétrie, la suite Cribl (Stream, Edge, La...
Sources, destinations et routes dans Cribl Stream
Recevoir et envoyer des données avec Cribl Stream : sources push, pull, collecteurs et internes, ...
Ingestion Elasticsearch : Bulk API, ingest pipelines, enrich et reindex
Ingérer et transformer des données dans Elasticsearch : Bulk API, ingest pipelines et processeurs...
Bindplane : gérer ses pipelines de télémétrie OpenTelemetry
Comprendre Bindplane : plan de contrôle des collecteurs OpenTelemetry via OpAMP, BDOT Collector, ...
Logs dans Datadog : collecte, pipelines, index et maîtrise du volume
Collecter les logs avec l'agent, les structurer avec pipelines et processeurs (grok), utiliser fa...
Transformer avec VRL et tester ses pipelines Vector
Le langage VRL (Vector Remap Language) : analyse de logs (JSON, regex, syslog), gestion des erreu...
Réduire, transformer et optimiser les volumes avec Cribl
Réduire le volume envoyé aux SIEM et outils d'observabilité sans perdre d'information utile : Dro...
Archiver, rejouer et rechercher : S3, Replay, Cribl Lake et Cribl Search
Garder toutes les données à bas coût et les retrouver à la demande : destination S3 partitionnée,...