1. L'application Problems #
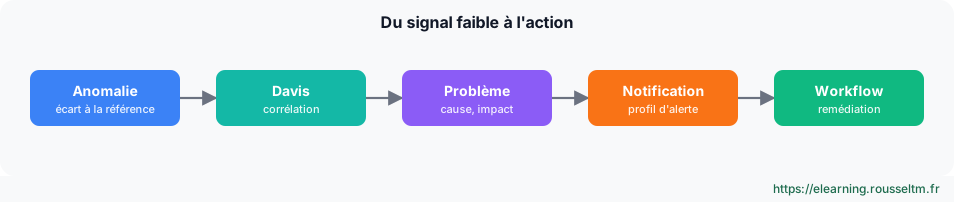
Un problème, pas mille alertes.
Principe #
| Catégorie | Exemple |
|---|---|
| Disponibilité | Processus arrêté, hôte injoignable |
| Erreur | Hausse du taux d'échec d'un service |
| Lenteur | Dégradation du temps de réponse |
| Ressource | Saturation CPU, mémoire, disque |
| Personnalisée | Alerte définie par l'utilisateur (seuil, événement) |
2. Lire une page problème #
Les informations clés.
Contenu #
- Impact : utilisateurs, applications et services touchés.
- Cause racine : l'entité et l'événement identifiés par Davis, avec les éléments de preuve (métriques, changements, déploiements).
- Chronologie des événements liés.
- Visual resolution path : propagation du problème dans la topologie.
- Commentaires et intégrations (ticket créé, notification envoyée).
Bonne Pratique : Avant de chercher plus loin, regardez les événements de déploiement et de configuration dans la chronologie : une grande partie des incidents suit un changement.
3. Notifications et automatisation #
Prévenir et agir.
Profils d'alerte et intégrations #
Un profil d'alerte filtre les problèmes (sévérité, zone de gestion ou segment, tags, durée minimale) ; une notification l'associe à un canal : e-mail, Slack, Microsoft Teams, webhook, PagerDuty, ServiceNow, Jira...
Workflows et auto-remédiation #
Les workflows (AutomationEngine) se déclenchent sur un problème, un événement ou un horaire et enchaînent des actions : requête DQL, appel HTTP, création de ticket, exécution d'un runbook (Ansible, script), message.
Déclencheur : Davis problem (catégorie Ressource, tag service:checkout)
Tâche 1 : requête DQL - récupérer les logs d'erreur des 10 dernières minutes
Tâche 2 : HTTP request - appeler le job « redémarrer le pod » de l'outil d'automatisation
Tâche 3 : Slack - publier le résumé et le lien vers le problème
Erreur Courante : Limitez l'auto-remédiation à des actions sûres et réversibles (redémarrage, purge de cache, montée en charge) et journalisez chaque exécution.
Application mobile #
L'application mobile Dynatrace (iOS, Android) envoie les notifications push des problèmes et permet de consulter impact et cause racine depuis un téléphone, pratique pour l'astreinte.
