1. Standalone ou multi-instances ? #
Ce qui rend une instance unique fragile.
L'instance unique #
Disponible dans : ✓ OSS ✓ Enterprise ✕ Cloud Grafana Cloud est déjà hautement disponible
Par défaut, Grafana stocke tout (utilisateurs, dashboards, alertes, sessions) dans une base SQLite locale. Simple, mais la machine devient un point unique de défaillance, et SQLite ne se partage pas entre plusieurs serveurs.
L'architecture cible #
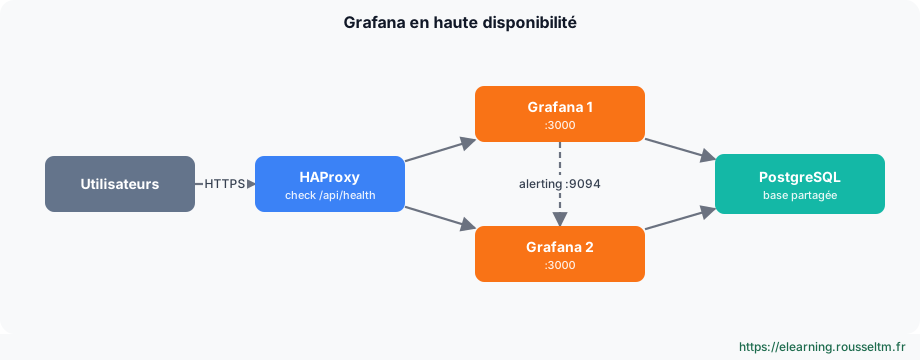
- Plusieurs instances Grafana sans état local, identiques et interchangeables.
- Une base PostgreSQL (ou MySQL) partagée, elle-même sauvegardée et idéalement répliquée.
- Un répartiteur de charge (HAProxy, Nginx, load balancer cloud) qui vérifie
/api/health. - L'alerting en cluster, pour que les notifications ne soient envoyées qu'une fois.
2. Configurer les instances #
Une configuration commune.
grafana.ini #
# grafana.ini : identique sur toutes les instances (sauf l'adresse annoncée pour l'alerting)
[database]
type = postgres
host = db.exemple.fr:5432
name = grafana
user = grafana
password = $__file{/run/secrets/db_password}
ssl_mode = require

[security]
secret_key = $__file{/run/secrets/grafana_secret_key}   # la même clé partout

[unified_alerting]
enabled = true
ha_listen_address = 0.0.0.0:9094
ha_advertise_address = 10.0.0.21:9094                   # adresse de cette instance
ha_peers = 10.0.0.21:9094,10.0.0.22:9094
Sessions et connexions #
Les sessions des utilisateurs sont des jetons enregistrés dans la base de données : n'importe quelle instance reconnaît un utilisateur connecté, l'affinité de session (sticky sessions) n'est donc pas nécessaire. Un cache distant ([remote_cache] avec Redis) peut décharger la base sur les grosses installations.
Alerting en cluster #
Toutes les instances évaluent les règles, mais leurs gestionnaires d'alertes échangent par le protocole de cluster (port 9094) pour dédupliquer les notifications. Sans ha_peers, chaque instance enverrait sa propre notification.
Plugins #
Chaque instance doit avoir exactement les mêmes plugins, dans les mêmes versions : installez-les par l'image (Docker), par GF_PLUGINS_PREINSTALL ou par le provisioning, jamais à la main sur un seul serveur. Le service de rendu d'images (grafana-image-renderer) se déploie à part et sert toutes les instances.
3. Répartiteur de charge et reverse proxy #
HAProxy devant les instances.
HAProxy #
frontend fe_grafana
    bind :443 ssl crt /etc/haproxy/certs/grafana.pem
    mode http
    default_backend be_grafana

backend be_grafana
    mode http
    balance roundrobin
    option httpchk GET /api/health
    http-check expect status 200
    server grafana1 10.0.0.21:3000 check
server grafana2 10.0.0.22:3000 check/api/healthrenvoie 503 si l'instance ne joint plus la base : HAProxy la retire automatiquement.- Déclarez l'URL publique dans
[server] root_urlsur chaque instance, sinon les liens et redirections OAuth pointent vers l'adresse interne. - Gardez les connexions WebSocket (Grafana Live) : HAProxy les gère en mode HTTP sans réglage particulier.
4. Docker, Kubernetes et sauvegardes #
Déployer et protéger.
Kubernetes #
# values.yaml du chart Helm grafana (extrait)
replicas: 2
persistence:
  enabled: false                     # pas de volume local : tout est dans PostgreSQL
envFromSecret: grafana-secrets       # GF_DATABASE_PASSWORD, GF_SECURITY_SECRET_KEY…
grafana.ini:
  database: { type: postgres, host: postgres:5432, name: grafana, user: grafana }
  unified_alerting: { ha_peers: "grafana-headless:9094" }
podDisruptionBudget: { minAvailable: 1 }
Sur Kubernetes, le Grafana Operator permet aussi de déclarer dashboards, dossiers et sources de données sous forme de ressources personnalisées.
Sauvegarde et reprise #
- Sauvegardez PostgreSQL (dump quotidien et journaux de transactions), la
secret_key,grafana.iniet le provisioning. - Les dashboards versionnés dans Git (Git Sync, Terraform) se redéploient sans la base : c'est la meilleure assurance contre une perte de données.
- Mettez à jour les instances une par une (HAProxy retire celle qui redémarre) ; les migrations de schéma s'exécutent au démarrage de la première instance mise à jour.
Commandes à connaître #
Commandes à connaître
curl -s http://grafana1:3000/api/health: état d'une instance et de sa baseecho "show servers state be_grafana" | socat stdio /var/run/haproxy.sock: état des instances vu par HAProxypsql -h db -U grafana -c "select count(*) from dashboard": vérifier la base partagéekubectl rollout status deploy/grafana: suivre une mise à jour progressive[unified_alerting] ha_peers: pairs du cluster d'alerting
