1. Pourquoi des vecteurs ? #
Chercher le sens, pas les mots.
Principe #
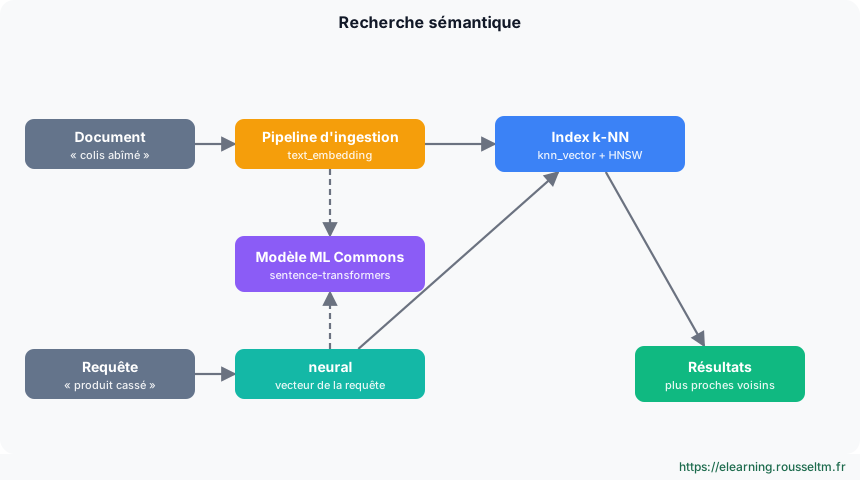
Une recherche lexicale (BM25) ne trouve pas « produit cassé » dans un document qui parle de « colis abîmé ». Un modèle d'embedding transforme un texte en vecteur de quelques centaines de nombres, de sorte que des textes de sens proche donnent des vecteurs proches. Chercher revient alors à trouver les plus proches voisins (k-NN) du vecteur de la requête.
À savoir : Les requêtes sont écrites au format de la console Dev Tools d'OpenSearch Dashboards (GET _cluster/health). En ligne de commande, la même requête s'écritcurl -sk -u 'admin:Str0ng!Passw0rd-2026' https://localhost:9200/_cluster/health, avec-H 'Content-Type: application/json' -d '…'quand il y a un corps.
2. Le plugin k-NN #
Stocker et chercher des vecteurs.
Un index vectoriel #
PUT avis
{
  "settings": {"index.knn": true},
  "mappings": {
    "properties": {
      "texte": {"type": "text"},
      "note":  {"type": "integer"},
      "vecteur": {
        "type": "knn_vector",
        "dimension": 3,
        "space_type": "cosinesimil",
        "method": {"name": "hnsw", "engine": "faiss", "parameters": {"m": 16, "ef_construction": 128}}
      }
    }
  }
}

POST avis/_doc
{"texte": "colis abîmé à la livraison", "note": 1, "vecteur": [0.9, 0.1, 0.0]}

GET avis/_search
{
  "size": 3,
  "query": {
    "knn": {
      "vecteur": {
        "vector": [0.85, 0.15, 0.05],
        "k": 3,
        "filter": {"range": {"note": {"lte": 2}}}
      }
    }
  }
}
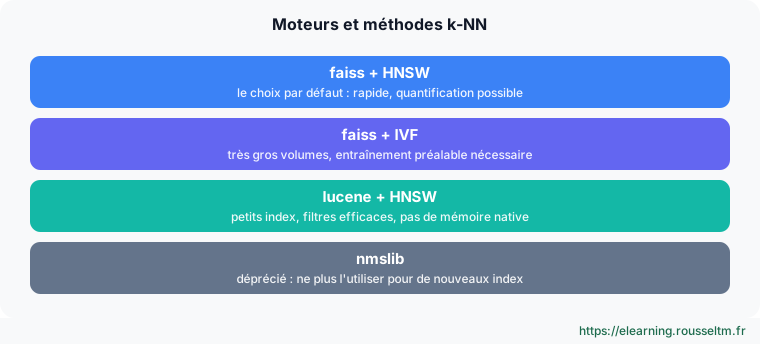
La dimension doit correspondre exactement au modèle (384 pour all-MiniLM-L6-v2, 768 pour beaucoup de modèles BERT). Les 3 dimensions de l'exemple servent seulement à comprendre la mécanique.
Moteurs et méthodes #
| Paramètre | Effet |
|---|---|
| m | liens par nœud du graphe HNSW : plus = meilleur rappel, plus de mémoire |
| ef_construction | qualité du graphe à la construction : plus = indexation plus lente |
| ef_search | effort à la recherche : plus = meilleur rappel, plus lent |
| space_type | l2 (distance euclidienne), cosinesimil, innerproduct : celui du modèle |
| quantification | compresser les vecteurs (fp16, octets, binaire) pour diviser la mémoire |
Attention : Les graphes HNSW de faiss vivent en mémoire native, hors du tas de la JVM. Prévoyez environ 1,1 × (4 × dimension + 8 × m) octets par vecteur : 10 millions de vecteurs de 768 dimensions demandent déjà plus de 35 Go.
3. Recherche sémantique avec ML Commons #
Le cluster calcule les embeddings.
Déployer un modèle #
PUT _cluster/settings
{"persistent": {"plugins.ml_commons.only_run_on_ml_node": false, "plugins.ml_commons.native_memory_threshold": 99}}

POST _plugins/_ml/models/_register?deploy=true
{
  "name": "huggingface/sentence-transformers/all-MiniLM-L6-v2",
  "version": "1.0.2",
  "model_format": "TORCH_SCRIPT"
}

GET _plugins/_ml/tasks/<task_id>
À savoir : La liste des modèles préentraînés et leurs versions exactes figure dans la documentation ML Commons : vérifiez-la, car les versions disponibles évoluent. En production, faites tourner les modèles sur des nœuds ml dédiés, ou appelez un modèle externe (Bedrock, OpenAI, Cohere…) via un connecteur.Ingestion et requête neural #
PUT _ingest/pipeline/embedding
{"processors": [{"text_embedding": {"model_id": "<model_id>", "field_map": {"texte": "vecteur"}}}]}

PUT avis-semantique
{
  "settings": {"index.knn": true, "default_pipeline": "embedding"},
  "mappings": {"properties": {
    "texte": {"type": "text"},
    "vecteur": {"type": "knn_vector", "dimension": 384, "space_type": "cosinesimil", "method": {"name": "hnsw", "engine": "faiss"}}
  }}
}

GET avis-semantique/_search
{"query": {"neural": {"vecteur": {"query_text": "produit cassé", "model_id": "<model_id>", "k": 5}}}}
Le pipeline par défaut calcule le vecteur à chaque indexation ; la requête neural calcule celui du texte cherché avec le même modèle.
4. Recherche hybride #
Le meilleur des deux mondes.
Principe #
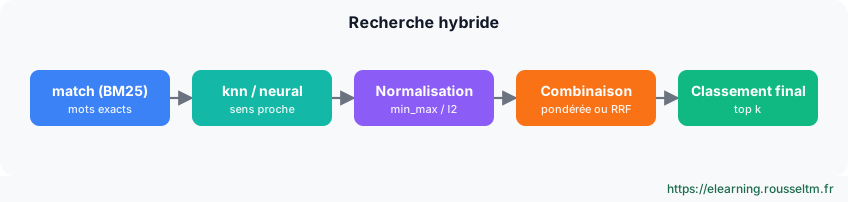
Le lexical excelle sur les mots exacts (références, noms propres), le vectoriel sur le sens. Leurs scores n'ont pas la même échelle : un pipeline de recherche les normalise, puis les combine.
PUT _search/pipeline/hybride
{
  "phase_results_processors": [{
    "normalization-processor": {
      "normalization": {"technique": "min_max"},
      "combination": {"technique": "arithmetic_mean", "parameters": {"weights": [0.4, 0.6]}}
    }
  }]
}

GET avis-semantique/_search?search_pipeline=hybride
{
  "query": {
    "hybrid": {
      "queries": [
        {"match": {"texte": "produit cassé"}},
        {"neural": {"vecteur": {"query_text": "produit cassé", "model_id": "<model_id>", "k": 20}}}
      ]
    }
  }
}
Les poids donnent 40 % au lexical et 60 % au vectoriel. Le processeur score-ranker-processor propose aussi la fusion par rang (RRF), qui ne dépend pas de l'échelle des scores.
RAG et agents #
Pour le RAG (génération augmentée par la recherche), OpenSearch retrouve les passages pertinents par recherche hybride, puis un processeur de réponse ou un agent ML Commons les transmet à un LLM via un connecteur. Le Flow Framework automatise la création de toute la chaîne (modèle, pipelines, index) en un seul modèle de flux.
Bonne Pratique : Mesurez avant de choisir : constituez 50 requêtes réelles avec les bons résultats attendus, puis comparez lexical, vectoriel et hybride. L'hybride gagne souvent, mais pas toujours.
Commandes à connaître #
Commandes à connaître
GET _plugins/_knn/stats: statistiques et mémoire du plugin k-NNPOST _plugins/_ml/models/_register?deploy=true: enregistrer et déployer un modèleGET _plugins/_ml/models/<id>: état d'un modèlePUT _search/pipeline/<nom>: pipeline de recherche (normalisation)GET <index>/_search?search_pipeline=<nom>: recherche avec un pipeline
Sources #
Vérifié en novembre 2026 (OpenSearch 3.x, Data Prepper 2.x) : OpenSearch publie une version mineure environ toutes les six semaines, consultez les notes de version avant de vous appuyer sur un détail.