1. Comprendre les transformations #
Ce qu'elles manipulent, où et dans quel ordre.
Le principe #
Disponible dans : ✓ OSS ✓ Enterprise ✓ Cloud
Une transformation modifie le résultat des requêtes avant son affichage, sans toucher à la source de données. Chaque requête renvoie un ou plusieurs data frames : des tables avec des champs (colonnes), un type par champ (temps, nombre, texte, booléen) et éventuellement des labels. Les transformations s'enchaînent : chacune reçoit la sortie de la précédente.
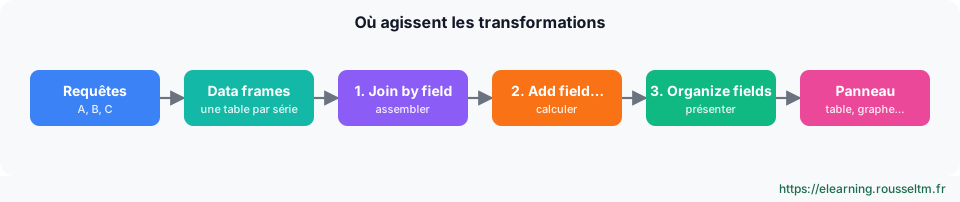
Où sont-elles calculées ? #
Les transformations s'exécutent dans le navigateur, après la réception des données. Conséquences : elles ne réduisent pas la charge de la source, elles ralentissent l'affichage si les données sont volumineuses, et elles ne s'appliquent pas aux règles d'alerte. Pour une alerte, faites le calcul dans la requête ou avec une expression.
Ajouter, ordonner, limiter à une requête #
- Dans l'éditeur du panneau, onglet Transformations › Add transformation : une recherche filtre la liste par nom et par catégorie (combiner, calculer, réordonner, filtrer…).
- L'ordre compte : un renommage placé avant une jointure change le nom du champ de jointure. Réordonnez par glisser-déposer.
- Chaque transformation peut être limitée à certaines requêtes (option de filtre par requête dans ses réglages) : pratique pour ne nettoyer que la requête B.
- L'icône en forme d'œil désactive temporairement une transformation, la corbeille la supprime.
Voir ce qui se passe #
- Table view (bascule en haut de l'éditeur) : affiche les données brutes sous forme de tableau, quel que soit le type de panneau.
- Debug (icône d'insecte sur une transformation) : montre côte à côte l'entrée et la sortie de cette transformation.
- Inspect › Data : l'option « Apply panel transformations » télécharge le CSV avec ou sans transformations.
Bonne Pratique : Ouvrez le mode Debug à chaque nouvelle transformation : 90 % des surprises viennent d'un champ qui ne porte pas le nom ou le type attendu.
2. Organiser et nettoyer les champs #
Renommer, masquer, réordonner, typer, formater.
Organize fields by name #
La transformation la plus utilisée : renommer un champ technique, le masquer (l'œil) ou réordonner les colonnes par glisser-déposer. Un champ masqué reste disponible pour les transformations suivantes s'il est placé avant elles.
| Avant | Après |
|---|---|
Value #A, __name__, job, instance | Instance, Requêtes/s (job et __name__ masqués) |
Rename fields by regex #
Renomme plusieurs champs à la fois avec une expression régulière et des groupes de capture. Exemple : .*instance="([^"]+)".* remplacé par $1 transforme {instance="web-1:9100", job="node"} en web-1:9100.
À savoir : Pour une série Prometheus, le plus simple reste souvent l'option Legend de la requête ({{instance}}) : le nom est fixé à la source.Filter fields by name #
Garde ou retire des champs par case à cocher ou par expression régulière (^(Time|instance|Value.*)$). Plus rapide qu'Organize fields quand la requête renvoie beaucoup de labels.
Convert field type #
Change le type d'un champ : texte vers nombre (un CSV ou une API JSON renvoie souvent des nombres sous forme de texte), texte vers temps avec un format (YYYY-MM-DD HH:mm:ss), nombre vers booléen, ou vers Enum. Sans le bon type, un calcul ou un graphique temporel échoue.
Format string, Format time #
- Format string : majuscules, minuscules, casse de titre, suppression des espaces, sous-chaîne, pour harmoniser des valeurs textuelles.
- Format time : affiche un champ temps dans un format choisi (
DD/MM/YYYY) et un fuseau, par exemple pour un tableau d'événements.
3. Filtrer, trier et limiter les lignes #
Ne garder que ce qui compte.
Filter data by values #
Garde ou retire les lignes qui respectent des conditions sur un ou plusieurs champs : supérieur, inférieur, égal, entre, expression régulière, vide. Les conditions se combinent par « toutes » ou « au moins une ».
| Condition | Résultat |
|---|---|
Status correspond à 5.. (regex) | seules les lignes en erreur serveur restent |
Utilisation > 80 et env = prod | les machines de production saturées |
Filter data by query refId #
Ne garde que les résultats de certaines requêtes (A, C…) : utile quand une requête sert uniquement à un calcul ou à une jointure et ne doit pas s'afficher.
Sort by, Limit #
Sort by trie sur un champ, croissant ou décroissant ; Limit garde les N premières lignes. Ensemble, ils font un « top N » : trier par latence décroissante puis limiter à 5.
Bonne Pratique : Quand c'est possible, faites le top N dans la requête (topk(5, …)en PromQL,ORDER BY … LIMIT 5en SQL) : la source renvoie moins de données.
4. Calculer #
Créer des valeurs et résumer des séries.
Add field from calculation #
Ajoute un champ calculé. Le mode détermine le calcul :
| Mode | Calcul | Exemple |
|---|---|---|
| Binary operation | deux champs ou un champ et une constante : + − × ÷ % | Used / Total, puis × 100 |
| Reduce row | agrège plusieurs champs d'une même ligne : somme, moyenne, max… | total des requêtes de trois services |
| Unary operation | fonction sur un champ : valeur absolue, exponentielle, logarithme, arrondi | abs(Écart) |
| Cumulative functions | total ou moyenne cumulés depuis la première ligne | nombre de déploiements cumulé sur le mois |
| Window functions | moyenne, écart type ou variance sur une fenêtre glissante | moyenne mobile sur 5 points pour lisser une courbe |
| Row index | numéro de ligne | classement dans un top N |
Donnez un alias au champ créé et cochez « Replace all fields » si seul le résultat doit rester.
Reduce #
Résume chaque série en une ou plusieurs statistiques (dernière valeur non nulle, moyenne, max, min, total, nombre…). Deux modes :
- Series to rows : une ligne par série, une colonne par statistique. Idéal pour un tableau récapitulatif (une ligne par serveur avec Moyenne, Max, Dernière).
- Reduce fields : garde la structure mais réduit chaque champ à une valeur ; option « Labels to fields » pour garder les labels en colonnes.
| Avant (3 séries temporelles) | Après Reduce › Series to rows (Mean, Max) |
|---|---|
| web-1, web-2, web-3 : CPU % toutes les 15 s | web-1 | 34 | 81 web-2 | 28 | 66 web-3 | 52 | 97 |
Regression analysis #
Calcule une droite (ou un polynôme) de tendance à partir d'une série et la prolonge : utile pour estimer quand un disque sera plein. À manier avec prudence : une tendance linéaire ignore les cycles et les purges.
5. Combiner plusieurs requêtes #
Joindre, fusionner, concaténer.
Join by field #
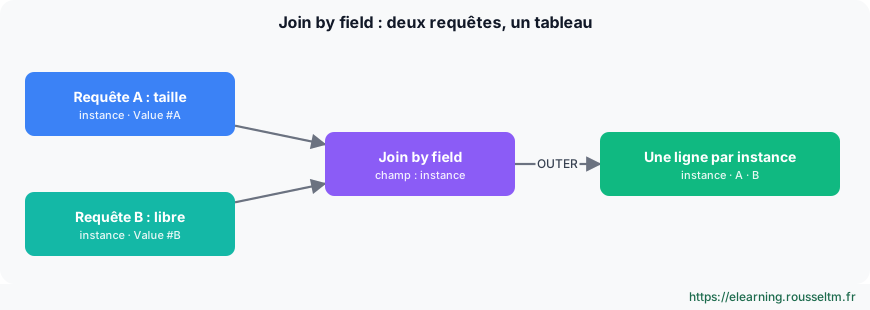
Joint les data frames sur un champ commun (le temps par défaut, ou un champ comme instance). Modes :
| Mode | Garde |
|---|---|
| OUTER (time series) | toutes les valeurs de temps des deux côtés ; cases vides si une série n'a pas de point |
| OUTER (tabular) | toutes les lignes, pour des tables non temporelles |
| INNER | seulement les valeurs présentes des deux côtés |
| LEFT | toutes les lignes de la première requête, complétées par la seconde |
Attention : Les deux champs de jointure doivent avoir exactement le même nom et le même type. Renommez avant la jointure, et pour Prometheus utilisez des requêtes instantanées au format Table.
Join by labels #
Assemble des séries qui partagent des labels (par exemple instance et job) en une table où chaque série devient une colonne : pratique pour mettre côte à côte plusieurs métriques d'une même cible.
Merge series/tables #
Fusionne des résultats de même structure en un seul tableau, en alignant les champs de même nom : par exemple trois requêtes SQL sur trois bases régionales, ou plusieurs index Elasticsearch.
Concatenate fields, Series to rows #
- Concatenate fields : met tous les champs de toutes les requêtes côte à côte, sans clé de jointure (les lignes sont alignées par position).
- Series to rows : empile plusieurs séries temporelles en une seule table longue (Time, Metric, Value), pour un tableau d'événements ou un export.
6. Remodeler les données #
Passer des labels aux colonnes, des lignes aux champs, d'un format à l'autre.
Labels to fields #
Transforme les labels d'une série en colonnes (mode Columns) ou en lignes (mode Rows). C'est la clé des tableaux d'inventaire à partir de métriques d'information comme node_uname_info ou kube_pod_info.
| Avant | Après Labels to fields |
|---|---|
node_uname_info{instance="web-1", release="6.8.0", nodename="web-1"} = 1 | colonnes instance | release | nodename | Value |
Partition by values #
L'inverse d'une fusion : découpe une table en plusieurs séries selon les valeurs d'un champ. Une requête SQL qui renvoie time, region, ventes devient une courbe par région, sans écrire une requête par région.
Rows to fields, Grouping to matrix, Transpose #
- Rows to fields : chaque ligne devient un champ (le nom vient d'une colonne, la valeur d'une autre) ; idéal pour afficher des paires clé/valeur dans un panneau Stat.
- Grouping to matrix : tableau croisé, un champ en lignes, un autre en colonnes, une valeur dans les cases (heure × jour, service × environnement).
- Transpose : échange lignes et colonnes d'une table.
Prepare time series, Time series to table #
- Prepare time series : convertit des données entre les formats multi-frame, wide (une colonne de temps, plusieurs colonnes de valeurs) et long (temps, label, valeur), pour qu'un panneau de série temporelle les accepte.
- Time series to table : place une mini-courbe (sparkline) de chaque série dans une cellule de tableau.
Extract fields, Config from query results #
- Extract fields : extrait des champs d'une colonne JSON, clé=valeur ou délimitée (logs Loki, réponses d'API), avec des chemins JSON choisis.
- Config from query results : utilise le résultat d'une requête comme réglage (seuil, min, max, unité) des autres : le seuil d'alerte vient d'une table de référence plutôt que d'être saisi à la main.
7. Grouper et agréger #
L'équivalent du GROUP BY.
Group by #
Regroupe les lignes par un ou plusieurs champs (Group by) et agrège les autres (Calculate : somme, moyenne, nombre, dernière valeur…).
| Avant : une ligne par conteneur | Après Group by host, Count |
|---|---|
| host | conteneur | mémoire web-1 | api | 512 web-1 | nginx | 64 web-2 | api | 498 | host | conteneurs | mémoire (somme) web-1 | 2 | 576 web-2 | 1 | 498 |
Group to nested tables, Histogram #
- Group to nested tables : une ligne par groupe, dépliable pour voir le détail des lignes du groupe dans un tableau imbriqué.
- Histogram : calcule la répartition des valeurs en intervalles (buckets), par exemple la distribution des temps de réponse sur la période.
8. Recettes complètes #
Des chaînes de transformations prêtes à reproduire.
Taux d'occupation des disques par serveur #
Deux requêtes Prometheus instantanées, format Table :
A: node_filesystem_size_bytes{fstype!~"tmpfs|overlay", mountpoint="/"}
B: node_filesystem_avail_bytes{fstype!~"tmpfs|overlay", mountpoint="/"}- Join by field sur
instance(mode OUTER tabular). - Add field from calculation, Binary operation :
Value #B / Value #A, aliasLibre; puis une seconde :1 - Libreen Unary/Binary, aliasOccupation, unité Percent (0.0-1.0). - Organize fields by name : garder
instanceetOccupation, renommer. - Sort by
Occupationdécroissant ; seuils à 80 % et 90 % dans le panneau.
À savoir : Même résultat directement en PromQL : 1 - node_filesystem_avail_bytes / node_filesystem_size_bytes. La recette reste utile quand les deux valeurs viennent de sources différentes.Inventaire des serveurs #
node_uname_info- Requête instantanée au format Table.
- Labels to fields (si la source renvoie des séries) puis Filter fields by name :
instance,nodename,release,machine. - Organize fields by name pour renommer (Serveur, Noyau, Architecture) et Sort by Serveur.
Top 5 des routes les plus lentes #
histogram_quantile(0.95, sum by (le, route) (rate(http_request_duration_seconds_bucket[5m])))- Requête instantanée, format Table ; Organize fields by name :
routeet la valeur renomméep95. - Sort by
p95décroissant, puis Limit à 5. - Add field from calculation, Row index, alias
Rang.
9. Bonnes pratiques, alternatives et exercice #
Quand transformer, quand ne pas le faire.
Requête, transformation ou expression SQL ? #
| Besoin | Meilleur endroit |
|---|---|
| agréger, filtrer, calculer sur une seule source | la requête (PromQL, LogQL, SQL) |
| combiner des sources différentes, calcul aussi utilisé par une alerte | expressions SQL (Grafana 12+, côté serveur) |
| mettre en forme : renommer, masquer, typer, trier un résultat déjà petit | transformations |
-- Expression SQL (Grafana 12+) : A et B sont les requêtes du panneau
SELECT A.service, A.value AS requetes, B.value AS erreurs,
       ROUND(100.0 * B.value / A.value, 2) AS taux_erreur
FROM A JOIN B ON A.service = B.service
ORDER BY taux_erreur DESC
Bonnes pratiques #
- Réduisez les données à la source : une transformation sur 50 000 lignes fige le navigateur.
- Nommez les champs calculés (alias) : les transformations suivantes et les overrides s'y réfèrent par leur nom.
- Gardez des chaînes courtes et lisibles ; au-delà de six ou sept transformations, la requête ou une expression SQL est souvent plus claire.
- Les transformations font partie du JSON du panneau : elles sont versionnées avec Git Sync ou le provisioning, et conservées par le schéma de dashboard v2 de Grafana 13.
Aide-mémoire #
| Je veux… | Transformation |
|---|---|
| renommer, masquer, réordonner | Organize fields by name |
| renommer beaucoup de séries | Rename fields by regex |
| changer un type (texte → nombre ou temps) | Convert field type |
| filtrer des lignes | Filter data by values |
| un top N | Sort by + Limit |
| un calcul entre colonnes | Add field from calculation |
| une valeur par série | Reduce |
| assembler deux requêtes | Join by field |
| fusionner des résultats identiques | Merge series/tables |
| labels en colonnes | Labels to fields |
| une série par valeur d'un champ | Partition by values |
| compter ou sommer par groupe | Group by |
| un tableau croisé | Grouping to matrix |
| lire du JSON dans une colonne | Extract fields |
À vous de jouer #
- Avec la source TestData (scénario « Random walk », 3 séries), construisez un tableau d'une ligne par série avec Moyenne, Max et Dernière (Reduce › Series to rows).
- Ajoutez un champ
Écart= Max − Moyenne et triez par écart décroissant. - Ne gardez que les séries dont la moyenne dépasse 0 (Filter data by values) et renommez les colonnes.
- Ouvrez le mode Debug sur chaque étape et notez ce qui change entre l'entrée et la sortie.
