1. Les moniteurs #
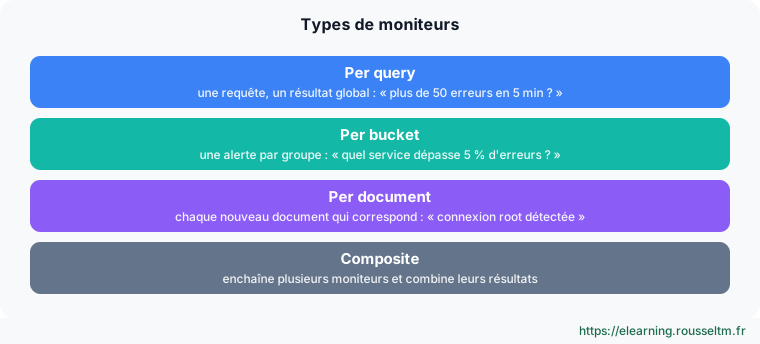
Quatre façons de surveiller.
Types #
À savoir : Les requêtes sont écrites au format de la console Dev Tools d'OpenSearch Dashboards (GET _cluster/health). En ligne de commande, la même requête s'écritcurl -sk -u 'admin:Str0ng!Passw0rd-2026' https://localhost:9200/_cluster/health, avec-H 'Content-Type: application/json' -d '…'quand il y a un corps.
La chaîne d'alerte #
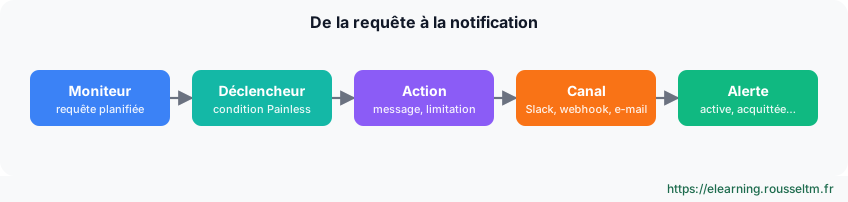
| État de l'alerte | Signification |
|---|---|
| Active | la condition est vraie, les actions s'exécutent |
| Acknowledged | quelqu'un s'en occupe : plus de notifications |
| Completed | la condition est redevenue fausse |
| Error | la requête du moniteur a échoué |
2. Notifications #
Un canal, plusieurs moniteurs.
Créer un canal #
POST _plugins/_notifications/configs
{
  "config_id": "slack-sre",
  "config": {
    "name": "Slack SRE",
    "description": "Canal #alertes-sre",
    "config_type": "slack",
    "is_enabled": true,
    "slack": {"url": "https://hooks.slack.com/services/…"}
  }
}

POST _plugins/_notifications/feature/test/slack-sre| Type | Usage |
|---|---|
| slack, chime, microsoft_teams | messagerie d'équipe |
| webhook | tout outil HTTP : PagerDuty, Opsgenie, ticketing |
| smtp_account + email | e-mail via un serveur SMTP |
| sns | Amazon SNS |
3. Un moniteur par groupe #
Une alerte par service en difficulté.
Bucket-level monitor #
POST _plugins/_alerting/monitors
{
  "type": "monitor",
  "monitor_type": "bucket_level_monitor",
  "name": "taux_erreur_par_service",
  "enabled": true,
  "schedule": {"period": {"interval": 5, "unit": "MINUTES"}},
  "inputs": [{
    "search": {
      "indices": ["logs-app-*"],
      "query": {
        "size": 0,
        "query": {"range": {"@timestamp": {"gte": "{{period_end}}||-5m", "lte": "{{period_end}}", "format": "epoch_millis"}}},
        "aggregations": {
          "composite_agg": {
            "composite": {"sources": [{"service": {"terms": {"field": "service"}}}]},
            "aggs": {"erreurs": {"filter": {"term": {"level": "ERROR"}}}}
          }
        }
      }
    }
  }],
  "triggers": [{
    "bucket_level_trigger": {
      "name": "plus_de_5_pourcent",
      "severity": "2",
      "condition": {
        "buckets_path": {"total": "_count", "erreurs": "erreurs._count"},
        "parent_bucket_path": "composite_agg",
        "script": {"source": "params.total > 20 && params.erreurs / params.total > 0.05", "lang": "painless"}
      },
      "actions": [{
        "name": "slack",
        "destination_id": "slack-sre",
        "message_template": {"source": "Taux d'erreur élevé : {{#ctx.newAlerts}}{{bucket_keys}} {{/ctx.newAlerts}}"},
        "action_execution_policy": {"action_execution_scope": {"per_alert": {"actionable_alerts": ["NEW", "DEDUPED"]}}},
        "throttle_enabled": true,
        "throttle": {"value": 30, "unit": "MINUTES"}
      }]
    }
  }]
}
Le seuil params.total > 20 évite d'alerter sur 1 erreur pour 2 requêtes la nuit. La limitation (throttle) n'envoie qu'un message par alerte toutes les 30 minutes.
Bonne Pratique : Testez un moniteur avant de l'activer : POST _plugins/_alerting/monitors/<id>/_execute?dryrun=true exécute la requête et le déclencheur sans notifier.Moniteur par document #
Le doc_level_monitor évalue chaque nouveau document avec des requêtes simples (champ:valeur) : idéal pour la sécurité (« connexion root », « IP sur liste noire »), car aucune occurrence n'est noyée dans un comptage.
4. Détection d'anomalies #
Quand on ne connaît pas le bon seuil.
Principe #
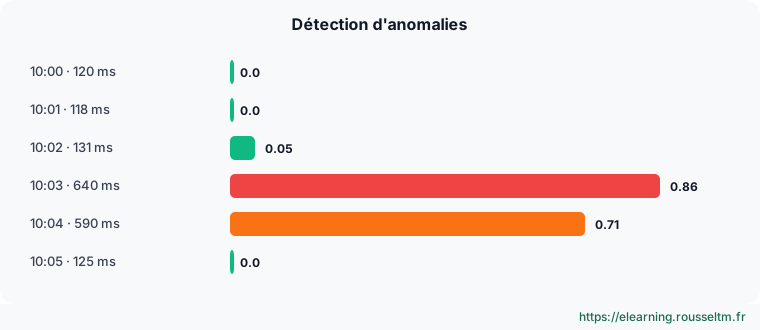
Le plugin Anomaly Detection apprend le comportement normal d'une ou plusieurs mesures avec l'algorithme Random Cut Forest, en continu. Chaque intervalle reçoit une note (anomaly grade, de 0 à 1) et une confiance. Il faut quelques dizaines d'intervalles d'historique avant les premiers résultats.
Créer un détecteur #
POST _plugins/_anomaly_detection/detectors
{
  "name": "latence_paiement",
  "description": "Latence moyenne du service paiement",
  "time_field": "@timestamp",
  "indices": ["logs-app-*"],
  "filter_query": {"term": {"service": "paiement"}},
  "feature_attributes": [{
    "feature_name": "latence_moyenne",
    "feature_enabled": true,
    "aggregation_query": {"latence_moyenne": {"avg": {"field": "duree_ms"}}}
  }],
  "detection_interval": {"period": {"interval": 1, "unit": "Minutes"}},
  "window_delay": {"period": {"interval": 1, "unit": "Minutes"}}
}

POST _plugins/_anomaly_detection/detectors/<detector_id>/_start
Ajoutez category_field (par exemple ["service"]) pour un modèle par service : un seul détecteur surveille alors chaque entité séparément. Un moniteur d'alerte peut ensuite se brancher sur les résultats du détecteur.
Security Analytics #
Security Analytics applique des règles de détection au format Sigma (plus de 2 000 règles fournies) à des journaux de sécurité typés : Windows, réseau, DNS, CloudTrail, etc. Les correspondances produisent des constats, corrélés entre sources, et peuvent déclencher des alertes.
Commandes à connaître #
Commandes à connaître
POST _plugins/_alerting/monitors/<id>/_execute?dryrun=true: tester un moniteurGET _plugins/_alerting/monitors/alerts: alertes en coursPOST _plugins/_notifications/feature/test/<config_id>: tester un canalPOST _plugins/_anomaly_detection/detectors/<id>/_start: démarrer un détecteurPOST _plugins/_anomaly_detection/detectors/results/_search: résultats d'anomalies
Sources #
Vérifié en novembre 2026 (OpenSearch 3.x, Data Prepper 2.x) : OpenSearch publie une version mineure environ toutes les six semaines, consultez les notes de version avant de vous appuyer sur un détail.