1. Dimensionner #
Shards, mémoire et disque.
Taille des shards #
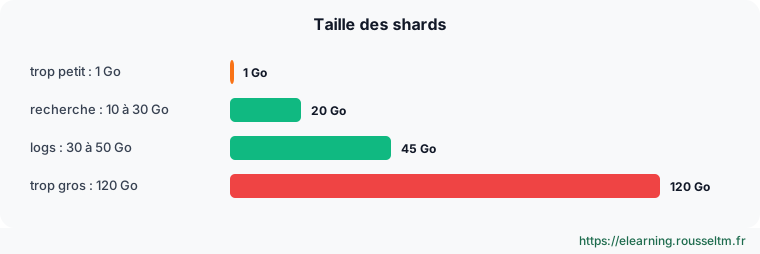
Visez des shards de 10 à 50 Go. Un exemple : 200 Go de logs par jour, 30 jours de rétention, 1 réplique, soit 200 × 30 × 2 = 12 To sur disque. Avec des shards de 40 Go, l'index quotidien prend 5 primaires (200 / 40) et le cluster porte 300 shards au total, raisonnable pour 6 nœuds de données de 2 To utiles chacun (en gardant 25 % de marge).
À savoir : Les requêtes sont écrites au format de la console Dev Tools d'OpenSearch Dashboards (GET _cluster/health). En ligne de commande, la même requête s'écritcurl -sk -u 'admin:Str0ng!Passw0rd-2026' https://localhost:9200/_cluster/health, avec-H 'Content-Type: application/json' -d '…'quand il y a un corps.
Repères #
| Ressource | Repère |
|---|---|
| Tas de la JVM | 50 % de la RAM, 32 Go au plus ; le reste pour le cache du système |
| Shards par nœud | au plus 25 par Go de tas (soit 775 pour 31 Go), limite par défaut 1 000 |
| Disque | SSD pour les données chaudes ; rester sous 75 % d'occupation |
| CPU | l'indexation et les agrégations en consomment le plus |
2. Indexer vite #
Bulk, refresh et translog.
Les leviers #
| Levier | Réglage | Effet |
|---|---|---|
| Bulk | lots de 5 à 15 Mo, plusieurs clients en parallèle | moins d'allers-retours |
| Refresh | index.refresh_interval: 30s | moins de petits segments ; données visibles plus tard |
| Chargement initial | refresh_interval: -1 et 0 réplique, puis rétablir | 2 à 3 fois plus rapide |
| Translog | index.translog.durability: async | plus rapide, risque de perdre quelques secondes |
| Compression | index.codec: zstd_no_dict | disque réduit, un peu plus de CPU |
| Identifiants | laisser OpenSearch les générer | évite une vérification d'existence |
PUT logs-import/_settings
{"index": {"refresh_interval": "-1", "number_of_replicas": 0}}

# … chargement en bulk …

PUT logs-import/_settings
{"index": {"refresh_interval": "30s", "number_of_replicas": 1}}
POST logs-import/_forcemerge?max_num_segments=1
Erreur Courante : Surveillez les rejets d'écriture : GET _cat/thread_pool/write?v&h=node_name,active,queue,rejected. Des rejets qui montent signifient que le cluster n'absorbe plus : ralentissez les clients ou ajoutez des nœuds, n'augmentez pas la file.3. Chaud, tiède et snapshots interrogeables #
Payer moins pour les données anciennes.
Architecture par niveaux #
Donnez un attribut aux nœuds (node.attr.temp: hot ou warm), puis laissez ISM déplacer les index vieillissants vers les nœuds tièdes, sur disques moins chers :
{"name": "tiede",
 "actions": [
   {"allocation": {"require": {"temp": "warm"}, "wait_for": true}},
   {"replica_count": {"number_of_replicas": 1}},
   {"force_merge": {"max_num_segments": 1}}
 ],
 "transitions": [{"state_name": "archive", "conditions": {"min_index_age": "30d"}}]}
Snapshots interrogeables #
Un index restauré avec "storage_type": "remote_snapshot" reste dans le stockage objet : les nœuds de rôle search ne téléchargent que les morceaux utiles, avec un cache local. Les requêtes sont plus lentes, mais le stockage coûte celui d'un bucket S3.
POST _snapshot/sauvegardes/logs-2026.09/_restore
{
  "indices": "logs-2026.09.*",
  "storage_type": "remote_snapshot",
  "rename_pattern": "(.+)",
  "rename_replacement": "archive-$1"
}
4. Protéger le cluster #
Disque et mémoire.
Seuils de disque #
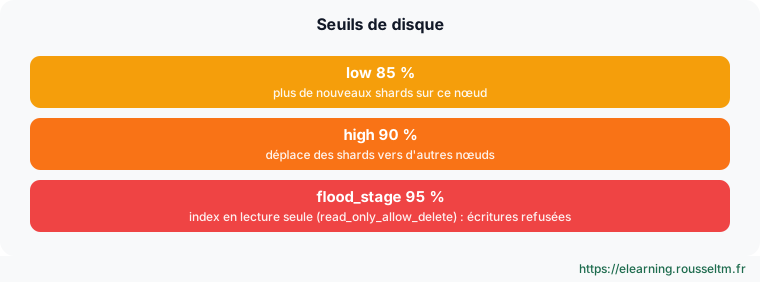
Au seuil flood_stage, les index du nœud passent en lecture seule. Une fois l'espace libéré, OpenSearch lève le blocage automatiquement ; sur d'anciennes versions il fallait le faire à la main :
PUT logs-*/_settings
{"index.blocks.read_only_allow_delete": null}
Coupe-circuits #
Les coupe-circuits refusent une requête plutôt que de laisser la JVM manquer de mémoire : une agrégation terms de taille 100 000 sur un champ à forte cardinalité déclenche une erreur circuit_breaking_exception. C'est une protection, pas une panne : réduisez la requête (composite, filtres, période plus courte).
GET _nodes/stats/breaker?filter_path=nodes.*.breakers.parent5. Diagnostiquer #
Une méthode, des outils.
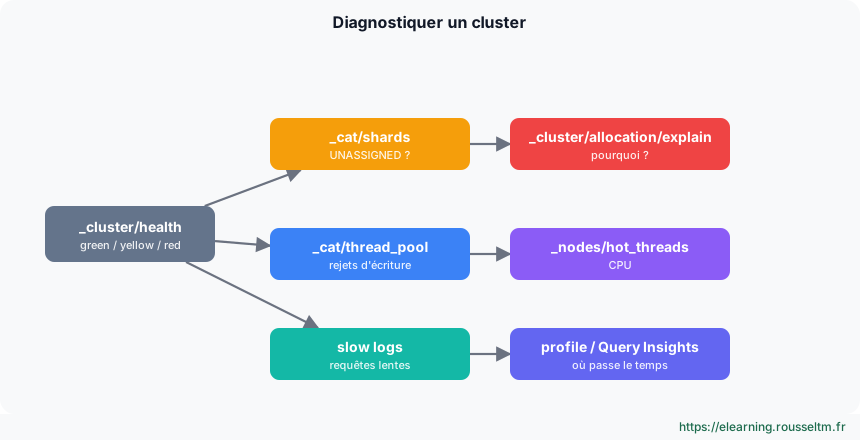
La méthode #
Requêtes lentes #
PUT logs-app-*/_settings
{
  "index.search.slowlog.threshold.query.warn": "2s",
  "index.search.slowlog.threshold.query.info": "500ms",
  "index.indexing.slowlog.threshold.index.warn": "1s"
}

GET logs-app-*/_search
{"profile": true, "query": {"wildcard": {"message": "*timeout*"}}}
profile détaille le temps passé par chaque partie de la requête et par shard. Ici, un wildcard qui commence par * doit parcourir tous les termes : préférez un champ analysé et match.
Commandes à connaître #
Commandes à connaître
GET _cat/allocation?v: disque par nœudGET _cat/thread_pool/write,search?v&h=node_name,name,active,queue,rejected: files et rejetsGET _nodes/hot_threads: ce qui occupe le CPUGET _cat/segments/<index>?v: segments d'un indexGET _nodes/stats/jvm,breaker: mémoire et coupe-circuitsGET _cat/indices?v&s=store.size:desc: index les plus gros
Sources #
Vérifié en novembre 2026 (OpenSearch 3.x, Data Prepper 2.x) : OpenSearch publie une version mineure environ toutes les six semaines, consultez les notes de version avant de vous appuyer sur un détail.