1. Rappels : SLI, SLO et budget d'erreur #
Le vocabulaire commun aux deux méthodes.
Les notions #
| Terme | Définition | Exemple |
|---|---|---|
| SLI | indicateur mesuré de la qualité de service | proportion de paiements acceptés en moins de 2 s |
| SLO | objectif fixé sur ce SLI, sur une fenêtre | 99,9 % sur 30 jours glissants |
| SLA | engagement contractuel, assorti de pénalités | 99,5 % par mois, sinon avoir |
| Budget d'erreur | ce que l'on s'autorise à rater : 100 % − SLO | 0,1 % des minutes ou des requêtes |
| Burn rate | vitesse de consommation du budget (1 = le budget dure exactement la fenêtre) | 14,4 : budget de 30 jours épuisé en 2 jours |
Tout repose sur une question simple : qu'est-ce qu'on compte ? Soit des tranches de temps (« combien de minutes le service a-t-il été bon ? »), soit des événements (« combien de requêtes ont été bien servies ? »). C'est toute la différence entre les deux familles de SLO.
À savoir : Pour les bases, voir SLI, SLO et SLA expliqués simplement et Le budget d'erreur.
2. Le SLO basé sur le temps #
Time slices, ou la logique de l'uptime.
Principe #
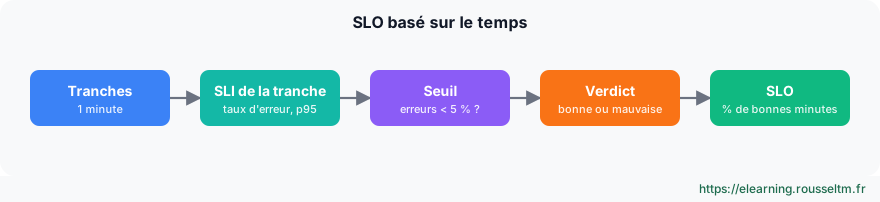
On découpe la fenêtre en tranches (souvent une minute). Pour chaque tranche, on calcule un SLI (taux d'erreur, latence p95, réponse d'une sonde) et on la déclare bonne ou mauvaise selon un seuil. Le SLO porte sur la proportion de bonnes tranches. C'est la logique historique de l'« uptime » et de la plupart des SLA contractuels.
SLI = bonnes minutes / minutes de la fenêtre
minute bonne  ⇔  taux d'erreur de la minute < 5 %  ET  p95 de la minute < 500 ms

30 jours = 43 200 minutes ; SLO 99,9 %  ⇒  budget = 43,2 minutes mauvaises
Le tableau des « neuf » #
| SLO | Budget sur 30 jours | Budget sur 90 jours | Budget sur 1 an |
|---|---|---|---|
| 99 % | 7 h 12 min | 21 h 36 min | 3 j 15 h 36 min |
| 99,5 % | 3 h 36 min | 10 h 48 min | 1 j 19 h 48 min |
| 99,9 % | 43 min 12 s | 2 h 9 min 36 s | 8 h 45 min 36 s |
| 99,95 % | 21 min 36 s | 1 h 4 min 48 s | 4 h 22 min 48 s |
| 99,99 % | 4 min 19 s | 12 min 58 s | 52 min 34 s |
Forces et faiblesses #
| Forces | Faiblesses |
|---|---|
| intuitif : « le service a été en panne 12 minutes » | seuil binaire arbitraire : 4,9 % d'erreurs = minute parfaite, 5,1 % = minute perdue |
| fonctionne avec peu ou pas de trafic (sondes synthétiques) | ignore les dégradations partielles sous le seuil, même longues |
| aligné sur les SLA contractuels exprimés en minutes | une minute de nuit pèse autant qu'une minute de pointe |
| robuste face aux pics de trafic d'un seul client | sensible à la taille des tranches et à la fréquence des sondes |
3. Le SLO basé sur les événements #
Request-based, ou la logique de l'expérience utilisateur.
Principe #
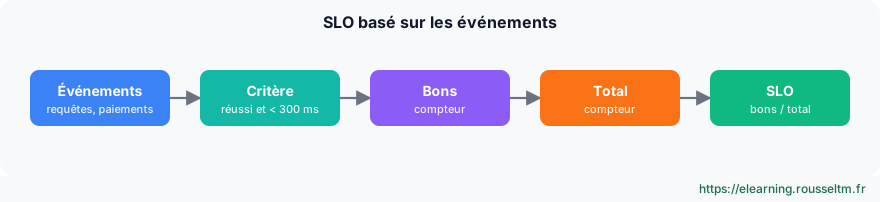
On compte des événements (requêtes HTTP, paiements, connexions, messages traités) et on classe chacun en bon ou mauvais selon un critère : réussi, et éventuellement assez rapide. Le SLI est le rapport bons / total sur la fenêtre. Le budget d'erreur s'exprime en nombre d'événements ratés.
SLI = événements bons / événements totaux
bon  ⇔  statut ≠ 5xx  ET  durée < 300 ms

30 millions de requêtes par mois ; SLO 99,9 %  ⇒  budget = 30 000 requêtes ratées
Forces et faiblesses #
| Forces | Faiblesses |
|---|---|
| proportionnel au nombre d'utilisateurs touchés : une panne en pointe coûte plus qu'une panne la nuit | faible trafic = bruit : 1 erreur sur 20 requêtes fait chuter le SLI à 95 % |
| capte les dégradations partielles : 2 % d'erreurs pendant des heures consomment réellement le budget | les requêtes jamais arrivées ne sont pas comptées si l'on mesure côté serveur |
| pas de seuil arbitraire par tranche | une panne la nuit pèse peu, même si elle bloque des clients critiques |
| burn rate naturel et alertes multi-fenêtres précises | sensible aux tentatives répétées (retries) et à la définition d'un événement |
À savoir : Google SRE recommande par défaut les SLI à base d'événements (« proportion de bons événements ») pour les services à trafic suffisant, et réserve les tranches de temps aux cas où le trafic est faible ou irrégulier.
4. Le même mois, mesuré des deux façons #
Trois incidents qui racontent deux histoires.
Hypothèses #
- API de paiement, environ 30 millions de requêtes par mois : 100 requêtes par minute la nuit, 1 000 en journée, 3 000 en pointe.
- SLO de 99,9 % sur 30 jours : budget de 43,2 minutes (temps) ou de 30 000 requêtes (événements).
- Côté temps, une minute est mauvaise si plus de 5 % des requêtes échouent.
Résultats #
| Incident | Temps : minutes perdues | Temps : budget | Événements : requêtes ratées | Événements : budget |
|---|---|---|---|---|
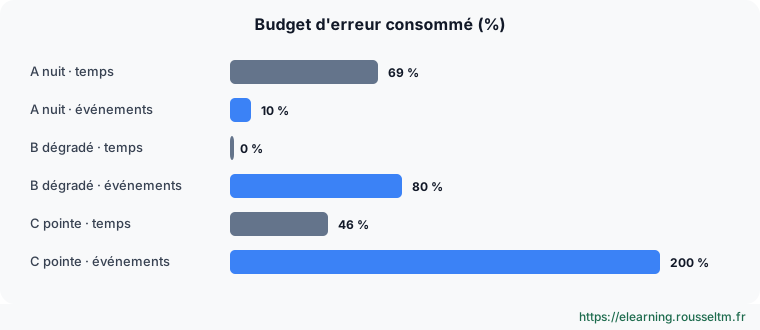
| A. Panne totale de 30 min à 3 h du matin | 30 | 69 % | 3 000 | 10 % |
| B. 4 % d'erreurs pendant 10 h en journée | 0 | 0 % | 24 000 | 80 % |
| C. Panne totale de 20 min à l'heure de pointe | 20 | 46 % | 60 000 | 200 % |
Ce que cela montre #
- Incident A : le SLO temps s'alarme (69 % du budget) pour une panne qui a touché très peu de clients ; le SLO événements la relativise (10 %).
- Incident B : invisible pour le SLO temps (toujours sous le seuil de 5 %), alors que 24 000 paiements ont échoué. Le SLO événements en fait l'incident majeur du mois.
- Incident C : le SLO temps le juge moins grave que A ; le SLO événements montre qu'il a, à lui seul, épuisé deux fois le budget.
Bonne Pratique : Aucune des deux mesures n'est « fausse » : elles répondent à des questions différentes. Le temps répond à « combien de temps le service était-il utilisable ? », les événements à « quelle part des utilisateurs a été bien servie ? ».
5. Mettre en œuvre #
Prometheus, OpenSLO, SQL et outils du marché.
Avec Prometheus #
# Événements : SLI = requêtes bonnes / requêtes totales (règles d'enregistrement)
groups:
  - name: slo-paiement
    rules:
      - record: sli:paiement:ratio_rate5m
        expr: |
          sum(rate(http_requests_total{service="paiement", code!~"5.."}[5m]))
          /
          sum(rate(http_requests_total{service="paiement"}[5m]))
      # Burn rate sur 1 h et 5 min : alerte page si le budget de 30 jours brûle 14,4 fois trop vite
      - alert: PaiementBudgetBrule
        expr: |
          (1 - sli:paiement:ratio_rate1h) > (14.4 * 0.001)
          and
          (1 - sli:paiement:ratio_rate5m) > (14.4 * 0.001)
        labels: { severity: page }

# Temps : part des minutes « bonnes » sur 30 jours (sous-requête, résolution 1 min)
avg_over_time(
  (
    (sum(rate(http_requests_total{service="paiement", code=~"5.."}[1m]))
      / sum(rate(http_requests_total{service="paiement"}[1m]))) < bool 0.05
  )[30d:1m]
)
Côté événements, il suffit de deux compteurs. Côté temps, la sous-requête [30d:1m] évalue chaque minute puis fait la moyenne des verdicts (1 ou 0) : coûteuse sur 30 jours, elle se calcule plutôt avec une règle d'enregistrement par minute.
Pour générer règles et alertes automatiquement, voir Sloth et Pyrra.
Avec OpenSLO #
# OpenSLO v1 : la même cible, deux méthodes de budget
apiVersion: openslo/v1
kind: SLO
metadata: { name: paiement-evenements }
spec:
  service: paiement
  budgetingMethod: Occurrences          # basé sur les événements
  objectives:
    - target: 0.999
  timeWindow: [{ duration: 30d, isRolling: true }]
  indicator:
    metadata: { name: paiement-succes }
    spec:
      ratioMetric:
        good:  { metricSource: { type: Prometheus, spec: { query: 'sum(rate(http_requests_total{service="paiement",code!~"5.."}[1m]))' } } }
        total: { metricSource: { type: Prometheus, spec: { query: 'sum(rate(http_requests_total{service="paiement"}[1m]))' } } }
---
# Variante temps : chaque minute est bonne si son ratio dépasse 95 %
#   budgetingMethod: Timeslices
#   objectives: [{ target: 0.999, timeSliceTarget: 0.95, timeSliceWindow: 1m }]
La spécification OpenSLO nomme explicitement les deux méthodes : Occurrences (événements) et Timeslices (temps), avec un seuil par tranche (timeSliceTarget).
En SQL sur les traces #
-- Événements à partir des traces (ClickHouse, table otel_traces) : SLI par jour
SELECT toDate(Timestamp) AS jour,
       countIf(StatusCode != 'Error' AND Duration < 300e6) / count() AS sli
FROM otel_traces
WHERE ServiceName = 'paiement' AND SpanKind = 'Server' AND Timestamp > now() - INTERVAL 30 DAY
GROUP BY jour ORDER BY jour;

-- Temps : part des minutes où le taux d'erreur reste sous 5 %
SELECT avg(taux < 0.05) AS sli_temps FROM (
  SELECT toStartOfMinute(Timestamp) AS m, countIf(StatusCode = 'Error') / count() AS taux
  FROM otel_traces
  WHERE ServiceName = 'paiement' AND SpanKind = 'Server' AND Timestamp > now() - INTERVAL 30 DAY
  GROUP BY m);
Dans les outils #
| Outil | Événements | Temps |
|---|---|---|
| Grafana SLO | ratio de deux requêtes | via une requête de tranches |
| Datadog | SLO « metric-based » | SLO « monitor-based » et « time slice » |
| Dynatrace | SLO sur ratio de métriques ou de requêtes DQL | SLO sur disponibilité synthétique |
| Nobl9, Sloth, Pyrra | oui (méthode par défaut) | Nobl9 : oui ; Sloth et Pyrra : orientés événements |
Attention : Les libellés et options évoluent : vérifiez la documentation de votre outil, en particulier la façon dont il traite les tranches sans trafic (bonnes, mauvaises ou ignorées).
6. L'exemple de Qonto #
Une page de statut exprimée par parcours client.
Ce que montre la page de statut #
La néobanque Qonto est passée à une approche par événements pour exprimer sa fiabilité. Sa page de statut publique (status.qonto.com) affiche une disponibilité par composant, sur une fenêtre de 90 jours, avec quatre décimales. Les composants correspondent à des parcours clients plutôt qu'à des serveurs :
| Composant | Disponibilité affichée (90 jours, relevé de novembre 2026) | Lecture en événements | Lecture en temps (équivalent) |
|---|---|---|---|
| Authentification | 99,9969 % | ≈ 3 échecs sur 100 000 connexions | ≈ 4 min sur 90 jours |
| Transactions | 99,9713 % | ≈ 29 échecs sur 100 000 opérations | ≈ 37 min sur 90 jours |
| Paiements par carte | 99,9992 % | ≈ 8 échecs sur 1 million de paiements | ≈ 1 min sur 90 jours |
| Virements | 99,9969 % | ≈ 3 échecs sur 100 000 virements | ≈ 4 min sur 90 jours |
Les chiffres sont glissants et changent chaque jour ; la colonne « lecture en temps » montre seulement ce que signifierait le même pourcentage s'il était exprimé en minutes.
Pourquoi ce choix est pertinent pour une banque #
- Chaque événement est un client : un paiement par carte refusé à tort se voit en caisse, quelle que soit l'heure. Compter les paiements ratés traduit directement l'impact client.
- Les dégradations partielles comptent : 1 % de virements en échec pendant une matinée n'est pas une « panne » au sens de l'uptime, mais c'est un incident pour les clients concernés (incident B de la section 4).
- Le volume le permet : avec des millions d'opérations, le ratio est stable et précis, d'où l'intérêt de quatre décimales.
- Parcours plutôt que composants techniques : le client voit « Paiements par carte », pas « cluster Kafka » ; chaque parcours a son propre SLO et son propre budget.
- Une fenêtre de 90 jours lisse les variations sans masquer les tendances, et correspond à un horizon trimestriel de pilotage.
Ce qu'on peut en retenir pour sa propre page de statut #
- Découper par parcours client (se connecter, payer, virer), chacun avec son SLI d'événements.
- Mesurer au plus près de l'utilisateur (répartiteur, passerelle, client) pour compter aussi les requêtes qui n'atteignent jamais le service.
- Afficher une fenêtre glissante et une précision cohérente avec le volume.
- Expliquer publiquement la méthode (ce qu'est un événement « bon ») : la transparence renforce la confiance.
- Garder les états UP, DEGRADED, DOWN et MAINTENANCE pour l'instant présent, et le pourcentage pour l'historique.
À savoir : Qonto ne publie pas sur cette page le détail de son calcul (définition d'un événement réussi, point de mesure) : les lectures « ≈ N échecs » ci-dessus sont une conversion arithmétique du pourcentage affiché, pas des chiffres communiqués par Qonto.
7. Choisir, ou combiner #
Selon le trafic, le contrat et la question posée.
Grille de choix #
| Situation | Méthode conseillée | Pourquoi |
|---|---|---|
| API ou parcours à fort trafic (paiements, recherche, connexion) | événements | reflète la part de clients touchés, capte les dégradations partielles |
| Service à faible trafic (back-office, API B2B peu sollicitée) | temps (avec sondes synthétiques) | évite qu'une seule erreur fasse chuter le SLI |
| SLA contractuel en minutes | temps pour le SLA, événements pour le pilotage interne | le contrat impose l'unité |
| Traitements par lots, tâches planifiées | événements (exécutions réussies à l'heure) | chaque exécution est un événement |
| Trafic très irrégulier (pics saisonniers) | événements, complétés par des sondes | les pics comptent davantage, les creux restent surveillés |
Combiner les deux #
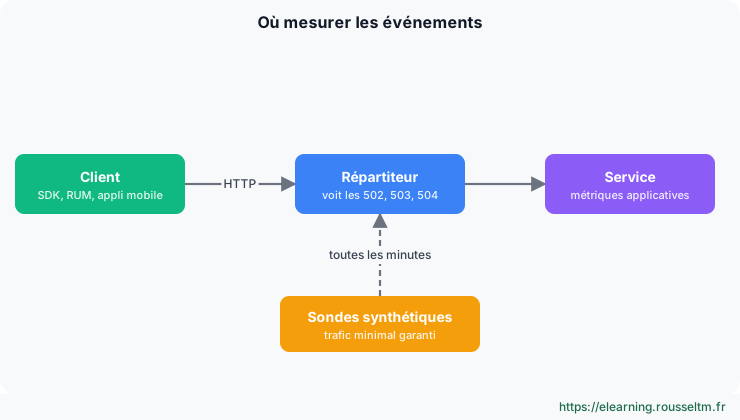
- Événements + sondes : les sondes synthétiques garantissent un trafic minimal, si bien qu'une panne totale la nuit consomme quand même du budget.
- Seuil de trafic minimal : ne compter une fenêtre que si elle contient assez d'événements, ou agréger sur une fenêtre plus longue.
- SLO multiples : un SLO d'événements pour la qualité perçue et un SLO de temps pour la disponibilité contractuelle, présentés côte à côte.
8. Pièges courants #
Ce qui fausse un SLO, quelle que soit la méthode.
Les pièges #
| Piège | Effet | Remède |
|---|---|---|
| Mesurer uniquement côté serveur | une panne du répartiteur ou du DNS n'est pas comptée (zéro événement) | mesurer au répartiteur ou au client, ajouter des sondes |
| Compter les tentatives répétées | une requête utilisateur devient trois événements | compter l'opération métier, pas l'appel HTTP |
| Compter les 4xx comme des erreurs | les erreurs des clients consomment votre budget | exclure les 4xx, sauf 429 et 408 si ce sont vos limites |
| Seuil de tranche mal choisi | dégradations invisibles ou alertes excessives | fonder le seuil sur l'historique, le revoir |
| Maintenances exclues sans règle | SLO flatteur, perte de confiance | règle écrite et publique pour les exclusions |
| SLO global unique | un gros client en panne disparaît dans la moyenne | SLO par parcours, voire par segment de clients |
Bonne Pratique : Écrivez la définition du SLI comme un contrat : ce qu'est un événement, ce qui le rend bon, où on le mesure, ce qu'on exclut. C'est ce document, plus que l'outil, qui rend le SLO crédible.
9. À retenir #
Synthèse, commandes et sources.
Synthèse #
| SLO basé sur le temps | SLO basé sur les événements | |
|---|---|---|
| On compte | des tranches de temps bonnes | des événements bons |
| Budget exprimé en | minutes | événements ratés |
| Question posée | combien de temps le service était-il utilisable ? | quelle part des utilisateurs a été bien servie ? |
| Idéal pour | faible trafic, SLA contractuels | fort trafic, expérience client, pilotage |
| Angle mort | dégradations partielles, poids du trafic | faible trafic, requêtes jamais reçues |
Commandes à connaître #
Commandes à connaître
sum(rate(http_requests_total{code!~"5.."}[5m])) / sum(rate(http_requests_total[5m])): SLI à base d'événements (PromQL)avg_over_time((… < bool 0.05)[30d:1m]): SLI à base de tranches de temps (PromQL)(1 - sli:ratio_rate1h) > 14.4 * 0.001: alerte de burn rate rapidebudgetingMethod: Occurrences | Timeslices: choisir la méthode dans OpenSLOsloth generate -i slo.yaml: générer règles et alertes Prometheus
Sources #
- Google SRE Workbook : Implementing SLOs
- Google SRE Workbook : Alerting on SLOs (burn rate)
- Spécification OpenSLO (Occurrences, Timeslices)
- Datadog : types de SLO
- Page de statut de Qonto
Relevé de la page de statut de Qonto effectué en novembre 2026 ; les pourcentages évoluent chaque jour.


